



Mettre l'IA à l'échelle pour de vrais gains métier : stratégies éprouvées pour le succès opérationnel
L'intelligence artificielle (IA) alimente une nouvelle normale pour les entreprises à travers les industries. Les détaillants peuvent, par exemple, utiliser l'IA pour prédire les commandes d'achat sur des données d'inventaire historiques pour piloter des décisions de réapprovisionnement intelligentes. Les équipes de support client peuvent utiliser l'IA pour répondre automatiquement aux tickets de support client à haute priorité et les router vers les bonnes équipes. Il y a un monde de possibilités où vous pouvez utiliser l'IA, et spécifiquement le ML, pour générer des résultats métier pratiques.
Selon Deloitte Insights, 83 % des premiers adoptants de l'IA en entreprise ont vu un retour sur investissement (ROI) positif sur des projets en production. Cela incluait des exemples comme l'implémentation de logiciels d'entreprise tiers utilisant l'IA, l'utilisation de chatbots et assistants virtuels, et des moteurs de recommandation pour les plateformes e-commerce. Quatre-vingt-trois pour cent des entreprises interrogées prévoyaient d'augmenter leurs dépenses en IA en 2019. Parmi les entreprises investissant dans l'IA, 63 % avaient adopté le ML.
Construire une stratégie pour utiliser pragmatiquement l'IA et le ML pour atteindre des objectifs métier est une priorité absolue pour de nombreuses entreprises. Pour beaucoup, le principal défi pour opérationnaliser le ML avec succès est de comprendre, planifier et exécuter la gestion d'un déploiement ML holistique à travers l'organisation.
Principales considérations pour opérationnaliser le ML
La « bonne » façon d'aborder le cycle de vie de la data science diffère d'une organisation à l'autre. De nombreuses tentatives ont été faites pour codifier et standardiser les procédures du cycle de vie de la data science. Cependant, aucune approche ne prend en compte les besoins de chaque entreprise.
Adopter une stratégie durable et maintenable pour les données et la data science est un exercice en constante évolution, distinct pour chaque entreprise. Parce que les besoins, la structure et les capacités de chaque entreprise sont uniques, les parties prenantes de toute l'entreprise doivent être consultées pour construire un modèle ML flexible et évolutif et exécuter une stratégie de data science holistique.
Les défis opérationnels et les changements d'infrastructure et de pratiques de développement que chaque entreprise doit aborder différeront.
Il est crucial que votre organisation prenne en compte sa culture, ses systèmes et ses besoins tout en définissant et faisant évoluer le cycle de vie de la data science. Avoir un framework de base à présenter à travers les équipes aide à développer une base commune pour la communication pendant que vous continuez à développer et faire évoluer votre opérationnalisation du ML.
Parcourons un framework standard qui peut aider votre organisation à démarrer son parcours ML.
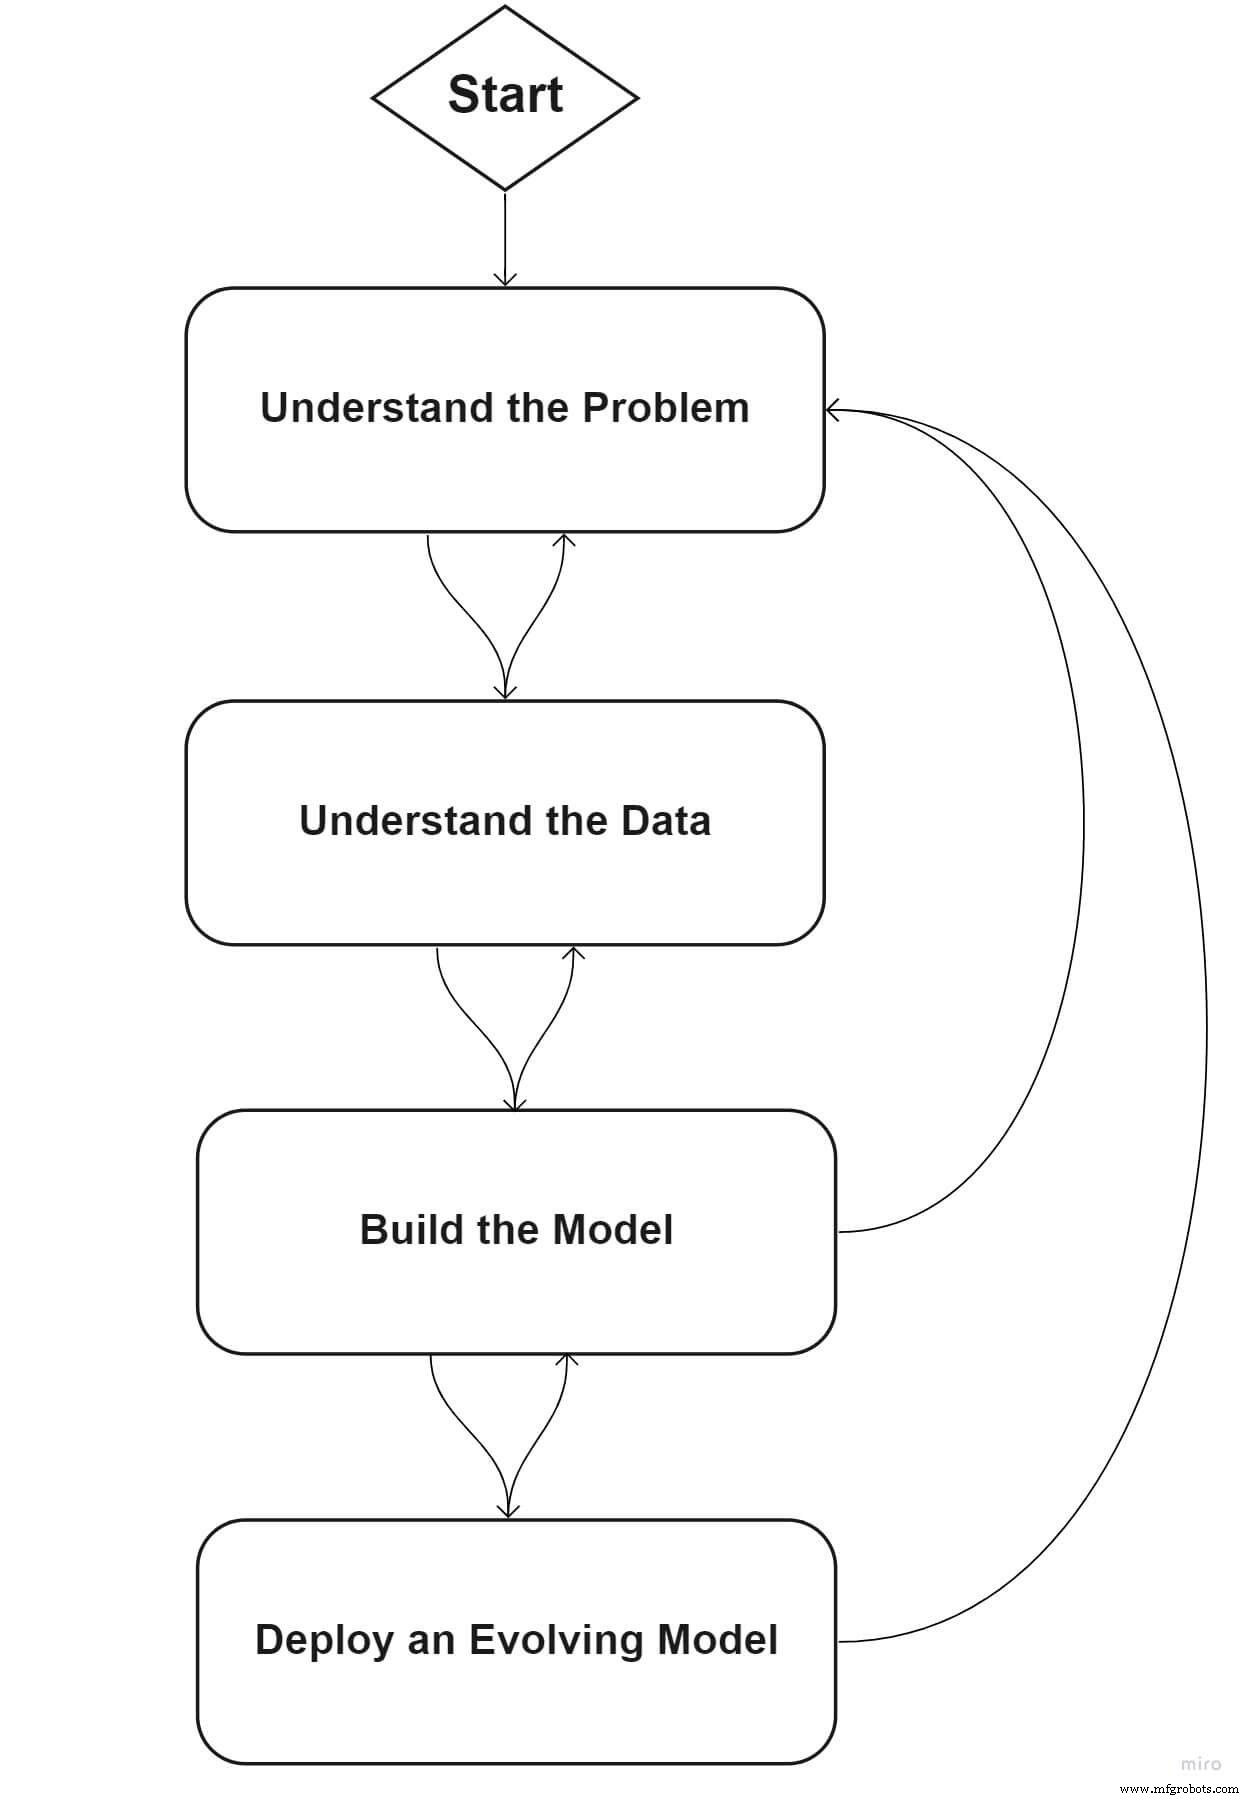
Phase 1 : Définir votre problème
Au cœur de toute initiative ML se trouvent deux questions :
1. Quel problème essayez-vous de résoudre ?
2. Pourquoi croyez-vous que le ML et une meilleure compréhension de vos données peuvent vous aider à résoudre le problème en question ?
Les réponses à ces questions dépendent de la façon dont votre entreprise pense la stratégie et évalue les problèmes métier.
Pendant la phase 1, les parties prenantes clés devraient se réunir pour définir la portée initiale du problème et ses exigences.
Phase 2 : Comprendre vos données
Quelle est l'histoire de vos données ? D'où viennent vos données, et combien de sources de données sont pertinentes pour vous aider à résoudre votre problème métier spécifique ?
Pendant cette phase, les entreprises se concentrent sur :
Cartographier les sources de données pertinentes et les environnements dans lesquels elles vivent (de tels environnements peuvent être sur site ou dans le cloud, configurés comme entrepôt de données, lac de données ou plateformes de données en streaming)
Définir quels pipelines de données existent actuellement, et quels pipelines de données doivent être construits pour la validation, le nettoyage et l'exploration des données
Comprendre à quelle fréquence les données sont mises à jour
Comprendre la fiabilité des données
Évaluer les considérations et exigences de confidentialité des données
Permettre l'exploration des données par des visualisations, propriétés statistiques des données brutes et transformées, etc.
Comprendre vos données n'est pas une mince affaire. Il est important d'aborder cette phase de manière itérative. Au fur et à mesure que vous découvrez plus sur vos données, vous pouvez découvrir des problèmes impactant votre capacité à résoudre le problème, ce qui peut exiger de redéfinir ou redéfinir la portée du problème de la phase 1.
Phase 3 : Construire le modèle ML
Une fois que vous avez les données prêtes, il est temps pour vos data scientists de construire un modèle ML. Les étapes courantes pour construire un modèle ML robuste incluent :
Extraire et concevoir les caractéristiques (inclut le binning, le blanchiment des données, et l'application de transformations statistiques)
Sélectionner les caractéristiques
Entraîner le modèle (inclut la division des données en un nombre quelconque d'ensembles d'entraînement, de validation croisée et de validation)
Ajuster les hyperparamètres
Évaluer le modèle
Valider la significativité statistique
Le développement d'un modèle nécessite un retour continu des parties prenantes métier. Par exemple, le problème métier peut appeler une affinité pour la sensibilité vis-à-vis de la spécificité. Vous pouvez de même faire un compromis sur une légère performance prédictive (ex: score F1) pour une performance opérationnelle du modèle (ex: prédictions plus rapides), ou l'explicabilité du modèle.
L'objectif du data scientist est de construire un modèle qui utilise les données pour raconter une histoire claire liée au problème métier. Au fur et à mesure que le problème évolue et que les exigences changent, l'approche de modélisation doit aussi évoluer pour servir le contexte actuel.
Phase 4 : Déployer un modèle évolutif
Construire le modèle initial n'est que le début du parcours ML. Déployer un modèle évolutif est une étape cruciale pour la création de valeur à long terme pour l'organisation.
Déployer un modèle évolutif nécessite :
Servir le modèle (rendre le modèle hautement disponible et horizontalement évolutif)
Gérer les versions du modèle (incluant les rollbacks et déploiements canary/challenger)
Réentraîner le modèle (modifier ou construire un nouveau modèle au fur et à mesure que de nouvelles données entrent dans le système)
Surveiller le modèle (suivre à la fois les métriques opérationnelles et d'expérience utilisateur aux moments de service et d'entraînement)
Surveiller la dérive des données et du modèle, nécessitant une spécialisation du modèle pour des cas d'usage intra-organisation ciblés, et maintenir les pipelines de données (entre autres éléments de maintenance) sont critiques pour le succès continu d'un modèle.
Les exigences à l'échelle de l'entreprise et de l'industrie peuvent évoluer rapidement et impacter les sources et entrées de données. Par exemple, la gouvernance et la conformité à grande échelle sont des considérations couvrant tout le cycle de vie de la data science.
La conformité avec les réglementations — comme le Règlement Général sur la Protection des Données (RGPD) de l'Union Européenne (UE) — exige un niveau plus profond de traçabilité au niveau de la version des données, de la version du modèle et des couches d'entrée du modèle. Construire une stratégie pour répondre à ces changements et exigences de l'industrie par les données peut aider les entreprises à continuer de tirer parti du ML pour générer de meilleurs résultats métier tels que la croissance des revenus, la réduction des coûts et la diminution des risques.
Quelle est la suite ?
Opérationnaliser le ML de manière flexible, maintenable et évolutive nécessite de nombreuses étapes et considérations au-delà du cadre de haut niveau que nous avons décrit dans ce blog. Le diable est dans les détails.
Dans notre prochain blog, nous plongerons plus profondément dans les considérations techniques, les défis qui peuvent survenir d'une implémentation ad-hoc d'un système ML à grande échelle, et comment UiPath aide à relever les défis courants pour les clients entreprise.
Système de contrôle d'automatisation
- Bosch dévoile une solution de fabrication pilotée par l'IA au salon Hannover Messe
- Intelligence artificielle dans le retail : Bénéfices prouvés, pas un effet de mode
- Comment l'IA accélère la révolution de l'Internet des objets
- Comment l'IA amplifie la puissance de l'Internet des objets
- Maîtriser la Business Intelligence : élaborer une stratégie gagnante pour le succès data-driven
- Automatisation des tests pilotée par l'IA : Révolutionner l'assurance qualité pour les systèmes ERP modernes
- IAoT industriel : fusion de l'IA et de l'IoT pour piloter l'innovation Industrie 4.0
- Robotique pilotée par l'IA : Machines intelligentes de pointe
- IA : avantages, risques et impact industriel