



FRACAS : Transformer les pannes d'équipement en victoires business
En maintenance, la panne est généralement vue comme un résultat négatif, et les équipes ressentent souvent la pression des métriques de temps d'arrêt. Pourtant, cet état d'esprit peut être contre-productif et injuste. De nombreux facteurs — comme l'âge de l'actif, les limitations de conception, ou l'erreur utilisateur — échappent au contrôle immédiat. Vu stratégiquement, la panne devient une source précieuse d'insights.
« Vous avez besoin de pannes pour vous améliorer », dit Thibaut Drevet, ingénieur solutions chez Fiix et ancien ingénieur industriel et maintenance. « La panne vous aide à comprendre les systèmes que vous maintenez, comment ils opèrent, et comment vous pouvez les maintenir. »
Cet article explique comment un FRACAS — Système de Signalement, d'Analyse et d'Action Corrective des Défaillances — peut transformer chaque arrêt en opportunité d'apprentissage qui génère des résultats business.
Qu'est-ce que le FRACAS ?
Le FRACAS est un cadre de reporting en boucle fermée qui capture, interprète et élimine les défaillances d'équipement à travers trois étapes clés :
- Signalement de la panne — identification de l'actif exact et de l'événement de défaillance.
- Analyse de la panne — extraction des leçons de l'incident.
- Correction de la panne — implémentation de changements prévenant la récurrence.
En agrégeant les données de performance dans le temps, le FRACAS identifie les patterns de défaillance récurrents et informe toute la stratégie de fiabilité — de la conception au planning de maintenance.
Construire un FRACAS : La boucle continue
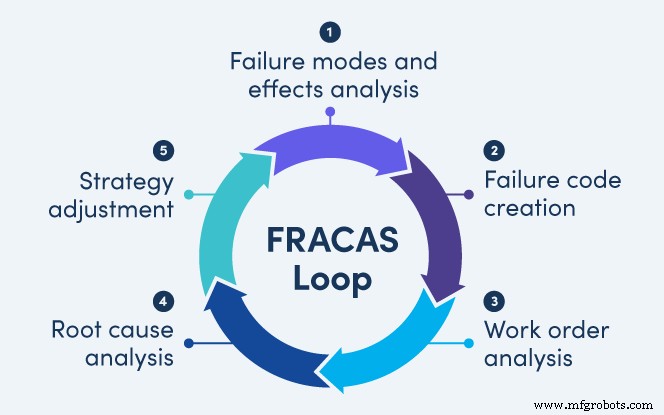
La boucle FRACAS est un ensemble d'activités répétables qui maintient l'apprentissage et l'amélioration :
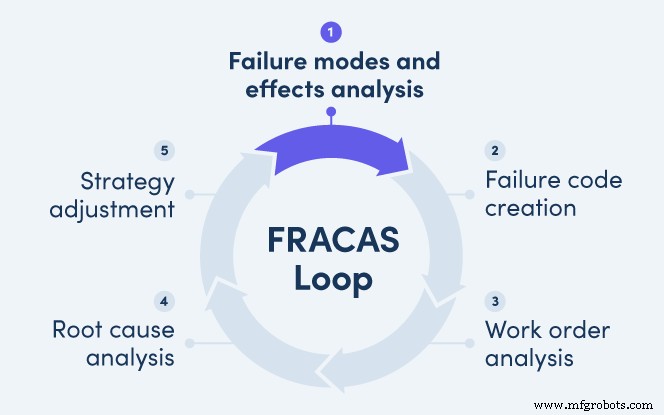
- Analyse des Modes de Défaillance, de leurs Effets et de leur Criticité (AMDEC)
- Création de codes de défaillance
- Analyse des ordres de travail
- Analyse des causes racines (ACR)
- Ajustement de la stratégie
Analyse des Modes de Défaillance, de leurs Effets et de leur Criticité (AMDEC)
L'AMDEC est un outil préventif qui liste chaque mode de défaillance concevable, son impact, et les étapes d'atténuation. Une AMDEC typique contient dix éléments clés :
- Composant de l'actif
- Modes de défaillance potentiels
- Effets de défaillance potentiels
- Gravité de la défaillance
- Causes potentielles
- Fréquence attendue de défaillance
- Processus actuels de détection et prévention
- Détectabilité
- Risque global
- Action recommandée
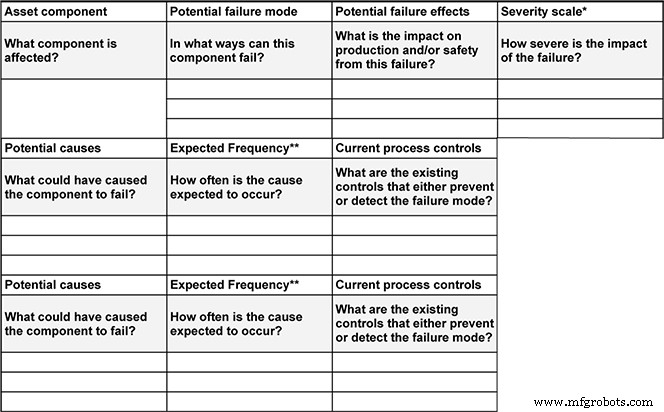
Téléchargez votre propre template AMDEC ici
L'AMDEC est la fondation du FRACAS. Elle priorise l'action basée sur la criticité de l'actif, l'impact, et les ressources disponibles, et évolue avec l'émergence de nouvelles données.
Création de codes de défaillance
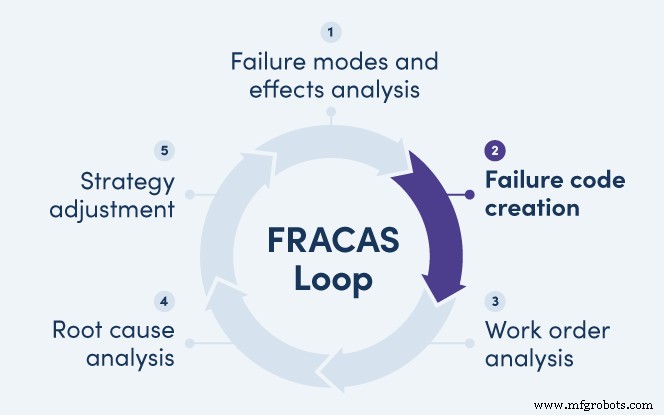
Les codes de défaillance distillent des incidents complexes en identifiants concis — ex: « Roulement, usure, manque de lubrification ».
- Utilisez une convention de nommage claire pour chaque pièce pour éviter la confusion.
- Groupez les défauts par condition (usure, surchauffe, etc.) pour la clarté.
- Limitez les codes préchargés aux plus courants — plus de dix peut diluer le focus.
- Validez la liste de codes avec les techniciens pour assurer la pertinence.
Le suivi des codes fait émerger les tendances, vous permettant de cibler les défaillances les plus coûteuses en premier.
Analyse des ordres de travail
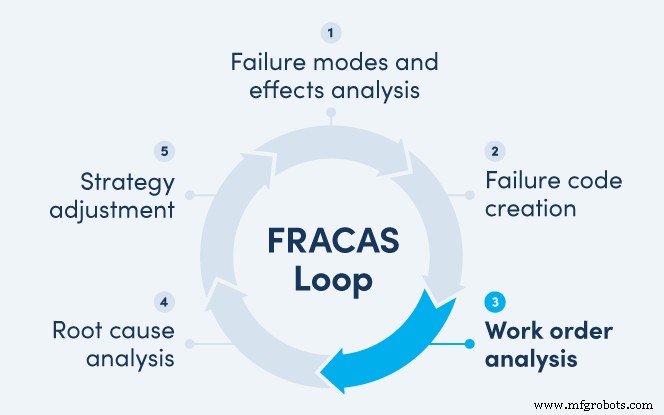
Les incidents isolés sont une nuisance ; les patterns répétés indiquent des problèmes systémiques. En revoyant les codes de défaillance et notes de clôture, vous pouvez repérer les problèmes à haute fréquence.
Exemple : Quatre machines ont loggé 12 pannes en six mois, dont 10 attribuées à un grippage de roulement par désalignement. Réduire ce compte à deux dans les six mois suivants signale que les actions correctives fonctionnent.
Des méthodes d'analyse supplémentaires sont couvertes dans notre guide des données d'ordres de travail.
Analyse des causes racines (ACR)
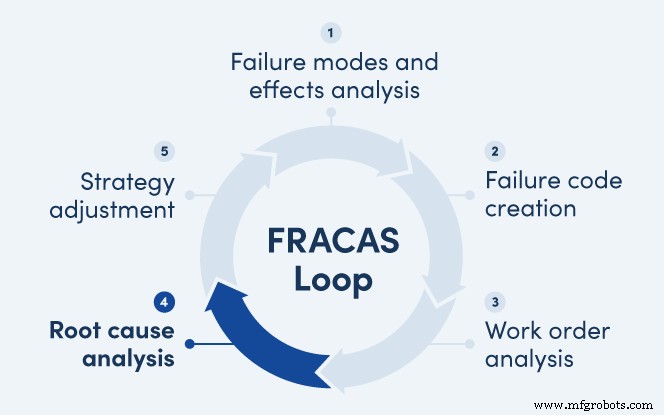
L'ACR extrait la valeur long terme du dépannage. Une réparation simple qui se répète gaspille temps, argent et pièces.
Avec l'exemple du roulement désaligné, une ACR « 5 pourquoi » pourrait révéler :
- Pourquoi ? Le roulement était désaligné car l'arbre l'était.
- Pourquoi ? La machine a été assemblée incorrectement.
- Pourquoi ? Le technicien a précipité l'assemblage.
- Pourquoi ? Le technicien manquait de temps suffisant.
- Pourquoi ? La fenêtre de maintenance avant production était trop étroite.
Thibaut conseille d'assembler des équipes diverses pour l'ACR afin d'éviter les conclusions prématurées.
Ajustement de la stratégie
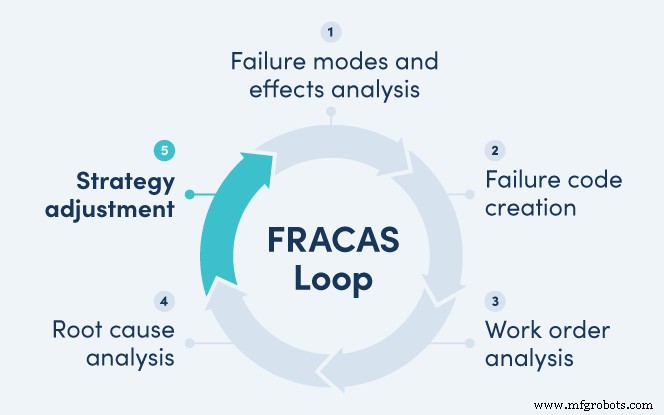
Les insights doivent se traduire en actions. Les ajustements peuvent être mineurs — ajouter des instructions de lubrification — ou majeurs, comme embaucher des spécialistes pour des tâches au-delà de l'expertise de l'équipe.
- Impliquez les techniciens : Partagez la raison d'être et les bénéfices attendus. Célébrez les victoires, comme une baisse de 40 % des appels hors heures.
- Surveillez les résultats : Détectez les effets secondaires non intentionnels tôt et itérez jusqu'au succès.
- Déployez graduellement : Testez les changements sur une machine avant de généraliser à l'usine.
Boucler la boucle
Après implémentation des changements, revisitez le cycle FRACAS :
- Mettez à jour l'AMDEC avec les nouvelles défaillances et atténuations.
- Audit des codes de défaillance — ajoutez, supprimez, ou affinez si nécessaire.
- Générez des rapports d'impact : Suivez les réductions de fréquence de défaillance, économies de coûts, et améliorations de planning.
Assurer des données de haute qualité pour le FRACAS
Des données fiables sont le sang vital du FRACAS. Voici comment les sécuriser.
Créer une culture de valeur maintenance
Les inexactitudes de données viennent souvent de techniciens pressés. Une culture qui reconnaît la maintenance comme facilitateur de production encourage une saisie de données soignée.
« La maintenance n'est pas l'ennemie de la production », dit Thibaut. « Quand tous en voient la valeur, les techniciens prennent le temps de logger des infos précises. »
Concevoir des ordres de travail clairs et simples
Des ordres de travail ambigus ou denses génèrent des erreurs. Simplifiez en incluant :
- Photos et schémas pour l'identification des composants.
- Conventions de nommage claires.
- Un flux de reporting concis.
Ressources de départ :
- Maîtriser les fondamentaux : Ordres de travail maintenance
- Concevoir des ordres de travail pour écraser vos objectifs
- Template ordre de travail maintenance
- Template journal maintenance équipement
- Checklist maintenance préventive
Automatiser et intégrer
Les logiciels de surveillance d'état remplacent les relevés manuels par des données temps réel, éliminant le risque d'enregistrer une valeur décalée.
L'intégration de ces données dans votre plateforme maintenance permet des alertes instantanées et une analyse consolidée.
Audits de données réguliers
Des vérifications ponctuelles mensuelles et interviews techniciens révèlent les lacunes systémiques de données. Demandez :
- Une tâche d'inspection est-elle inutile ? Si oui, supprimez ou justifiez-la.
- Les techniciens savent-ils quoi logger et pourquoi ?
- Le processus de saisie de données est-il convivial ?
Cinq rapports FRACAS qui génèrent des résultats
Utilisez ces rapports pour identifier les pannes qui freinent la production et la rentabilité.
- Pannes après démarrage — Identifier les problèmes qui stoppent la production avant qu'elle ne commence.
- Coûts maintenance par code de défaillance — Additionner main-d'œuvre et pièces pour prioriser les pannes à fort impact.
- Heures maintenance par code de défaillance — Identifier les réparations récurrentes chronophages.
- Pannes en maintenance planifiée vs non planifiée — Mettre en lumière les drivers de maintenance réactive.
- Pannes par poste ou site — Repérer les gaps de processus ou formation réplicables ailleurs.
Success stories FRACAS réelles
Le FRACAS peut aller au-delà du document pour devenir un changement culturel. Exemples :
- L'identification de pannes fréquentes liées à de vieilles pièces a révélé un coût caché, permettant un budget inventaire plus fort.
- La détection d'un nouveau pattern de panne après un changement de ligne a mené à un processus de communication révisé qui a réduit les temps d'arrêt sur plusieurs sites.
- La priorisation d'une seule panne à fort impact sur le trimestre a sécurisé le financement pour étendre l'équipe techniciens, résolvant des problèmes additionnels.
Conclusion
Construire un FRACAS demande des données, du temps, et un engagement soutenu. Commencez petit, célébrez les premiers gains, et persévérez. Le ROI long terme — temps d'arrêt réduits, coûts maintenance plus bas, et opérations plus résilientes — justifiera l'effort.
Entretien et réparation d'équipement
- Évaluer les solutions CMMS : 5 fonctionnalités essentielles au-delà du coût
- Développer un programme de maintenance électrique robuste : Guide pratique
- Concevoir un plan de maintenance efficace : composants clés et meilleures pratiques
- Azima DLI lance les programmes WATCHMAN groupés pour des opérations d'usine fiables
- Problèmes des groupes électrogènes industriels : Identifier et résoudre les pannes les plus courantes
- Sécurité des échelles : pourquoi des outils simples nécessitent des inspections rigoureuses
- Pièces de rechange NETZSCH : 7 conseils d'experts pour économiser et gagner en efficacité en 2025
- Principaux défis lubrification industrielle et comment les surmonter
- Calculer le ROI d'une GMAO : guide pratique pour mesurer la valeur du logiciel maintenance