



Découvrez comment notre usinage prédictif améliore la fiabilité : cas d'usage réels
Publié à l'origine sur Towards Data Science
Au cours des derniers mois, nous avons surveillé et découvert discrètement de nouveaux cas d'usage pour notre produit d'usinage prédictif. Grâce à une interface opérateur rationalisée, qui double commodément comme une plateforme de collecte de données étiquetées « en coulisses », nous avons vu des centaines de pannes d'outil, pannes de roulement, et autres scénarios de panne machine jusqu'à présent.
En concert avec nos clients, nous avons dressé un large catalogue de ce à quoi ressemblent les pannes machine typiques d'une perspective de données moteur, qu'on est ravis de partager avec vous aujourd'hui. Nous passerons en revue six scénarios qu'on a vus répétés sur plusieurs sites clients, et à quoi ils ressemblent tant d'une perspective « points sur un graphique » que de leur manifestation physique en atelier. Ce sont :
- Pannes de fraise en bout menant à mauvaise finition et pièces rebutées
- Pannes de roulement à billes menant à logement de broche endommagé
- Pannes d'outil d'ébauche, menant à pannes en cascade sur outils de finition
- Décalage incorrect, menant à désalignement de la bague de guidage
- Panne d'outil, menant à coupe incomplète
- Estimation incorrecte de la durée de vie d'outil, menant à surutilisation ou sous-utilisation d'outils
Avant d'arriver au cœur du sujet, passons en revue notre thèse pour notre offre d'usinage prédictif :
Nous extrayons des données riches de capteurs embarqués sur la machine pour prédire et prévenir différents scénarios qui pourraient coûter cher.
- Données riches : taux d'échantillonnage 1 milliseconde → 170 millions d'observations par jour par moteur, précision à .001 RPM pour vitesse de broche, .01% nominal continu pour puissance/charge
- Capteurs embarqués : Aucun capteur additionnel nécessaire, car les données sont nécessairement disponibles sur toutes les machines CNC modernes. On ne tire que les données que la machine utilise pour faire tourner sa boucle de rétroaction de contrôle interne. Tous les scénarios démontrés ont été déployés pendant la pandémie COVID-19 sans que le personnel MachineMetrics ne mette jamais les pieds en usine
- Prédire et prévenir des scénarios coûteux : Les situations décrites coûtent de l'argent à nos clients, et les prévenir leur en fait économiser. On monétise ça en prenant une fraction des économies
Pannes de fraise en bout
Pour réviser, à chaque machine MachineMetrics, on a une tablette opérateur, qui est basically juste une tablette Samsung Galaxy ou iPad pointée vers la page web de la machine particulière dans notre produit SaaS.
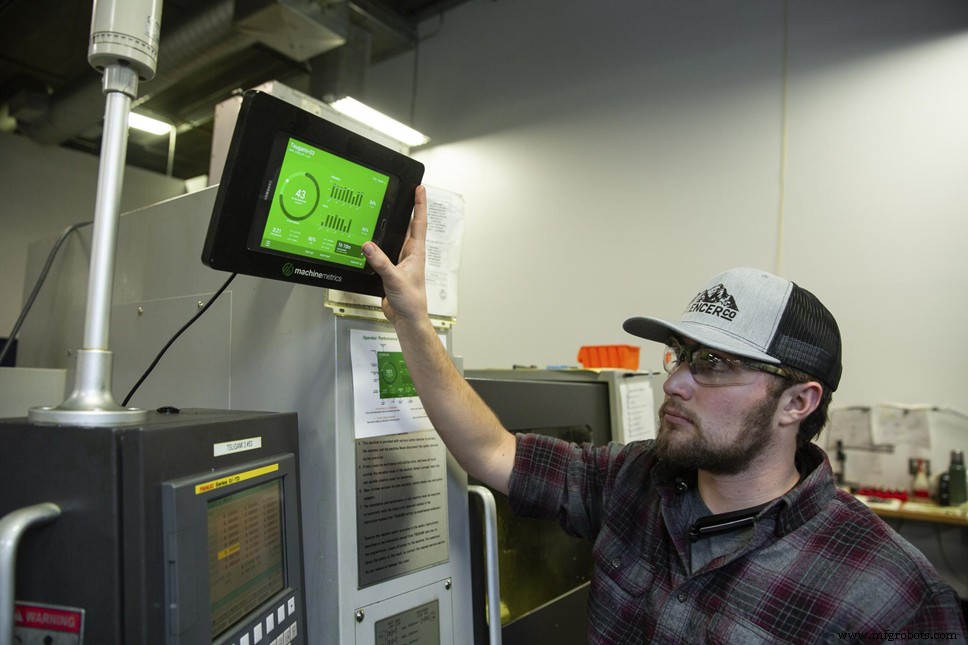
Un client utilisant notre tablette opérateur.
La tablette opérateur est directement connectée à notre plateforme, donc chaque fois que la machine s'arrête, un signal est envoyé de la machine à notre dispositif Edge, qui est ensuite envoyé au cloud où il est agrégé et mis en tableau de bord avec d'autres métriques. La tablette reflète alors cette nouvelle information et émet une popup sur la page web de la machine invitant l'opérateur à expliquer pourquoi la machine s'est arrêtée.
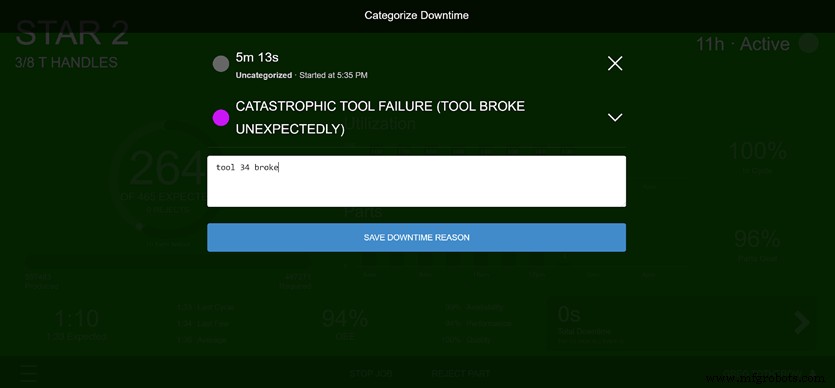
Quand une machine s'arrête, une popup apparaît demandant à l'opérateur d'ajouter un code de raison.
Au fil du temps, ces annotations s'accumulent, nous permettant une vue riche et détaillée de quand et pour quelle raison une machine est tombée en panne.
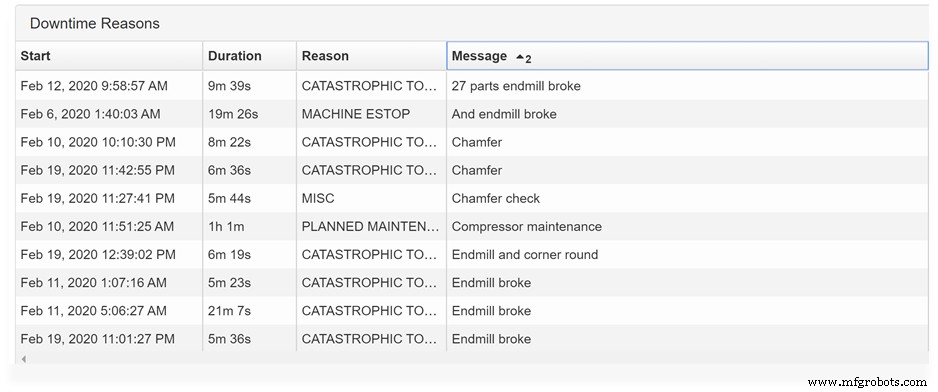
C'est au Data Science de MachineMetrics de trouver le pourquoi et comment de la panne machine, en utilisant les données extrêmement fines qu'on collecte des moteurs de la machine. Dans une incarnation de ceci, on peut regarder par-dessus des dizaines de milliers de pièces faites et des douzaines d'annotations pour identifier des patterns, comme dans l'exemple ci-dessous, où les lignes noires sont les pannes annotées et les points sont la puissance consommée par chaque pièce faite.
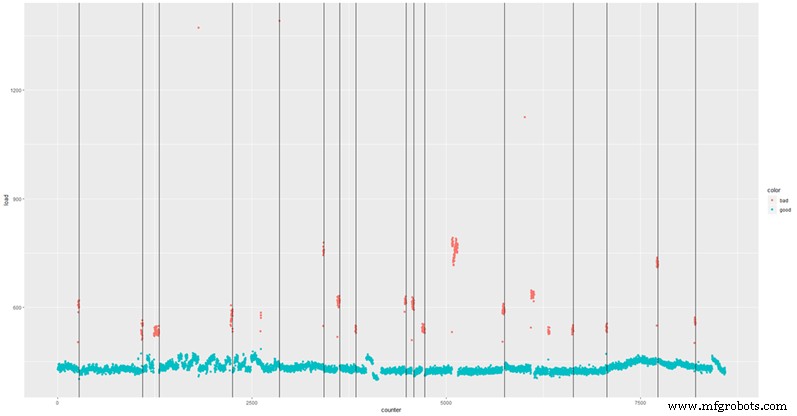
Lignes noires = pannes annotées, points rouges = charge anormale. Certains points rouges ne s'alignent pas avec les lignes noires, car les annotations sont parfois manquées par les opérateurs.
Au fil du temps, des patterns émergent pour chaque type de panne. Les lignes noires dans le graphique ci-dessus représentent toutes des moments de pannes de fraise en bout, où une fraise en bout particulière casse et ne peut pas faire le travail requis pour finir la pièce. L'outil qui arrive après la fraise en bout doit alors dépenser de l'énergie additionnelle pour faire sa coupe, causant la signature de charge élevée en rouge qu'on voit dans le graphique. Cela se répète encore et encore, nous permettant de créer un algorithme de seuillage simple pour arrêter la machine net dès qu'on voit la première signature de charge élevée.
Dans sa manifestation physique, vous pouvez voir qu'une bonne pièce, coupée par une bonne fraise en bout, a une finition belle et brillante dans la rainure. Une mauvaise pièce, coupée par une fraise en bout cassée, a une rainure rugueuse car la fraise en bout n'a pas pu créer une finition lisse, et l'outil qui est venu après n'a pas pu faire son travail correctement non plus.
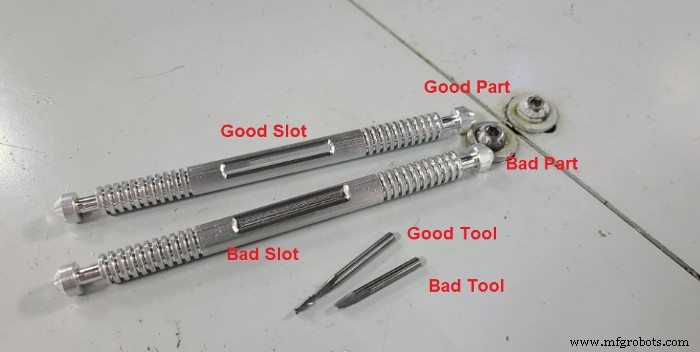
Et dans notre produit, on surveille maintenant les charges sur cette machine pour émettre un feed-hold avant qu'aucune de ces Mauvaises Pièces de Rainure ne soient faites. Sur les 4 derniers mois, on a émis 60 feed holds sur plusieurs machines, avec 3 faux positifs et 2 pannes manquées (95% précision, 96% rappel), prévenant plus de 2 000 pièces rebutées d'être faites et sauvant d'innombrables heures-hommes de reconfiguration machine. Oh, et juste pour être sûr, ce sont de petites pièces, faites par de petits outils — la taille n'est pas vraiment une contrainte pour nous quand on tire des données moteur très sensibles. Toutes les pièces sortant de ces machines sont maintenant brillantes et neuves, sans les défauts qu'elles portaient autrefois.
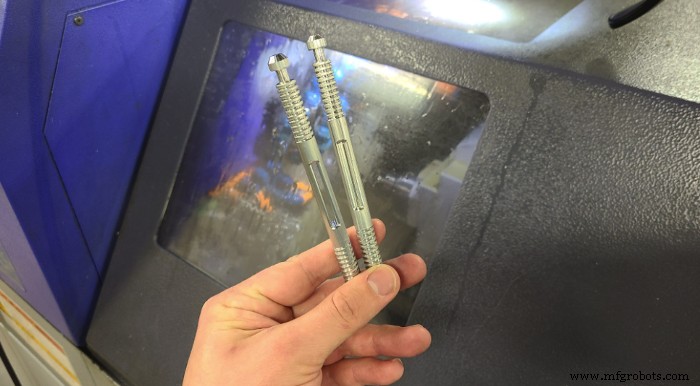
Plutôt sympa, hein ? C'est juste un des nombreux cas d'usage. Vous pensiez pas qu'on était un poney à un tour, si ?
Pannes de roulement à billes
Similaires aux pannes de fraise en bout, les pannes de roulement peuvent coûter cher tant en matériaux qu'en main-d'œuvre.
Dissemblables aux pannes de fraise en bout, les pannes de roulement ont l'air complètement différentes en termes de patterns qu'il faut chercher.
Similaires aux pannes de fraise en bout, les pannes de roulement utilisent le même type de données moteur riches et méthodologie de collecte.
Dissemblables aux pannes de fraise en bout, les pannes de roulement se manifestent sur de longues périodes (jours à semaines) et peuvent être prévenues bien à l'avance.
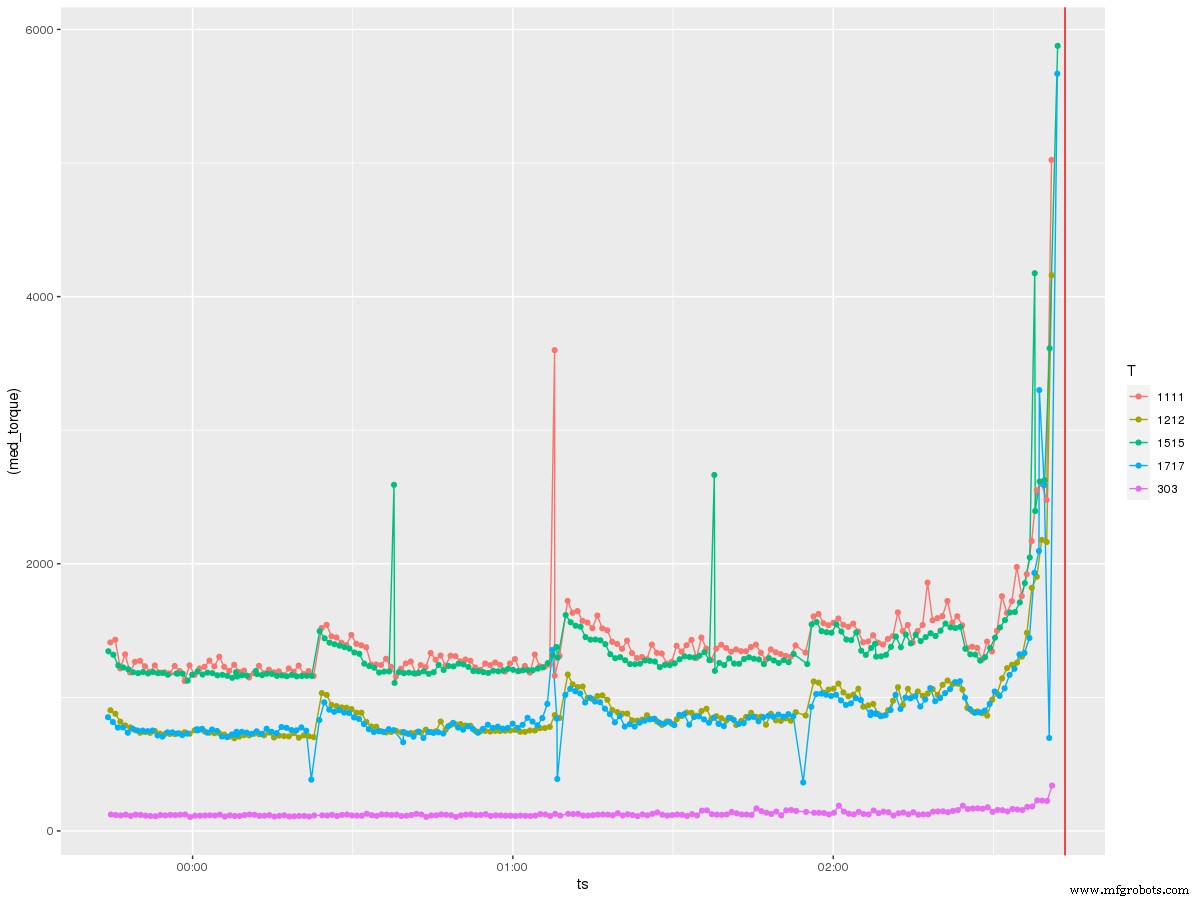
Investiguons d'abord ce que la charge sur la machine fait moments avant une panne de roulement, dans un instantané de données 2 heures avant la panne.
[Voir image taille réelle]
Chacune de ces lignes est la charge sur un outil particulier. Il ne faut pas être scientifique de fusée pour comprendre ce qui se passe ici. La charge explose ~15 minutes avant la panne de roulement réelle sur chaque outil, probablement dû au fait que la machine subit une contrainte additionnelle d'un composant clé de plus en plus compromis.
Si on regarde la progression pièce-par-pièce dans les 15 minutes avant la panne, un autre pattern intéressant émerge, c'est que la charge semble dégénérer avec le temps. Vous pouvez voir que pour chaque coupe, la charge va exponentiellement de plus en plus hors spec.

Comparez ceci à une autre panne de roulement sur une autre machine faisant la même pièce, et les patterns sont remarquablement similaires. C'est parce que c'est la signature unique pour une panne de roulement. Alors que les pannes de fraise en bout menant à pièces rebutées exhibent un saut de charge sur l'outil suivant, les pannes de roulement exhibent une augmentation grandement dégénérative de la charge sur tous les outils.
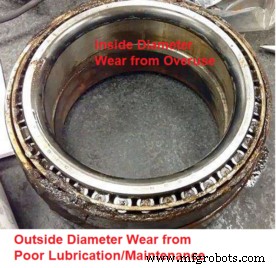
Et en regardant ça sur le temps, on voit en fait que cette dégénérescence commence des jours avant la panne réelle. Sur deux instances séparées pour deux machines, vous pouvez voir qu'il y a une élévation de charge bien avant la montée finale raide pendant les dernières 15 minutes avant la casse. C'est parce qu'un roulette ne lâche pas de nulle part. Il y a probablement un desserrage ou une fracture qui passe inaperçu pendant des jours avant le hari-kari final, amené par le mauvais usage ou le manque de maintenance. Dans ce cas, le roulement défaillant a aussi causé des dommages au logement de broche, qui a coûté un autre bon paquet de milliers de $ en réparation.
Panne de roulement novembre, montrant charge élevée ~2 jours avant. [Voir image taille réelle]
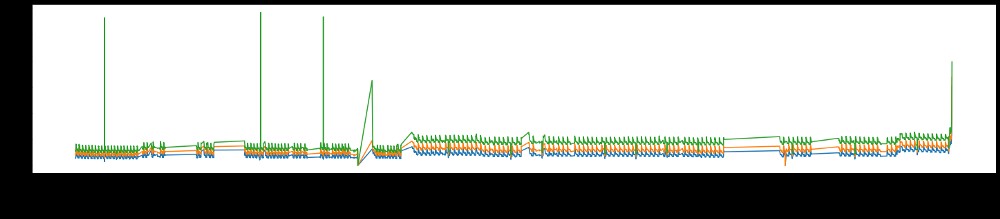
Panne de roulement février, montrant charge élevée ~1 semaine avant. [Voir image taille réelle]
La remarquable cohérence qu'on voit pour des types de panne similaires est due au fait qu'on regarde des phénomènes physiques, qui sont, surprise surprise, gouvernés par les lois de la physique. Ainsi, les pannes suivent des patterns déterministes qu'on peut discerner de données à fidélité suffisamment haute. Le truc c'est vraiment d'obtenir ces données et de les nettoyer pour qu'elles soient utiles, ce qui est une grande partie de notre IP.
On crédite cette innovation au mélange particulier de compétences qu'on a dans l'équipe MachineMetrics — on ne croit pas que ce soit typique d'avoir des opérateurs machine chevronnés travaillant avec des experts en protocoles cyber-physiques, suppléés par des physiciens du CERN et des data scientists de think tanks globaux, le tout soutenu par des investisseurs qui croient qu'on ouvre une nouvelle ère de l'industrie.
Pannes d'outils en cascade
Avoir une colonne entière d'outils qui cassent peut être une expérience frustrante pour tout machiniste. Malheureusement, c'est une occurrence trop commune dans notre industrie. Et si on pouvait voir quand le premier outil casse, et arrêter la machine immédiatement avant que les autres outils ne soient emportés ?
Il s'avère que vous pouvez. Après que le premier outil parte, le changement de signature de charge sur les outils subséquents est quasi servi sur un plateau.
Dans une instance de ceci, on voit le premier outil casser plusieurs cycles de pièces avant que la machine ne s'arrête elle-même quand elle détecte quelque chose de catastrophique. Au moment où l'auto-arrêt survient, d'autres outils ont aussi été emportés, coûtant à l'atelier des centaines de dollars de remplacements d'outils inutiles. Le premier outil a probablement cassé parce qu'il était usé et passé sa fin de vie, donc il probablement n'aurait pas pu être sauvé de toute façon. Mais il n'y a aucune raison pour que les autres outils après lui, certains fraîchement remplacés, y passent aussi.
Vous pouvez voir une animation de ceci ci-dessous, où la panne d'outil supposée selon l'opérateur, et quand la machine s'est auto-arrêtée, était à la Pièce 40. En fait, le signal commence à dégénérer autour de la Pièce 37, un plein 3 cycles avant que la machine ne s'auto-identifie que quelque chose n'allait pas. Pendant ces 3 cycles, l'outil qui a suivi l'outil cassé a aussi pété.

Décomposons ça par période d'utilisation d'outil en plus du numéro de pièce — les outils sont désignés par différents types de ligne.

Zoomons sur la région problématique. C'est un peu difficile à distinguer, mais ça ressemble à T101 qui est l'outil fautif qui a cassé, et T117 qui subit une charge plus haute dans les cycles immédiatement après, puis flatline (meurt). Une fois les outils remplacés, la signature de charge revient roughly à ce qu'elle était avant (en comptant pour un peu de glissement dû aux outils frais).

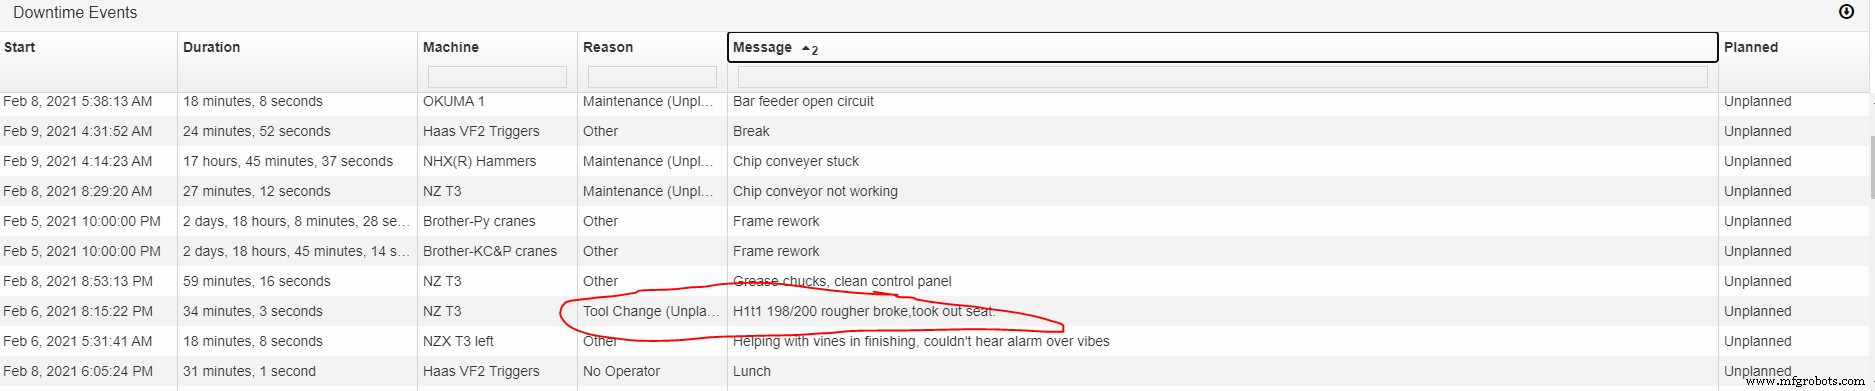
L'annotation dans ce cas était « H1t1 198/200 rougher broke, took out seat. » — signifiant, « tête 1, outil 1, l'outil d'ébauche, a cassé pendant le travail, à 198 sur 200 pièces prévues, et a emporté l'outil de siège (subséquent) ».
[Voir image taille réelle]
En effet, c'est ce qui s'est passé.
Restez branchés pour la Partie 2, où on passera en revue l'estimation de durée de vie d'outil, les conséquences de décalages incorrects sur votre machine, et les coupes incomplètes de panne d'outil.
Image de une courtoisie de Daniel Smyth.
Technologie industrielle
- 30 innovations de la NASA qui transforment la vie quotidienne
- Révolutionner la fiabilité des actifs : le Machine Learning pour la maintenance prédictive
- L'usinage CNC expliqué : types et applications des machines à commande numérique
- Commande numérique (CN/NC) : Définition, processus et avantages clés
- Usinage CNC : Transformation de la production militaire et de défense
- Maîtriser Fusion 360 : Exploiter la modélisation surfacique pour l'usinage de géométries complexes
- Comment l'IA et l'apprentissage automatique révolutionnent l'usinage CNC
- Exploiter l'analytique prédictive dans la fabrication : cas d'usage prouvés et bénéfices tangibles
- Pourquoi les fluides de coupe sont cruciaux pour le succès de l'usinage : durée outil, finition et efficacité