



Data Lakes vs Data Warehouses : Construire un Data Estate moderne
27 juillet 2021
Source : MCA Connect | Manufacturing Tomorrow
Les données arrivent vite et sous de nombreuses formes. Ces formes différentes peuvent inclure des données structurées, semi-structurées et non structurées et beaucoup de gens ne réalisent pas qu'un data warehouse et un data lake gèrent les données différemment.
Un data estate moderne devrait fournir de multiples méthodes d'ingestion et de stockage des diverses données que les entreprises génèrent. Les données arrivent vite et sous de nombreuses formes. Ces formes différentes peuvent inclure des données structurées, semi-structurées et non structurées et beaucoup de gens ne réalisent pas qu'un data warehouse et un data lake gèrent les données différemment. Examinons plus loin ces différents types de données :
- Structurées – bases de données traditionnelles comme la base de données transactionnelle pour votre ERP ou système CRM avec définitions formelles de colonnes et tables
- Semi-structurées – fichiers comme XML ou JSON qui sont auto-descriptifs avec balises pour éléments et hiérarchies
- Non structurées – images, vidéo, audio, et autres données binaires
Les designs traditionnels de data warehouse existent depuis des décennies tandis que le concept, ou du moins le terme, data lake est une construction quelque peu plus récente. Chacun de ces a une place dans le data estate de votre organisation.
Le Data Warehouse
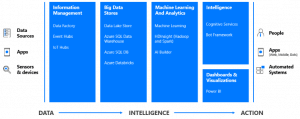
Comme nous pouvons le voir ci-dessus, les sources de données peuvent être très diverses et avoir différentes représentations de données, ce qui peut mener à de l'information divergente. En plus, la grande variété de schémas et structures dans les sources de données rend difficile l'obtention d'information consolidée quand un instantané complet des données est requis de tous les sous-systèmes métier. En général, c'est la raison principale de l'émergence des solutions Data Warehouse.
Un data warehouse est un design formel, fréquemment basé sur des guidelines de design qui implémentent un processus ETL (Extract-Transform-Load) formel pour consommer des jeux de données bruts structurés et les charger dans un modèle conçu pour le reporting. Les data warehouses sont construits sur des bases de données relationnelles comme Azure Synapse, précédemment Microsoft SQL Server. Azure Synapse est conçu pour stocker des données structurées dans des tables avec lignes et colonnes traditionnelles mais a la capacité de stocker des données semi-structurées comme XML et JSON.
Le Data Lake
Un data lake renverse le concept d'ETL sur sa tête et implémente un processus ELT (Extract-Load-Transform). L'ingestion de données dans le data lake consiste essentiellement à jeter tout ce que vous pensez pouvoir être précieux à un moment donné dans une grande zone de stockage indépendamment du type ou structure de données. Les data lakes peuvent stocker des données structurées, semi-structurées et non structurées. Les data lakes livrés dans Microsoft Azure sont construits sur des comptes de stockage avec Data Lake Storage Gen2 activé lors de la création du compte de stockage.
La pensée derrière un data lake est que vous voulez consommer toutes les données et les trier plus tard tandis que le data warehouse nécessite d'identifier la valeur en amont avec un investissement significatif dans le développement de l'ingestion. En raison de l'investissement initial lourd typiquement requis pour développer un data warehouse, s'il est déterminé plus tard que vous avez besoin de données qui n'ont pas été apportées initialement, il y a un risque que les données sources ne soient plus disponibles et potentiellement perdues à jamais.
But : indéterminé vs en usage
Le but de pièces de données individuelles dans un data lake n'est pas fixé. Les données brutes entrent dans un data lake, parfois avec un usage futur spécifique en tête et parfois juste pour les avoir sous la main. Cela signifie que les data lakes ont moins d'organisation et moins de filtration de données que leur homologue.
Les données traitées sont des données brutes qui ont été mises à un usage spécifique. Puisque les data warehouses ne contiennent que des données traitées, toutes les données dans un data warehouse ont été utilisées pour un but spécifique au sein de l'organisation. Cela signifie que l'espace de stockage n'est pas gaspillé sur des données qui ne seront peut-être jamais utilisées.
Accessibilité
L'accessibilité et la facilité d'utilisation font référence à l'utilisation du repository de données dans son ensemble, pas aux données à l'intérieur. L'architecture de data lake n'a pas de structure et est donc facile d'accès et facile à changer. De plus, tous les changements faits aux données peuvent être faits rapidement car les data lakes ont très peu de limitations.
Les data warehouses sont, par design, plus structurés. Un avantage majeur de l'architecture de data warehouse est que le traitement et la structure des données rendent les données elles-mêmes plus faciles à déchiffrer, les limitations de structure rendent les data warehouses difficiles et coûteux à manipuler.
Les avantages des deux
Les data lakes sont un moyen rentable de stocker de grandes quantités de données de nombreuses sources. Permettre des données de toute structure réduit le coût car les données sont plus flexibles et scalables car elles n'ont pas besoin de correspondre à un pattern spécifique. Cependant, les données structurées sont plus faciles à analyser car elles sont plus propres et ont un schéma uniforme à requêter. En restreignant les données à un schéma, les data warehouses sont très efficaces pour analyser des données historiques pour des décisions de données spécifiques. Un data warehouse propre et un data lake sont tous deux critiques pour le succès futur de votre organisation et appartiennent à votre data estate moderne.
Qu'est-ce qu'un Data Estate ?
Établir un data estate moderne est une étape fondamentale vers la transformation digitale. Un data estate moderne permet des insights opportuns et la prise de décision à travers toutes vos données et pose les fondations pour l'IA. Un data estate est l'ensemble des données qu'une organisation possède. Quand vous migrez ces données vers le cloud ou modernisez votre environnement on-premises, vous pouvez gagner des insights importants pour alimenter l'innovation.
Data Warehouse Microsoft Dynamics 365 Pré-construit, DataCONNECT
Construire un data warehouse peut être très cher et chronophage pour examiner correctement vos systèmes sources, designer un modèle de données, et créer l'ETL nécessaire pour le traiter. MCA Connect a développé notre solution Data Warehouse DataCONNECT pour Microsoft Dynamics AX, Dynamics 365 Finance, et Customer Engagement. Cette solution accélère grandement le calendrier pour la livraison d'une solution data warehouse complète tout en réduisant les coûts d'implémentation. C'est aussi un excellent moyen de commencer à construire votre data estate complet.
DataCONNECT peut alimenter les organisations avec des informations rapides et précises, leur donnant la capacité de prédire, adapter et façonner les opérations avec précision. Vous pourrez rapidement extraire des données validées dans des modèles de prévision, pour que vous puissiez commencer vos cycles de planification pour les domaines de votre entreprise. Si vous souhaitez en savoir plus sur comment le Data Warehouse DataCONNECT ou un data lake peuvent aider votre entreprise à stocker le big data, contactez-nous. Un de nos experts sera ravi de vous guider dans la bonne direction.
Le contenu et opinions dans cet article sont ceux de l'auteur et ne représentent pas nécessairement les vues de Manufacturing Tomorrow.
Technologie industrielle
- La Quatrième Révolution Industrielle : comment l'Industrie 4.0 redessine le manufacturing
- Assurer la conformité des données dans l'Internet des objets
- Exploiter les données dans l'Internet de la fiabilité : stratégies pour une gestion efficace
- De l'ivoire à la bakélite : retraçant l'évolution des plastiques modernes
- Maintenance prédictive : exploiter l'Industrie 4.0 pour une production ininterrompue
- Démocratiser l'Internet des objets : la prochaine génération satellite IoT apporte connectivité universelle, abordable
- Libérer la valeur des données IoT : stratégies sécurisées et pilotées par les insights
- Pourquoi les mesures analogiques pilotent la performance usine
- Approvisionnement stratégique en données : la clé de chaînes d'approvisionnement résilientes