



Exploiter Document Understanding pour piloter l'automatisation, la précision et le ROI
La compréhension documentaire vise à libérer les données piégées dans les documents pour accorder à votre organisation une précision bien plus élevée des données extraites, une productivité accrue et un ROI croissant de l'automatisation des processus robotiques (RPA). Elle se situe à l'intersection du traitement documentaire et de l'intelligence artificielle (IA), qui contribuent ensemble à un avenir où presque tout peut être automatisé.
L'écosystème de compréhension documentaire inclut des technologies capables d'interpréter l'information et le sens d'une large gamme de types de documents — même l'écriture manuscrite, les cases à cocher et les tampons. L'apprentissage automatique (ML) stimule l'innovation continue dans la compréhension documentaire, qui est l'un des domaines de l'automatisation à la croissance la plus rapide.
Les organisations travaillent peut-être déjà avec des solutions ou fournisseurs spécifiques. Pourtant, elles peuvent avoir besoin d'autres technologies ou d'une nouvelle expertise pour étendre la compréhension documentaire à d'autres fonctions métier. Il peut être difficile de trouver un fournisseur qui a une solution universelle fonctionnant avec tous types de documents. Ils se concentrent généralement sur des types de documents ou des industries particulières, comme l'assurance, la finance et la santé. Il y a aussi des fournisseurs qui offrent des solutions basées sur le ML comme des modèles pré-entraînés pour des documents spécifiques. Pourtant, ces modèles ne peuvent pas être facilement modifiés pour s'adapter à des documents en dehors de ces domaines.
Il est actuellement difficile de trouver un fournisseur offrant une solution universelle qui fonctionnera avec n'importe quel document imaginable. En retour, UiPath offre aux entreprises un moyen de relever les défis et les possibilités du traitement documentaire automatisé. Pour commencer, il y a nos capacités IA natives que vous pouvez essayer via l'essai UiPath Enterprise.
Les capacités de la plateforme UiPath Enterprise RPA sont améliorées par des offres de partenaires complémentaires permettant un traitement documentaire fluide de bout en bout — ceux-ci sont disponibles dans le UiPath Marketplace. Le Marketplace offre un écosystème ouvert avec des solutions de partenaires qui, combinées avec la plateforme UiPath RPA, peuvent répondre à une large gamme de cas d'usage.
Examinons de plus près ces technologies d'écosystème et les principaux fournisseurs les fournissant.
Plusieurs technologies peuvent libérer la puissance de la compréhension documentaire
Voici certaines des technologies les plus couramment utilisées dans la compréhension documentaire, ainsi que les partenaires UiPath qui construisent des solutions autour d'elles :
Reconnaissance optique de caractères (OCR)
L'OCR convertit les images de texte tapé, manuscrit ou imprimé en texte encodé machine qui peut être traité ultérieurement pour extraire les données souhaitées. La technologie extrait généralement aussi des informations sur la mise en page et la structure du contenu. Vous avez peut-être été parfois ralenti en travaillant avec des documents PDF dans lesquels vous ne pouvez pas copier de texte ou appliquer de recherche car les pages PDF sont essentiellement des images. De même, vous pouvez avoir une numérisation, une photo ou une capture d'écran d'un reçu, par exemple, dans des formats graphiques typiques comme JPEG ou TIFF. L'OCR peut facilement collecter toutes les informations nécessaires de ces fichiers sans qu'un humain n'ait à lire tous les documents lui-même.
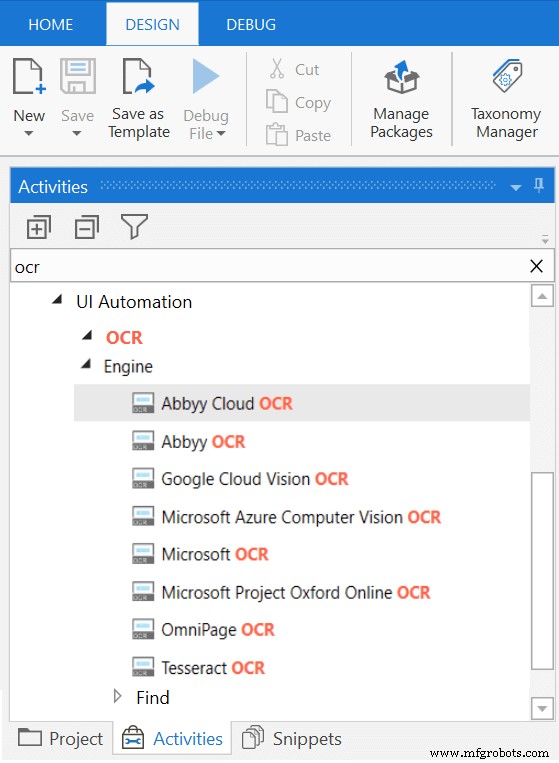
De nombreux moteurs OCR les plus connus sur le marché sont intégrés avec UiPath. Ceux-ci incluent ABBYY FineReader, Tesseract (un OCR open source fourni par Google), Kofax OmniPage, Microsoft OCR et Google OCR. De plus, UiPath Document OCR a été récemment publié comme un autre excellent choix pour les clients.
Extracteurs basés sur modèles (TBE)
Les TBE extraient les données en utilisant des règles fixes appliquées à des modèles créés par un utilisateur ou une machine. Les TBE peuvent ne pas fonctionner pour des documents dont la structure change fréquemment ou nécessite différentes variations de modèles. Cela signifie que ce n'est pas une option lorsque vous travaillez avec de nombreuses organisations différentes et traitez divers modèles de factures ou reçus qu'elles envoient. En même temps, la technologie est idéalement adaptée pour gérer un nombre relativement petit de modèles pour des documents stables. N'hésitez pas à l'adopter lorsque vous avez un ensemble prédéfini de modèles fixes et qu'aucune exception n'est attendue. Lorsqu'un changement de format de document est nécessaire, il est facile de modifier le modèle manuellement.
Il y a de nombreux fournisseurs offrant des TBE. Lors de l'évaluation de la solution à choisir, vous devriez prêter attention à la facilité de configuration d'un modèle, et à la façon dont les résultats d'extraction dépendent de la qualité de l'image. Certaines des meilleures entreprises offrent des technologies qui créent les modèles de manière semi-automatique en utilisant un processus human-in-the-loop qui ne fait que confirmer le choix.
Un excellent exemple de TBE est ABBYY FlexiCapture, qui est intégré dans UiPath Studio. Il y a aussi un extracteur de modèles UiPath disponible dans le cadre de UiPath Document Understanding.
Extracteurs ML basés sur l'apprentissage supervisé (SMLE)
Les SMLE peuvent être utilisés pour des documents structurés et semi-structurés. Ces derniers n'ont pas une mise en page stricte comme les documents structurés mais peuvent inclure des contenus similaires. Un bon exemple est les factures et bons de commande. Les SMLE fonctionnent en étiquetant un ensemble de documents d'échantillon, c'est-à-dire en associant les éléments de données à extraire avec la zone du document d'où les données sont extraites.
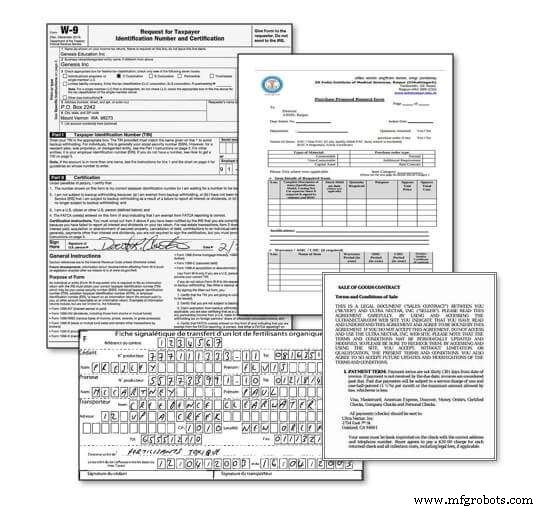
Actuellement, UiPath dispose d'extracteurs basés sur ML pour les factures, reçus et bons de commande. D'autres modèles pré-entraînés seront disponibles bientôt. UiPath est également intégré avec ABBYY FlexiCapture Distributed et FlexiCapture for Invoices qui exploitent des modèles ML pré-entraînés pour les factures et documents similaires. De plus, UiPath est intégré avec Hyperscience, Ephesoft, Vidado, Rossum, Omnius, Microsoft Form Recognizer et Amazon Textract. Toutes les intégrations offrent des techniques pour documents structurés et semi-structurés.
Lors de l'évaluation des options SMLE, demandez au fournisseur combien d'échantillons sont requis pour entraîner les modèles. Si le nombre est élevé, le processus pourrait entraîner un coût important en raison des tâches d'étiquetage et du besoin de nombreux échantillons.
Apprentissage non supervisé (USL)
Cette technique consiste à analyser un ensemble de données sans nécessiter de pré-étiquetage des données. L'USL utilise des modèles pré-entraînés ou différentes représentations de connaissances compatibles avec l'ordinateur pour traiter des documents non structurés. Les cas d'usage courants incluent l'analyse d'états financiers, de contrats et d'e-mails.
UiPath a plusieurs partenaires offrant des solutions USL, notamment Indico, SortSpoke, Botminds AI Technologies et Xtracta. Indico, par exemple, offre un outil d'étiquetage assisté par ordinateur qui suggère des étiquettes associées aux données dans les documents. Tout ce que l'utilisateur a à faire est de les approuver ou les écraser.
Traitement du langage naturel (NLP)
Les technologies NLP aident les ordinateurs à comprendre le langage humain. Le NLP est souvent combiné avec d'autres technologies pour effectuer une gamme de tâches. Il permet aux organisations d'exécuter l'analyse de texte, l'extraction d'entités et d'automatiser les processus en définissant l'intention dans des documents non structurés comme les e-mails. Si vous voulez extraire la Date de Début et la Date de Fin d'un document non structuré, vous devez être capable de mapper la chronologie du travail car de nombreuses dates sont des synonymes. Le NLP vous aide à faire cela car il peut déterminer et analyser les synonymes. De plus, il peut analyser le sentiment d'un texte — en d'autres termes, définir s'il est positif, négatif ou neutre. Cela peut être particulièrement précieux pour interpréter le contenu dans les actualités, les médias sociaux ou la correspondance. Les partenaires et technologies NLP intégrés avec UiPath incluent Expert System, Amazon Comprehend et le groupe Stanford NLP.
Alternatives émergentes — externalisation des processus métier et human-in-the-loop
Avec les technologies et entreprises établies listées ci-dessus, il y a une émergence de fournisseurs offrant l'externalisation des processus métier (BPO) et des processus human-in-the-loop (HITL) pour améliorer la compréhension documentaire.
Par exemple, Ocrolus et Contract Wrangler ont de puissantes technologies basées sur le ML pour la compréhension documentaire. Pourtant, ils font appel à une main-d'œuvre humaine crowdsourcée qui aide à corriger les résultats d'extraction de documents qui ne répondent pas au seuil de précision souhaité. Les deux entreprises sont disruptives car elles garantissent jusqu'à 99,99 % de précision et un engagement de délai de livraison. Bien sûr, une précision plus élevée et des exigences de temps plus courtes peuvent entraîner des coûts plus élevés pour les clients.
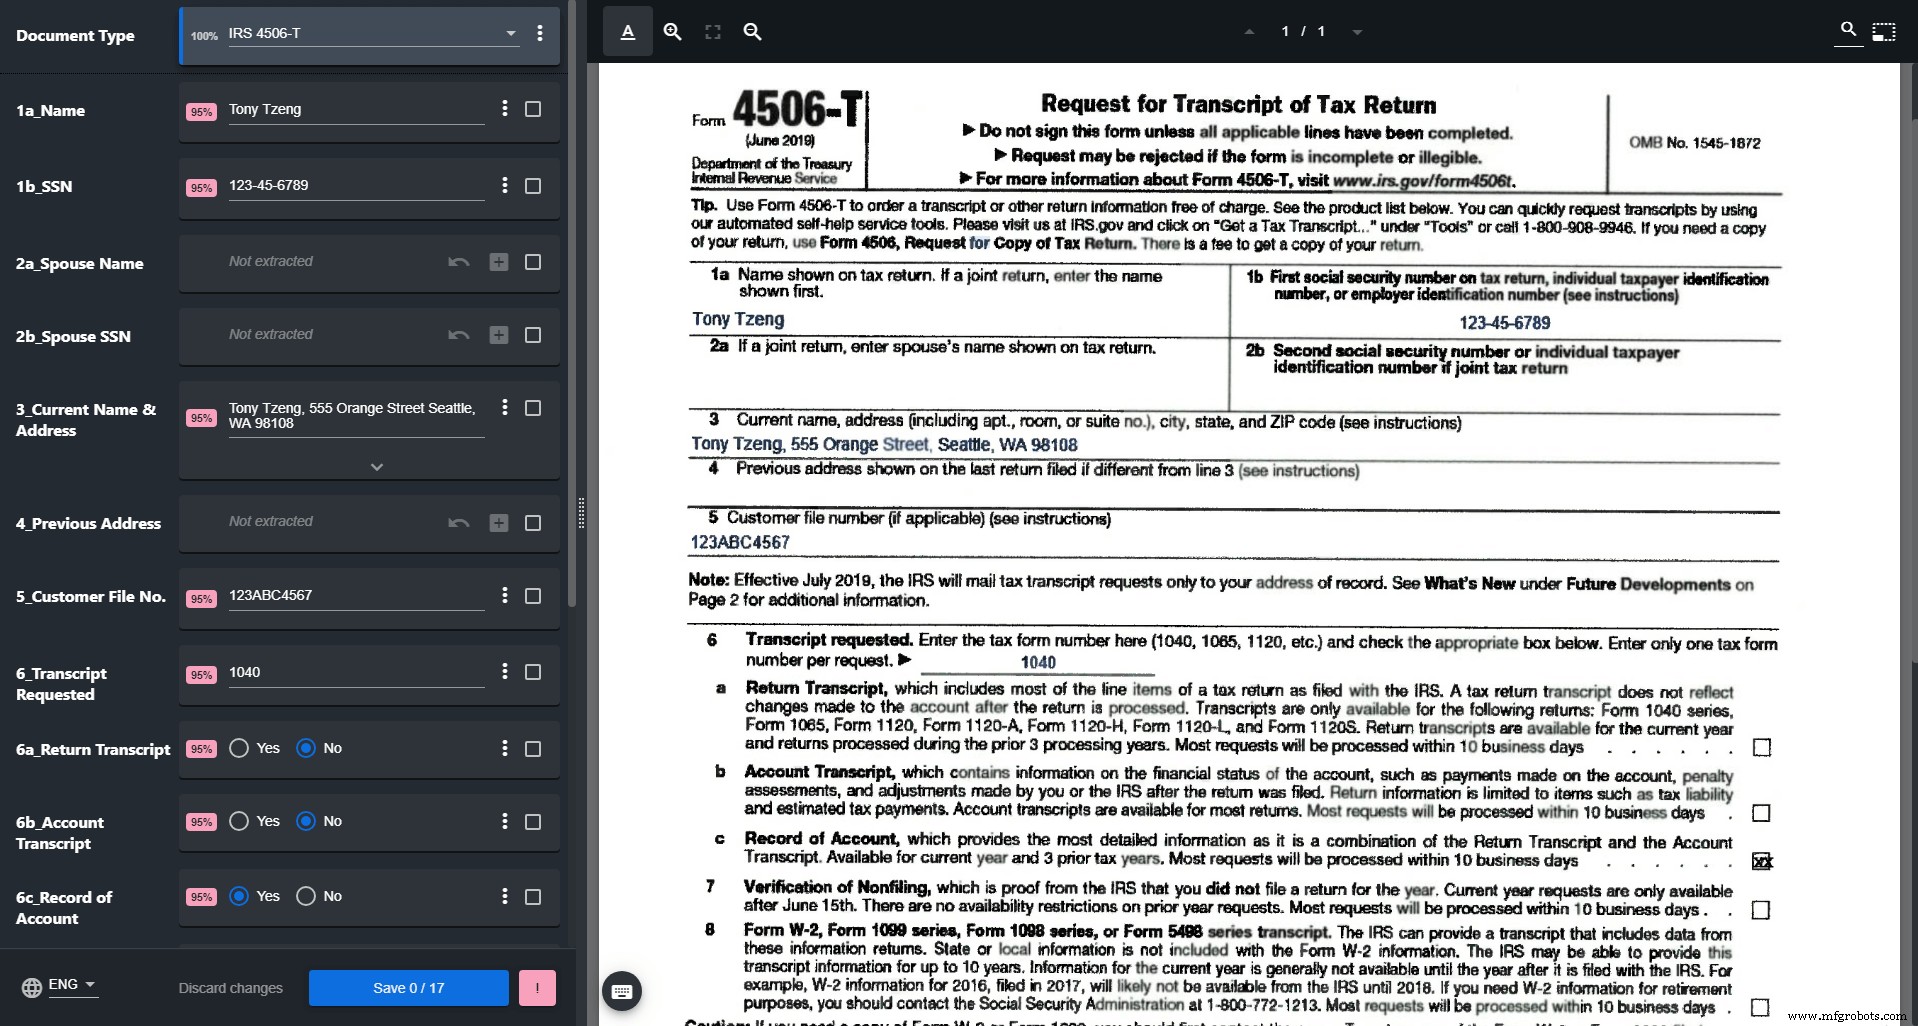
De plus, la solution UiPath Document Understanding fournit la Station de Validation. Cet outil permet aux utilisateurs de revoir et, si nécessaire, de corriger les résultats de classification documentaire et d'extraction automatique de données.
Réflexions finales sur le choix d'une solution
Choisir une solution qui répond à tous vos besoins métier pour la compréhension documentaire peut poser un grand défi. Cela mène généralement à évaluer des options pour implémenter plusieurs solutions simultanément et chercher les meilleures façons de les intégrer. C'est pourquoi UiPath travaille et s'intègre avec une large gamme de fournisseurs leaders de l'industrie. Nous avons établi un écosystème riche de compréhension documentaire qui complète la plateforme UiPath RPA.
Pour des informations plus approfondies, rejoignez notre webinaire « Product Spotlight : Automatisations augmentées par l'IA — Combiner des capacités transformatrices ». Vous verrez comment UiPath Document Understanding et d'autres solutions basées sur ML peuvent aider à porter vos automatisations à un tout nouveau niveau — propulsées par l'IA. Vous pouvez également essayer ces capacités pour aider à automatiser vos processus métier en vous inscrivant à l'essai UiPath Enterprise.
Système de contrôle d'automatisation
- Fabrication d'arbres experte : procédés de précision et solutions sur mesure
- Pourquoi la Culture Cloud Pilote le Succès Business : Guide Pratique
- Comment la maintenance prédictive booste l'efficacité et réduit les temps d'arrêt
- Fraiseuses 101 : guide complet sur leur fonction, composants et utilisations
- Automatiser pour la résilience : Assurer la continuité des activités dans le nouveau normal
- Exploiter l'IA pour révolutionner la compréhension documentaire : accélérer vitesse et précision
- Comprendre la programmation robotique : Méthodes expliquées
- Comment l'automatisation génère valeur et efficacité dans la fabrication moderne
- Maîtriser la gestion des connaissances de l'entreprise : Un plan éprouvé pour un succès continu