



Traitement documentaire amélioré : fusionner approches par règles et par modèles pour une automatisation précise
L'information est le pouvoir. Pour la plupart des entreprises, de nombreuses informations commerciales précieuses sont piégées dans des documents. Compte tenu de la variété des types, tailles et formats de documents que les entreprises gèrent souvent, traiter efficacement les documents pour en tirer des insights peut être un défi.
Chez UiPath, nous comprenons ce défi. Grâce à notre nouveau framework de compréhension documentaire, nos clients peuvent facilement automatiser l'extraction et le traitement des données pour une large gamme de documents, quel que soit leur type, format ou volume. Cela vous aide à aborder le traitement documentaire avec flexibilité, en utilisant le processus qui fonctionne le mieux pour vos besoins uniques.
Pour une vue d'ensemble des avantages de la compréhension documentaire, consultez notre livre blanc Augmenter l'efficacité opérationnelle et atténuer les risques avec Document Understanding.
Dans cet article, nous allons :
Passer en revue les types et classifications de documents courants
Examiner les méthodes d'extraction de données basées sur règles et basées sur modèles
Examiner les défis courants auxquels les entreprises font face lors de l'application de chacune de ces approches standard au traitement documentaire
Passer en revue les avantages que les entreprises peuvent obtenir si les deux approches de traitement documentaire sont combinées en une méthode d'extraction de données multi-approches
Commençons.
Paysage documentaire
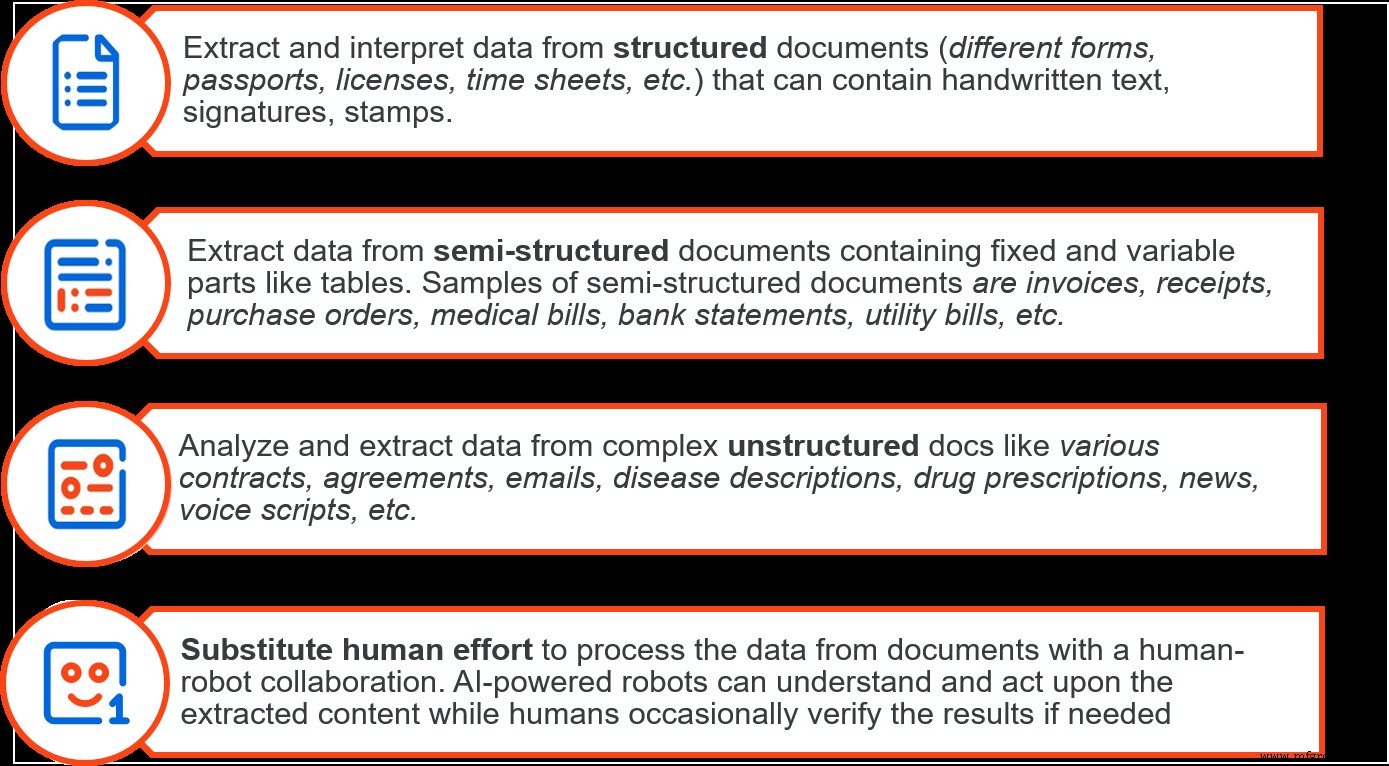
Selon leur structure et leur format, les documents peuvent être classés en trois types.
1. De nombreux documents, comme les formulaires fiscaux, restent fixes en format — on les appelle documents structurés.
2. D'autres, comme les contrats, n'ont pas de structure standard — on les appelle documents non structurés.
3. Enfin, les documents qui ont des qualités variables, comme des mises en page ou des designs différents, mais incluent des types d'informations similaires sont appelés documents semi-structurés. Les reçus, factures et bons de commande sont des exemples courants de documents dans cette catégorie.
Basée sur la classification des documents, il existe deux types courants de méthodologies d'extraction de données. L'extraction de données basée sur règles cible les documents structurés, tandis que l'extraction de données basée sur modèles est utilisée pour traiter les documents semi-structurés et non structurés.
Avantages et limites des méthodes d'extraction de données basées sur règles
L'extraction de données basée sur règles repose sur un ensemble de règles pour extraire des données d'un document. Par exemple, vous pouvez créer des modèles de documents et appliquer des règles basées sur la position spécifique des données. Alternativement, sans avoir à créer de modèles, vous pouvez simplement appliquer des règles basées sur la fréquence à laquelle certains ensembles de données sont utilisés dans un document (motifs d'occurrence) ou sur l'apparence habituelle de ces variables de données dans une séquence de caractères (expression régulière ou regex).
La première approche est utile pour traiter des formulaires qui peuvent être modélisés, et la seconde est utilisée s'il est possible et facile de créer de telles règles. Nous constatons que les méthodes basées sur règles sont faciles à configurer et à comprendre, et qu'elles fonctionnent très efficacement dans le traitement documentaire. Cependant, elles sont limitées aux documents structurés et seulement dans quelques cas simples aux documents semi-structurés.
Donc, bien que les techniques d'extraction de données basées sur règles soient bénéfiques dans de nombreux contextes, elles ont des limitations d'application évidentes. Puisque l'extraction basée sur modèles est étroitement liée à une mise en page de document fixe, tout changement dans la mise en page peut casser les règles et nécessiter une reconfiguration des règles.
De même, les techniques basées sur regex peuvent être difficiles à implémenter, déboguer et lourdes à mesure que les situations deviennent plus complexes. Cependant, il existe une approche alternative aux solutions d'extraction basées sur règles — une approche basée sur modèles.
Avantages et limites des méthodes d'extraction de données basées sur modèles
Les méthodologies d'extraction de données basées sur modèles reposent sur l'apprentissage automatique (ML). Ces méthodes sont puissantes grâce à leur capacité à apprendre à partir d'un ensemble diversifié de documents. Nous utilisons ces méthodes en employant des techniques sophistiquées telles que le traitement du langage naturel (NLP) et l'apprentissage statistique.
La Station de Validation UiPath arme les utilisateurs avec une capacité human-in-the-loop pour que les modèles puissent apprendre à la volée et s'adapter aux changements dans les données. La technologie propulsée par l'intelligence artificielle (IA) est généralement utilisée pour l'extraction de données depuis des documents semi-structurés et non structurés. Nous avons, par exemple, créé des modèles ML pour notre framework de compréhension documentaire pour adresser des scénarios tels que le traitement des reçus et factures.
En savoir plus : Utiliser l'IA pour automatiser le traitement des factures et reçus
Le défi de l'utilisation des techniques d'extraction basées sur modèles est le temps et l'expertise qu'elles peuvent prendre pour créer et implémenter des modèles ML. Dans de nombreux scénarios, cependant, les techniques basées sur modèles sont supérieures dans leur capacité à apprendre et s'adapter à différentes structures et inclusions de documents.
Adopter l'extraction de données multi-approches
Il n'y a pas de solution miracle pour répondre à tous les besoins de traitement documentaire. Les approches basées sur règles et basées sur modèles pour l'extraction de données sont des outils puissants mais limités dans leurs capacités à traiter de manière optimale la gamme de documents que les entreprises gèrent.
Certains documents structurés peuvent avoir besoin de bien plus que de simples méthodologies basées sur règles, car certaines données ne peuvent pas être extraites avec l'aide de règles ou de modèles. De même, les méthodes uniquement basées sur modèles ne fonctionnent pas pour tous les documents non structurés et semi-structurés.
Nous voulons que les utilisateurs puissent facilement combiner différentes approches pour extraire l'information d'un seul document. C'est pourquoi nous avons conçu notre framework de compréhension documentaire pour vous donner le pouvoir de surmonter les limitations imposées par toute approche individuelle. Nous recommandons vivement d'utiliser l'extraction de données multi-approches lorsque vous traitez des documents complexes et souhaitez atteindre les plus hauts niveaux de précision pendant le processus d'extraction de données.
Extraction de données multi-approches rapide et précise
En utilisant notre framework flexible, vous pouvez mélanger et assortir les approches de traitement documentaire en déposant simplement plusieurs techniques d'extraction de données directement dans votre flux de travail dans UiPath Studio.
Vous pouvez facilement configurer des extracteurs pour le traitement des données, définir l'ordre de préférence pour l'exécution de l'extraction, et définir une valeur comme seuil pour que certains résultats d'extracteur soient acceptés comme valides. Ainsi, ni la structure variable des documents ni les règles complexes d'extraction de données ne poseront plus de défi. En même temps, au sein de l'automatisation de bout en bout, vous obtenez un traitement documentaire plus rapide et beaucoup plus précis avec la dernière technologie IA.
Intéressé ?
Avoir des capacités d'extraction et de traitement documentaire efficaces et précises est crucial. Grâce à notre accent sur l'extraction de données multi-approches, nous voulons rendre le traitement et l'analyse documentaire aussi faciles que possible pour les clients UiPath.
Actuellement, les capacités et fonctionnalités étendues de Document Understanding sont disponibles en tant que Software-as-a-Service (SaaS) en version bêta pour les utilisateurs impliqués dans des pilotes antérieurs. Vous pouvez vous attendre à ce que ces fonctionnalités et d'autres outils avancés de Document Understanding soient disponibles bientôt. En attendant, nous vous encourageons à vous inscrire à l'essai entreprise UiPath pour accéder à la solution UiPath Document Understanding.
Système de contrôle d'automatisation
- L'armée américaine fait progresser la maintenance conditionnelle avec capteurs innovants et analytique prédictive
- Conception hygiénique pour industries alimentaires et de transformation : De la nettoyabilité aux économies
- Comment l'IIoT et l'analytique transforment l'EHS : booster sécurité, efficacité et économies
- Comment les données capteurs et opérationnelles boostent la rentabilité d'un grand fabricant de camions
- Edge AI : Pourquoi le traitement se déplace vers la couche périphérique
- Le Fog Computing Expliqué : Transformer le Flux de Données IoT et Réduire la Charge Cloud
- Révolutionner la gestion de flotte : intégration IA & IoT pour des opérations plus intelligentes
- ABB dévoile une automatisation cloud de pointe pour les centres de données
- Ambarella, Lumentum et ON Semiconductor dévoilent des solutions de détection 3D pilotées par IA pour périphériques AIoT de nouvelle génération