



Exploiter l'OCR, l'IA et la RPA pour débloquer des insights de données avancés
Cet article a été co-écrit par Cosmin Nicolae. Nicolae est Product Manager chez UiPath.
Les données non structurées sont partout, cachées dans des documents, fichiers audio, vidéos, e-mails, images, fichiers journaux — la liste est longue. En fait, les données non structurées représentent désormais environ 80 à 90 % de toutes les données. Pourtant, malgré leur abondance et leur valeur, les données non structurées restent l'une des ressources d'entreprise les plus gaspillées, car les entreprises manquent des outils nécessaires pour les extraire et les analyser.
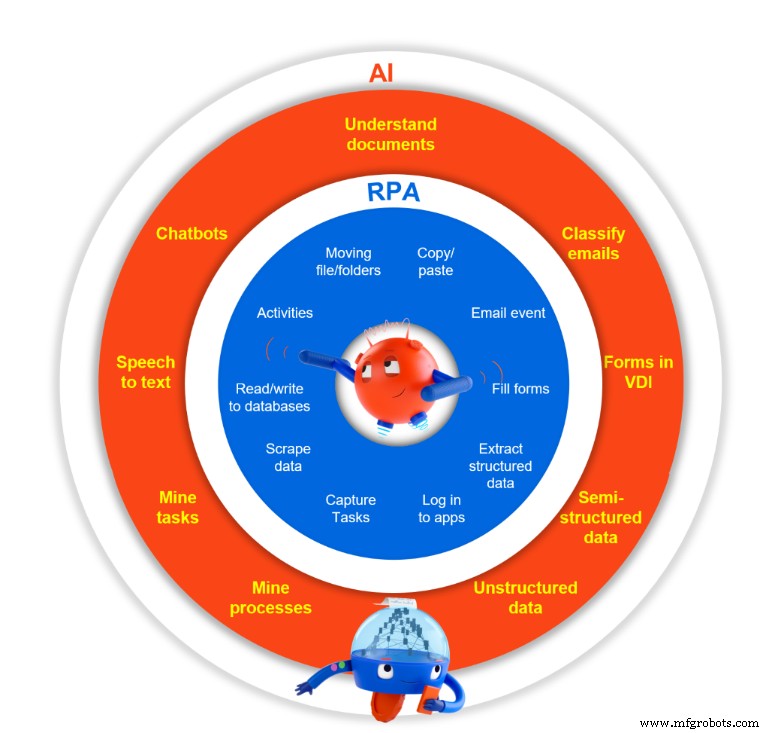
Cela change, car la demande augmente pour l'analytique des big data et l'automatisation des flux de travail — tous deux nécessitant des données structurées. Un nombre croissant d'entreprises exploitent une technologie appelée reconnaissance optique de caractères (OCR), qui permet de convertir du texte imprimé ou manuscrit en texte encodé machine. En tant que technologie autonome, l'OCR est quelque peu limitée (plus de détails ci-dessous). Pourtant, grâce à la triade OCR, Automatisation des Processus Robotiques (RPA) et intelligence artificielle (IA), les entreprises peuvent permettre des niveaux de traitement de données et d'automatisation hautement avancés.
L'OCR est l'un des composants clés au sein de deux solutions UiPath :
UiPath Document Understanding, permettant le traitement automatisé d'une large gamme de documents
UiPath AI Computer Vision, qui permet aux développeurs d'automatiser sur des bureaux virtuels et dans des interfaces dynamiques
Ce blog fournira un aperçu de l'OCR tout en explorant comment UiPath utilise cette technologie pour permettre le traitement et l'analyse de données de nouvelle génération.
D'abord, voici une introduction rapide à l'OCR.
OCR : Aperçu
En termes simples, l'OCR est un processus qui convertit le texte des images en documents éditables.
L'OCR peut réduire, voire éliminer le travail manuel pour certaines tâches. Par conséquent, il peut accélérer les flux de travail back-office tout en libérant les travailleurs pour qu'ils assument des responsabilités plus importantes.
Voici quelques façons courantes dont les entreprises utilisent l'OCR.
1. Automatisation de la saisie de données
La saisie manuelle de données est chronophage et sujette aux erreurs. En utilisant l'OCR, les entreprises peuvent numériser la paperasse tout en minimisant le besoin d'intervention humaine et en augmentant l'intégrité de leurs données.
2. Édition de documents (scannés ou PDF)
Les employés reçoivent souvent des documents scannés et des notifications par fax qui ne sont pas dans un format éditable. C'est un cas courant dans des départements comme la finance, la gestion de la chaîne d'approvisionnement, les ressources humaines, le juridique et la conformité. Les scanners traditionnels ne peuvent exporter les documents que sous forme d'images ou de PDF. Par exemple, vous ne pouvez pas numériser un contrat ou un bon de commande, puis l'éditer dans Microsoft Word ou Google Docs. Cependant, en utilisant un moteur OCR, il est possible de reconnaître le texte et de l'exporter dans un format lisible par machine pour un édition et un traitement ultérieurs.
3. Autonomiser les employés malvoyants
Les employés malvoyants ont souvent besoin de convertir des documents papier en formats numériques. L'OCR peut aider en convertissant le texte écrit en synthèse vocale, rationalisant le processus.
4. Organisation des documents
L'OCR peut trier automatiquement des piles variées de documents et les organiser selon des règles spécifiques. Un exemple classique serait l'organisation des factures par type ou fournisseur. Ou dans des processus critiques comme l'utilisation de l'OCR multiligne (MLOCR) dans une machine de tri postal qui scanne les adresses et détermine comment acheminer le courrier dans le système postal.
5. Comprendre le texte sur les interfaces
L'OCR permet de traiter des données sur des interfaces distantes, rendant la collaboration plus rapide et plus facile pour les équipes à distance.
Les limites de l'OCR
Bien que l'OCR soit très puissant, il présente plusieurs limites lorsqu'il est utilisé comme technologie autonome.
Voici certaines des principales limites de l'OCR.
1. L'OCR ne peut pas comprendre les données par lui-même
Premièrement et avant tout, l'OCR ne peut que numériser le texte des documents et le rendre lisible par machine. L'OCR ne peut pas comprendre ou interpréter les données sans un mécanisme complémentaire. En tant que tel, l'OCR est souvent utilisé comme composant au sein d'une solution plus large et plus intelligente. Pour permettre une véritable automatisation des processus à grande échelle, l'OCR et la RPA sont combinés avec l'IA.
2. L'OCR manque de contexte
Les systèmes OCR manquent également de contexte. Par exemple, un système OCR peut transcrire un mot comme « bail » alors que le mot réel est « ball ». Un moteur OCR seul n'aura pas la capacité cognitive nécessaire pour scanner le reste de la phrase pour voir quel mot devrait être utilisé. Pour cette raison, l'OCR en tant que technologie autonome est très sujet aux erreurs. Il nécessite un composant human-in-the-loop pour vérifier l'exactitude des entrées. En conséquence, l'OCR seul manque de valeur optimale en tant qu'outil d'automatisation.
3. L'OCR ne peut pas gérer la variabilité
De plus, l'OCR ne peut pas gérer la variabilité dans le texte ou la mise en page d'un document, ce qui est un gros problème lors du traitement de documents dont la structure varie.
4. L'OCR ne peut pas séparer les documents
D'autres problèmes peuvent survenir si les fichiers doivent être séparés en documents avant d'être inclus dans un processus d'automatisation, ou s'il y a une répétition dans les champs d'index ou les valeurs clés d'un flux de travail.
5. L'OCR n'est pas assez précis ou évolutif
Au final, l'OCR pur n'est ni assez précis ni assez évolutif pour des processus complexes et cognitifs. Les entreprises ont besoin de solutions matures et flexibles, par opposition à des composants limités et sujets aux erreurs.
Comme vous pouvez le voir, l'OCR en tant que technologie autonome n'est pas assez sophistiqué pour prendre en charge les flux de travail d'entreprise avancés d'aujourd'hui. Pourtant, lorsqu'il est combiné avec des logiciels RPA et de l'IA, l'OCR peut devenir un outil extrêmement utile. La section suivante explorera comment UiPath utilise l'OCR pour permettre une automatisation hautement précise.
Cas d'usage : L'OCR dans UiPath Document Understanding
UiPath Document Understanding utilise la RPA et l'IA pour numériser les données des documents afin qu'elles puissent être traitées et analysées. Document Understanding peut gérer à la fois des données structurées et non structurées, et fonctionne avec une variété d'objets — comme l'écriture manuscrite, les tableaux, les cases à cocher et les signatures.
Document Understanding offre de nombreux avantages, tels qu'un traitement de documents précis et flexible, une efficacité opérationnelle accrue, une réduction du risque d'erreur humaine, ainsi que l'automatisation de bout en bout de processus complexes.
Il convient de noter que la technologie de compréhension documentaire n'est pas l'OCR. Le fait que les deux soient identiques est une idée fausse courante. Plutôt, la compréhension documentaire est une technologie avancée qui utilise l'OCR pour numériser le texte dans les documents non numériques.
Une distinction notable est que UiPath découple l'OCR de l'extraction de données. De nombreuses entreprises dans ce domaine incluent l'OCR avec l'extraction. En les découplant, UiPath offre un plus grand choix, flexibilité et précision, car il devient possible de sélectionner un autre moteur OCR si nécessaire sans perturber ce qui se passe du côté de l'extraction. Il est également possible d'utiliser les contrats publics UiPath OCR pour déployer votre propre moteur OCR si désiré.
Comment Document Understanding utilise l'OCR
L'OCR intervient tôt dans le processus Document Understanding — immédiatement après que la taxonomie est chargée dans le flux de travail et que tous les fichiers et données sont définis pour l'extraction.
Document Understanding utilise des moteurs OCR pour détecter et numériser le texte, le rendant lisible par un robot. À partir de là, les documents sont classifiés à partir de listes spécifiées, les données sont extraites, et — si nécessaire — un humain peut confirmer les données extraites avant qu'elles ne soient exportées vers le référentiel pertinent.
UiPath Document Understanding peut utiliser l'OCR propriétaire UiPath Document OCR, ainsi que des moteurs OCR tiers pour numériser le texte. Les clients peuvent choisir le moteur qui fonctionne le plus précisément pour leur cas d'usage.
Cas d'usage : L'OCR dans UiPath AI Computer Vision
UiPath AI Computer Vision résout l'un des principaux défis de la RPA, qui est l'automatisation de l'infrastructure de bureau virtuel (VDI) comme Citrix, VMware et Microsoft Windows Remote Desktop.
AI Computer Vision permet aux robots logiciels de voir et comprendre tous les éléments sur un écran d'ordinateur, au lieu de s'appuyer sur des propriétés cachées pour prendre des décisions. En utilisant AI Computer Vision, les entreprises et développeurs RPA peuvent permettre l'automatisation pour les VDI — quel que soit le framework ou le système d'exploitation.
AI Computer Vision permet l'automatisation incluant des éléments d'interface utilisateur (UI) dynamiques tels que les menus déroulants et les cases à cocher ; prenant en charge une large gamme de types d'interfaces. Cette solution peut réduire le temps d'implémentation lors de l'automatisation de machines virtuelles tout en augmentant la résilience et la fiabilité des automatisations.
Bien qu'AI Computer Vision utilise l'OCR, il n'est pas utilisé pour numériser des documents. C'est une distinction subtile mais courante.
Comment UiPath AI Computer Vision utilise l'OCR
Il est impossible d'automatiser dans des environnements virtuels en utilisant l'OCR standard et la RPA car un bureau distant n'est en fin de compte qu'un flux vidéo. Des solutions avancées sont nécessaires pour interpréter le texte, et plus important encore, comprendre leur type et leur purpose au sein d'une interface.
AI Computer Vision utilise un réseau de neurones avancé avec un OCR d'écran personnalisé développé chez UiPath au cours des dernières années pour analyser une UI sur un flux de bureau virtuel et la comprendre, comme le ferait un humain. Cette solution peut naviguer facilement dans n'importe quelle interface disponible, cliquer sur des boutons, mais aussi effectuer des interactions complexes comme extraire des tableaux entiers et interagir avec des menus déroulants.
Pour l'identification des éléments, AI Computer Vision utilise une technique d'interprétation de texte appelée correspondance floue (fuzzy matching). Cette technique permet aux robots UiPath d'identifier le bon élément à chaque fois, même en cas d'incohérences dans les résultats OCR, améliorant ainsi la fiabilité des automatisations résultantes et raccourcissant le temps de développement dans son ensemble.
Pousser l'OCR au niveau supérieur avec UiPath
Comme vous pouvez le constater, il y a une valeur énorme à utiliser une solution basée sur l'IA qui incorpore l'OCR. UiPath Document Understanding et les outils UiPath Computer Vision vont bien au-delà de l'OCR de base, permettant une automatisation rapide et fiable avec une évolutivité d'entreprise — ce qui vous permet de débloquer la valeur totale de vos données, y compris ce qui est non structuré ou verrouillé derrière un VDI.
Voici un graphique pour vous aider à décider si Document Understanding ou Computer Vision convient à vos besoins :
Prêt à commencer à mettre vos données documentaires et systèmes VDI au travail ?
Pour commencer, inscrivez-vous à UiPath Automation Cloud où vous pouvez commencer à utiliser UiPath Document Understanding et UiPath AI Computer Vision dès aujourd'hui.
Lancez votre essai gratuit UiPath Automation Cloud pour découvrir à quel point il est facile d'exploiter vos données non structurées pour apporter plus de structure et d'efficacité à vos processus métier.
Système de contrôle d'automatisation
- Stocker et Gérer Sécurément les Données Sensibles avec Google Cloud Secret Manager
- Exploiter l'IoT et le LPWAN pour transformer la collecte de données dans les industries du commerce
- Arch Systems et Flex s'associent pour transformer les données de fabrication avec l'analytique avancée
- IAoT industriel : fusion de l'IA et de l'IoT pour piloter l'innovation Industrie 4.0
- Débloquer la croissance des revenus pour les OEM Aéronautique & Défense via la transformation digitale pilotée par l'IIoT
- Révolutionner les opérations de grue : analyse de données pilotée par l'IA pour un contrôle plus sûr et plus efficace
- Litmus et Oden lancent des solutions IIoT intégrées pour la fabrication intelligente
- PwC Insights : exploiter l'IA et le Big Data pour transformer la fabrication
- Exploiter les données et l'IA pour transformer la fabrication : surmonter les défis du secteur