



Pourquoi les données sont la pierre angulaire de l'ingénierie fiabilité
 Dans le monde technology-driven d'aujourd'hui, les données sont le linchpin des décisions stratégiques. La discipline qui exploite ce potentiel — la data science — permet aux entreprises de gather, scruter, et appliquer l'information pour des choix plus intelligents, evidence-based.
Prévisions récentes projettent le volume global de données à atteindre 163 zettaoctets d'ici 2025 — équivalent à mille milliards de gigaoctets par zettaoctet. Cette croissance staggering force les organisations à confronter défis critiques en stockage, qualité, et gouvernance.
Cet article explore pourquoi des données fiables sous-tendent des études rigoureuses de fiabilité. La fiabilité, au core, est la probabilité qu'équipement, systèmes, ou installations performent sans défaillance sur un intervalle spécifié sous conditions d'exploitation définies. Conséquemment, données historiques de défaillance précises et leur analyse propre sont indispensables pour toute évaluation fiabilité crédible.
L'analytics données débloque le potentiel de vastes datasets, extrayant insights actionnables qui guident de meilleures décisions. Ce n'est réalisable que quand l'intégrité des données est incontestable ; données flawed mènent inévitablement à conclusions flawed.
Bénéfices de l'Analyse de Données
L'analyse fiabilité permet aux managers et ingénieurs de prendre décisions techniques et financières informées. En analysant données, ils peuvent raffiner designs projets, réduire coûts, prédire durées de vie composants, investiguer défaillances, fixer périodes garantie appropriées, planifier inspections efficaces, et identifier KPIs clés. Données précises sont le bedrock d'une étude fiabilité complète.
La collecte et filtration données sont responsabilités core de tout ingénieur fiabilité. Cela implique de rassembler et évaluer systématiquement information sur variables d'intérêt pour répondre questions recherche spécifiques, tester hypothèses, et supporter outcomes actionnables.
La collecte de données précise, honnête, est le dénominateur commun qui unifie tous efforts recherche, assurant que chaque étude part d'une fondation fiable.
Une variété d'outils et techniques peuvent processer données pour améliorer leur précision et fiabilité — comme suppression outliers, qui prévient résultats biaisés dans calculs fiabilité.
Établir des Données Robustes
Dans toute installation opérationnelle, données fiables — couvrant logs maintenance, enregistrements défaillances, fenêtres opérationnelles, et plus — forment la base pour études ingénierie fiabilité. Malheureusement, beaucoup d'entreprises manquent systèmes, processus, ou culture requis pour collecte et gestion données efficace.
Une base de données robuste doit capturer et stocker tous points de données significatifs. Une BDD qui collecte seulement un sous-ensemble de données essentielles peut délivrer une vue incomplète, potentiellement trompeuse des opérations et santé actifs.
Utiliser outils validés — méthodes qui garantissent collecte données fiable — peut améliorer pratiques. Par exemple, une entreprise finlandaise a rapporté que roughly 1 sur 6 rapports maintenance clos (17,2 %) omettait un mode défaillance, et aucun n'enregistrait détails pièces rechange. De tels gaps indiquent une BDD étroite qui échoue à capturer emplacements et impacts défaillances critiques.
Le reporting données timely est aussi crucial. Départements maintenance qui reportent hebdo ou mensuel sont plus susceptibles de perdre information critique que ceux avec système dynamique consolidant données temps réel.
Une best practice est de définir critères données haute qualité dans le système collecte et stockage, automatisant autant que possible pour assurer consistance et searchability. Compter sur champs open-text transforme analytics en tâche manuelle ; ils devraient être réservés pour détail supplémentaire, pas points de données primaires.
À la place, le système devrait comporter cellules dédiées pour chaque variable significative, employant menus dropdown où faisable pour standardiser descriptions et reporting. Consistance à travers la BDD est essentielle pour études fiabilité large-échelle.
Déterminer rapports et analyses requis en premier dicte quels champs données inclure. Pour études fiabilité, la BDD devrait capturer détails maintenance sur pièces rechange, modes défaillance, hommes-heures, findings inspections majeures, composants endommagés, et activités routine. Dropdowns structurés dans ces champs permettent au logiciel de calculer MTBF, disponibilité, et autres KPIs fiabilité automatiquement.
Facteurs Qualité Données
Outils et Technologie
Large array d'outils support objectifs qualité données, de déduplication et intégration données à migration et analytics. Ces outils aident uncover tendances et patterns en combinant et catégorisant données brutes.
Beaucoup solutions modernes sont mobile-enabled, réduisant erreurs humaines et système pendant capture données. Adopter telles technologies peut markedly améliorer qualité données.
Personnes et Processus
Chaque employé — des équipes maintenance aux ingénieurs et dirigeants — doit comprendre le rôle des données dans l'organisation. Cela inclut clarté sur quelles données sont collectées, à quelle fréquence, et pour quels buts. Formation et processus clairs sont essentiels pour maintenir collecte et stockage données fiables et consistants.
Culture Organisationnelle
Support management et culture data-driven sont pivots pour qualité. KPIs monitorant intégrité données devraient être reportés au leadership. Quand lançant nouveaux projets ou initiatives, organisations ont souvent besoin d'ajuster processus, rôles, structures, et technologie pour capturer données pertinentes.
L'amélioration continue drive le succès ; quantité et qualité données fuel ce moteur. Formation continue renforce l'importance des données, cultivant culture qui valorise information précise.
Impact des Données sur la Fiabilité
Considérez une case study où une installation visait booster production huile en installant nouveau package séparation gaz-huile (GOSP) avec unités stabilisation brut. Le GOSP comprenait pièges séparation, gestion brut wet, séparateur eau-huile, compression gaz, système flare, pompes transfert, et unités stabilisation.
Une étude RAM (fiabilité, disponibilité, maintenabilité) a prédit disponibilité production nouvelle installation et benchmarké contre cibles. L'étude a identifié goulets étranglement débit, recommandé améliorations, vérifié philosophies opérationnelles, et outlined actions correctives ou changements design.
Les données maintenance brutes — collectées via interviews équipes existantes — exhibaient plusieurs issues. Par instance, elles suggéraient que tous les 10 mois un compresseur serait hors service 30 jours pour défaillances joints mécaniques, impliquant 10 % downtime attribuable joints. Cette assumption est inaccurate pour facility employant technologie newer et lessons learned anciennes usines.
De même, données impliquaient intervalle maintenance 30 jours tous les 4 ans cause piqûre arbre. Matériaux upgradés dans nouveau design éliminent ce problème.
Additionnellement, mean time to repair (MTTR) pour vibration listé 60 jours, alors que nouveaux compresseurs — grâce à gestion pièces rechange améliorée — atteignent MTTR seulement 4 jours.
Ces assumptions mal alignées démontrent comment données dérivées d'actifs vieillissants peuvent misguider décisions pour installations modernes.
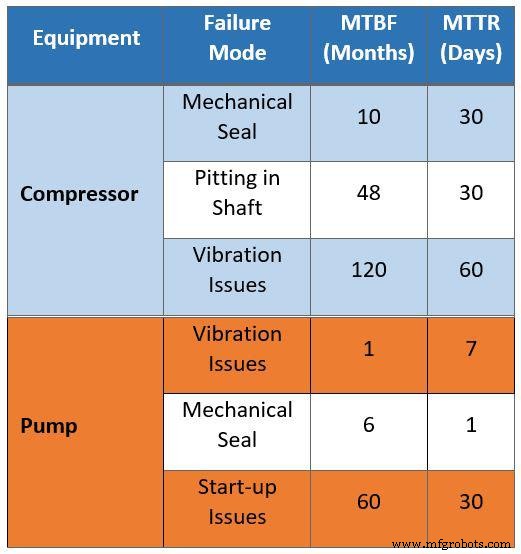 Tableau 1. Données terrain brutes collectées pour étude RAM
Tableau 2 présente le même dataset après filtrage par ingénieurs fiabilité. Ils ont retiré issues maintenance qui pouvaient être auto-corrigeables par instrumentation, puis catégorisé données par stratégies maintenance et opérationnelles pour isoler problèmes design-related comme goulets étranglement et contraintes capacité.
Les données corrigées peuvent être appliquées à la nouvelle facility pour guider optimisation design. Par exemple, modes défaillance compresseurs gaz montrent maintenant MTBF 8 ans (joints secs) et MTTR 3 jours. Assumptions corrosion compresseurs arbre éliminées par matériaux upgradés.
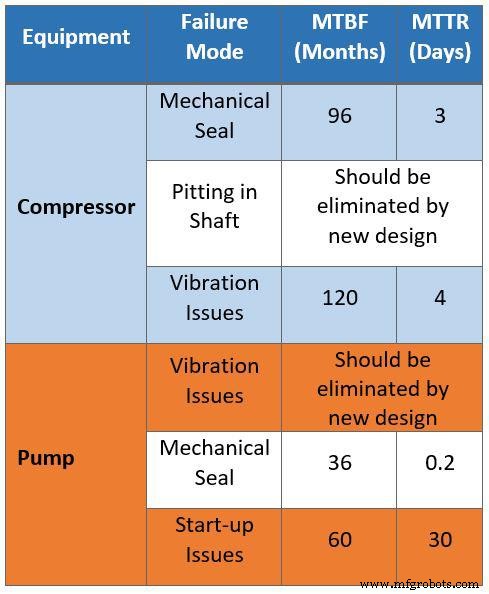 Tableau 2. Données filtrées collectées pour étude RAM
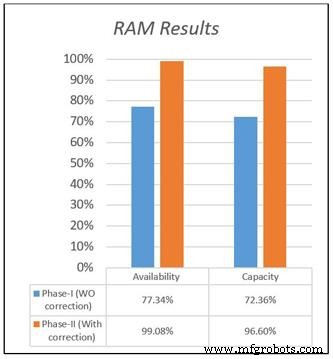 Figure 1. Résultats disponibilité et capacité étude RAM
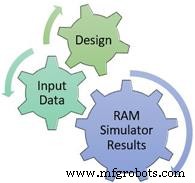 Figure 2. Relation entre données input, design, et outcomes simulation
La qualité des données input détermine la précision de tout modèle fiabilité — « garbage in, garbage out. » Un modèle RAM built sur données clean, well-structured permet optimisation et calcul KPI précis.
Dans études fiabilité focalisées, ingénieurs analysent données opérations pour identifier items « bad-actor » — composants avec coûts maintenance élevés et taux défaillance élevés. Recommandations dérivées de données incomplètes ou biaisées risquent de manquer les vrais problèmes, gaspillant ressources sur mauvaises priorités.
Par conséquent, systèmes collecte données efficaces qui définissent clairement types et quantités données requis sont essentiels pour prise de décision informée en planification maintenance, gestion pièces rechange, budgétisation, et problem-solving technique.
Trois Étapes Clés pour Améliorer Qualité Données
1. Déployer la Bonne Plateforme Base de Données
La solution choisie devrait forcer completion obligatoire de tous champs requis avant qu'une notification maintenance ou ordre travail ne soit clos. Cela élimine raccourcis qui compromettent consistance données.
2. Intégrer Fonctions Existantes dans Solution Unifiée
Une plateforme unique consolidant fonctions fiabilité réduit nombre systèmes disparates. Par exemple, intégrer tracking pièces rechange avec notifications maintenance assure que chaque mouvement pièce rechange est lié à un ordre travail spécifique.
3. Implémenter Programme Assurance Qualité Données
Audits réguliers qualité données à travers l'organisation sont essentiels. Une approche pratique est d'échantillonner aléatoirement 5 % notifications maintenance et ordres travail à chaque facility, évaluer intégrité données, et utiliser findings pour raffiner processus et usage système.
Les Données Sont la Pierre Angulaire
L'historique complet maintenance et réparation actifs doit être capturé, stocké, et analysé avec précision. Personnel de terrain — équipes maintenance et opérations — doit reconnaître leur rôle critique dans assurance qualité données.
Les données sont la fondation de la prise de décision informée, et la qualité données siège au cœur de chaque étude fiabilité. Données haute qualité permettent plaidoyer confiant, recherche rigoureuse, planification stratégique, et reporting management transparent.
À propos des auteurs
Khalid A. Al‑Jabr est spécialiste ingénierie fiabilité chez Saudi Aramco avec 18+ ans expérience industrielle focus fiabilité équipement. Il détient Ph.D., est chartered engineer, certifié engineering management et data analysis.
Qadeer Ahmed est consulting reliability engineer chez Saudi Aramco avec 18 ans expérience. Chartered engineer, Ph.D., Certified Maintenance & Reliability Professional (CMRP), Six Sigma Black Belt.
Dahham Al‑Anazi est leader ingénierie fiabilité dans consulting services Saudi Aramco. Il a 25+ ans expérience technique et doctorat génie mécanique.
Technologie de l'Internet des objets
- Pourquoi la sécurité des données Cloud devient programmable
- Exploiter les données dans l'Internet de la fiabilité : stratégies pour une gestion efficace
- L'excellence en fiabilité : la clé d'opérations plus sûres et plus rentables
- Perspectives futures : faire progresser l'IIoT industriel pour l'excellence de production
- Libérer la puissance de la donnée visuelle dans l'écosystème IdO
- Comment l'IA amplifie la puissance de l'Internet des objets
- Construire des fondations pour le succès de la data science industrielle
- Edge AI : Pourquoi le traitement se déplace vers la couche périphérique
- Automatisation : la seule voie pour la manufacture US