



BrainChip lance les kits de développement neuromorphiques Akida pour l'IA en périphérie
BrainChip, un fournisseur leader d'IP de calcul neuromorphique, a introduit deux nouveaux kits de développement mettant en vedette son SoC neuromorphique Akida lors de la récente conférence Linley Fall Processor Conference. Les kits se présentent sous format PC Shuttle x86 et design Raspberry Pi basé sur Arm, offrant aux développeurs des plateformes prêtes à l'emploi pour construire et tester des applications de réseaux de neurones à impulsions (SNN). Le silicium Akida est également disponible pour l'intégration dans des designs personnalisés.
L'architecture neuromorphique d'Akida délivre une IA ultra-basse consommation en imitant le traitement événementiel du cerveau. Contrairement aux modèles d'apprentissage profond conventionnels, les SNN transmettent l'information via des impulsions discrètes qui encodent à la fois des motifs spatiaux et des séquences temporelles. Ce domaine événementiel est idéal pour les appareils edge qui nécessitent une inférence temps réel, consciente de la puissance, à partir de flux de capteurs.
En plus des charges de travail SNN natives, les unités de traitement neuronal (NPU) de BrainChip peuvent exécuter des réseaux de neurones convolutifs (CNN) après les avoir convertis au domaine événementiel. La conversion, effectuée par le flux logiciel MetaTF, préserve l'extraction de caractéristiques des CNN tout en permettant l'apprentissage sur puce par plasticité dépendante du timing des impulsions — éliminant le besoin de réentraînement basé sur le cloud.
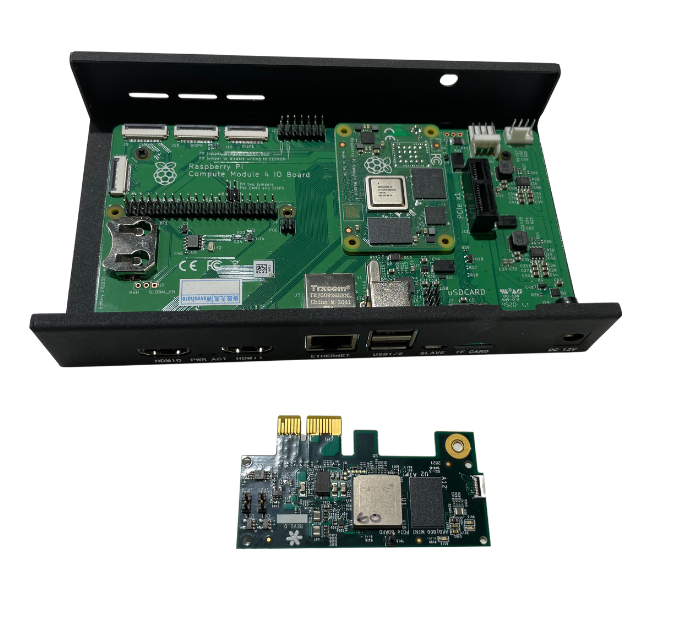
Les cartes de développement BrainChip sont disponibles pour PC Shuttle x86 ou Raspberry Pi. (Source : BrainChip)
« Akida est prêt pour la technologie neuromorphique de demain, mais il résout déjà les défis de l'IA edge d'aujourd'hui », a déclaré Anil Mankar, cofondateur et directeur du développement de BrainChip, à EE Times. « Notre logiciel d'exécution élimine la courbe d'apprentissage autour des SNN et du domaine événementiel, permettant aux développeurs familiers avec TensorFlow ou Keras de porter des modèles et d'évaluer puissance et précision directement sur notre matériel. »
Mankar a expliqué que les CNN excellent à extraire des caractéristiques de grands jeux de données. En convertissant les couches CNN en opérations basées sur les événements — sauf pour la couche de classification finale — Akida conserve cette capacité tout en ajoutant l'apprentissage par timing d'impulsions. Les SNN natifs peuvent utiliser une précision d'un bit, tandis que les CNN convertis emploient généralement des impulsions de 1, 2 ou 4 bits. L'outil de quantification de BrainChip aide les concepteurs à choisir la largeur de bit appropriée par couche. Par exemple, un modèle MobileNet V1 quantifié à 4 bits a atteint 93,1 % de précision sur une tâche de classification à 10 classes.
La conversion au domaine événementiel génère aussi des économies d'énergie significatives grâce à la parcimonie. Dans le domaine événementiel, seules les valeurs d'activation non nulles génèrent des impulsions, et le NPU ne traite que ces événements. Pour un CNN typique, environ la moitié des activations sont nulles après ReLU, donc l'implémentation basée sur les événements réduit dramatiquement le nombre d'opérations MAC, abaissant la consommation d'énergie.
Des fonctions telles que la convolution, convolution point par point, convolution en profondeur, max pooling et global average pooling peuvent toutes être traduites au domaine événementiel. Le diagramme suivant illustre la réduction des opérations MAC pour une tâche de classification d'objets : le bleu foncé représente le CNN traditionnel, le bleu clair montre l'implémentation Akida domaine événementiel, et le vert indique une régularisation d'activité supplémentaire.
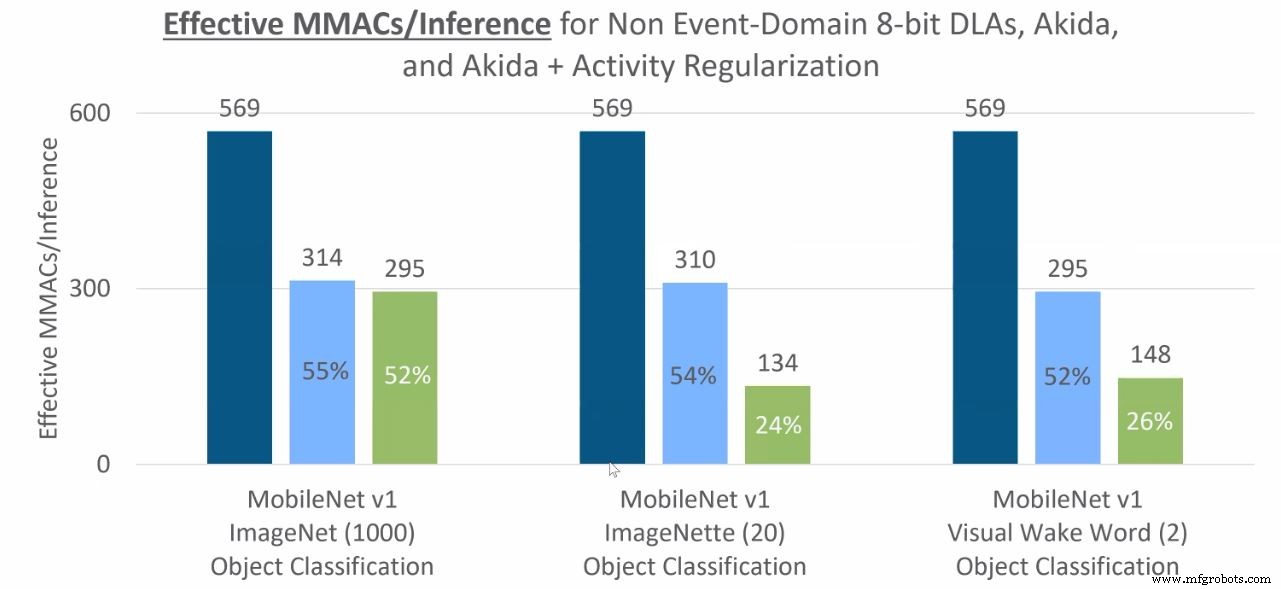
Opérations MAC requises pour l'inférence de classification d'objets (bleu foncé = CNN domaine non-événementiel, bleu clair = domaine événementiel/Akida, vert = domaine événementiel avec régularisation d'activité supplémentaire). (Source : BrainChip)
Dans un benchmark réel, un modèle de détection de mots-clés s'exécutant sur la carte Akida après quantification 4 bits a consommé seulement 37 µJ par inférence (équivalent à 27 336 inférences par seconde par watt). Le modèle a atteint 91,3 % de précision tout en fonctionnant à une horloge modeste de 5 MHz.
Agnostique aux capteurs
L'IP NPU de BrainChip et la puce Akida sont agnostiques au réseau et supportent une large gamme de capteurs. Qu'il s'agisse de traiter des images, audio, données olfactives, gustatives ou tactiles, le même matériel peut gérer à la fois les CNN (via conversion) et les SNN natifs.
Chaque nœud NPU contient 100 Ko de SRAM local pour paramètres, activations et tampons d'événements, et jusqu'à quatre nœuds peuvent être regroupés en réseau maillé. Les réseaux s'étendant sur plusieurs nœuds communiquent directement entre couches sans intervention CPU, bien que certaines charges de travail non-CNN nécessitent encore le support CPU. L'IP peut s'étendre à 20 nœuds, permettant à des modèles plus grands de s'exécuter en passes multiples sur du matériel plus petit.
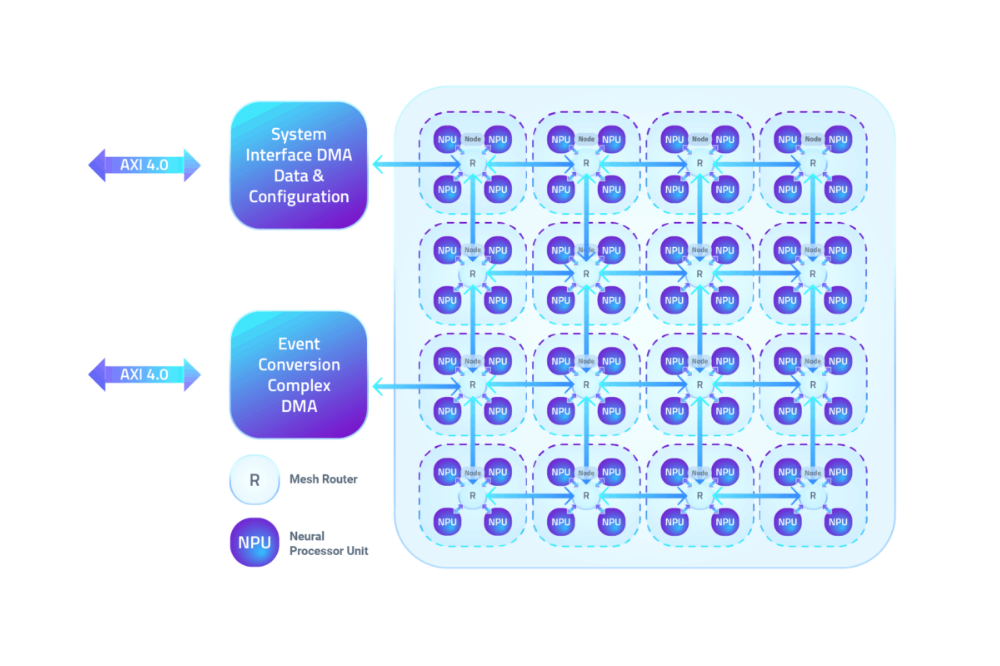
Nœuds de quatre NPU BrainChip connectés par un réseau maillé. (Source : BrainChip)
Une vidéo de démo a montré Akida dans un habitacle de véhicule : une puce détectait simultanément le conducteur, reconnaissait son visage et identifiait sa voix. La détection de mots-clés nécessitait seulement 600 µW, la reconnaissance faciale 22 mW, et l'inférence visuelle de mot de réveil 6-8 mW — démontrant l'adéquation de la puce pour l'IA edge automobile.
Rob Telson, vice-président des ventes mondiales de BrainChip, a noté que le procédé TSMC 28 nm d'Akida fournit une base solide, et les clients IP peuvent passer à des nœuds plus fins pour une efficacité énergétique encore plus grande. Il a également mis en avant l'apprentissage sur puce pour la reconnaissance faciale : avec suffisamment de neurones dans la couche finale, un système peut passer de la reconnaissance de 10 visages à plus de 50 avec un apprentissage one-shot, éliminant la dépendance au cloud.
Clients à accès anticipé
BrainChip emploie 55 personnes à travers son siège à Aliso Viejo, CA, et ses bureaux de conception à Toulouse, France ; Hyderabad, Inde ; et Perth, Australie. La société détient 14 brevets, est cotée à la bourse australienne et listée sur le marché OTC américain.
Les clients à accès anticipé incluent NASA, automobile, militaire, aérospatial, médical (ex: détection COVID-19 olfactive), et entreprises d'électronique grand public. Renesas a licencié un IP NPU Akida 2 nœuds pour intégration dans de futures unités microcontrôleur visant l'analyse de données de capteurs dans les déploiements IoT.
L'IP Akida et le silicium sont disponibles maintenant.
>> Cet article a été publié à l'origine sur notre site sœur, EE Times.
Contenus connexes :
- Startup intègre 1000 cœurs RISC-V dans puce accélérateur IA
- Puce IA cible appareils edge basse consommation
- SoC IA gèrent flux vidéo multiples
- Construire la sécurité dans un SoC IA en utilisant fonctionnalités CPU avec extensions
- Architectures microcontrôleur évoluent pour l'IA
Pour plus d'Embedded, abonnez-vous à la newsletter hebdomadaire d'Embedded.
Embarqué
- Pourquoi Linux propulse le cloud : guide complet
- 10 Avantages Essentiels du Cloud Computing pour les Entreprises Modernes
- Cloud Computing vs On-Premise : quelle infrastructure convient le mieux à votre entreprise ?
- Groupes de drapeaux d'événement dans Nucleus SE : Guide d'introduction à la configuration et l'utilisation des API
- Puces neuromorphiques : la prochaine frontière pour la performance IA
- Kontron dévoile COM HPC : nouveau standard embarqué haute performance
- STMicroelectronics lance kits développement LoRa à $99 pour déploiement IoT rapide
- Kit de développement RSL10 Mesh : réseaux BLE ultra-basse consommation simplifiés
- ams dévoile les kits NanoVision et NanoBerry propulsés par le capteur NanEyeC 1 mm × 1 mm