



Le fog computing expliqué : combler le cloud et l'edge pour des données plus rapides et plus intelligentes
Avant d'expliquer le fog computing, nous devons nous assurer que nous avons une solide compréhension du cloud computing, un concept qui est devenu un terme courant dans notre vocabulaire.
Le cloud computing fait référence à l'accès à des ressources informatiques « à la demande », de la puissance de calcul et du stockage de données sans avoir besoin de matériel sur site ni de gestion active par l'utilisateur. La figure 1 ci-dessous montre une représentation d'architecture très générique de la façon dont les entreprises multi-sites déploient une solution cloud industrielle.
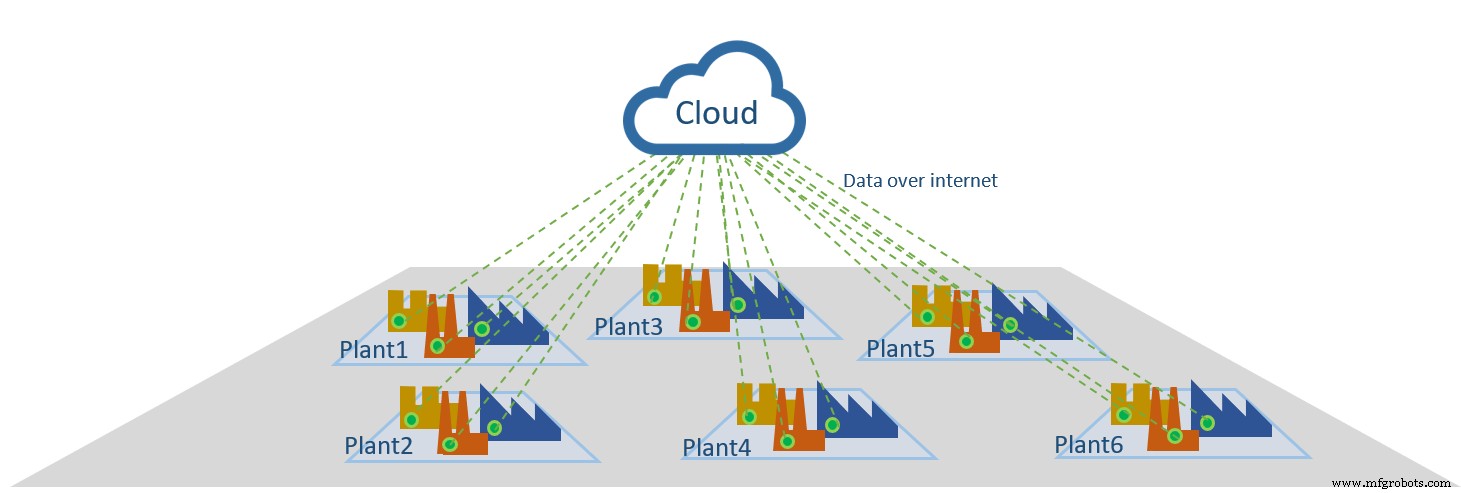
Figure 1 : architecture cloud computing. Avec l'aimable autorisation de l'auteur.
Au sein d'une architecture cloud, plusieurs modèles d'adoption différents sont devenus très populaires — les plus notables étant l'infrastructure en tant que service (IaaS), la plateforme en tant que service (PaaS) et le logiciel en tant que service (SaaS). La façon dont vous souhaitez tirer parti du cloud pour votre organisation vous aidera à déterminer quel modèle conviendra le mieux.
L'IEEE 1934 définit le fog computing comme « une architecture horizontale au niveau système qui distribue les ressources et services de calcul, de stockage, de contrôle et de mise en réseau n'importe où le long du continuum cloud-vers-objets. Il prend en charge les verticales industrielles et les domaines d'application, permet aux services et applications d'être distribués plus près des sources productrices de données, et s'étend des objets, par les bords du réseau, à travers le cloud et à travers de multiples couches de protocoles. »
En bref, cela signifie que le fog computing se concentre sur le déplacement de certaines ressources de cloud computing loin du cloud et plus près des appareils individuels. Avec le fog computing, un ordinateur supplémentaire est placé dans chaque usine, généralement au niveau du LAN, pour concentrer (ou agréger) les données localement. Il régule quelles informations doivent être traitées localement et lesquelles peuvent être déchargées vers le cloud, agissant comme un médiateur entre les appareils locaux et les serveurs distants. Cela aide généralement à deux choses :
- Réduction du nombre de connexions cloud nécessaires
- Traitement local plus rapide — comme montré dans la Figure 2, l'ordinateur fog envoie des données consolidées et significatives vers le cloud, où les informations de chaque usine sont analysées en combinaison avec les autres usines
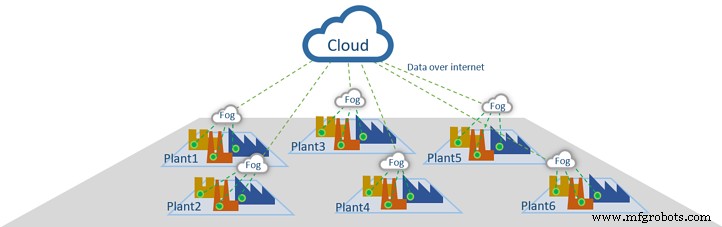
Figure 2 : architecture fog computing. Avec l'aimable autorisation de l'auteur.
Quelles sont les différences entre fog computing et edge computing ?
En plus du fog computing, vous avez peut-être entendu un autre terme utilisé : edge computing. Sont-ils la même chose ? Sinon, quelle est la différence ?
Selon qui vous demandez, ou avec quelle entreprise vous travaillez, la réponse peut être très différente. Certains affirment que le fog et l'edge computing sont la même chose, tandis que d'autres affirment qu'ils sont assez différents.
Le fog et l'edge computing, du moins dans les applications industrielles et manufacturières, sont des systèmes qui tentent de collecter et traiter les données des actifs/appareils locaux plus efficacement que les architectures cloud traditionnelles. La différence clé entre ces idées réside dans l'endroit où le traitement et l'« intelligence » ont finalement lieu.
Par exemple, si un capteur peut stocker ses valeurs brutes mesurées une fois par minute localement pendant 30 jours, il ne transmettra peut-être que des données de résumé à une ressource de calcul (serveur) sur le réseau local une fois par heure, et une fraction de ces données de capteur pourrait être transmise aux ordinateurs cloud pour traitement. Cela réduit considérablement la transmission de données, et permet de rassembler un historique détaillé si quelque chose d'intéressant est capturé par le capteur.
Votre définition de l'edge versus le fog dépend de l'endroit où vous tracez la frontière autour de la collecte de données brutes, du stockage des données et de l'utilisation des ressources computationnelles.
Avantages du fog computing
Considérez l'exemple ci-dessus. Avez-vous imaginé la quantité de puissance de calcul nécessaire pour agréger, analyser et calculer la sortie souhaitée de 100 capteurs ? Et 10 000 capteurs ? Le stockage requis, le trafic de données et la bande passante réseau augmentent exponentiellement plus on ajoute de sources de données.
Le fog computing vous aide à :
- Réduire la latence réseau et le trafic de données
- Augmenter la bande passante réseau effective
- Isoler verticalement le réseau
- Faire évoluer le déploiement facilement et efficacement
- Contrôler la confidentialité et la sécurité des données
En adaptant les technologies de fog computing, vous pouvez construire et déployer des solutions IIoT « intelligentes » et efficaces par petites étapes. Cependant, au lieu de penser en termes de « cloud vs fog vs edge », vous devriez reformuler votre réflexion autour de la question : « Quelle combinaison est la mieux adaptée à mes besoins particuliers ? » De cette façon, ce n'est pas vu comme une décision « l'un ou l'autre », mais plutôt comme une adaptation collaborative de différentes technologies et architectures.
Technologie industrielle
- Meilleurs cours Cloud Computing 2026 : des fondamentaux AWS au MicroMasters du Maryland
- Comprendre les circuits de filtres : de l'audio au conditionnement de puissance
- Qu'est-ce que l'acier A2 ? Une nuance d'acier à outils polyvalente et rentable pour applications industrielles et menuiserie
- Comprendre l'impédance de trace : Pourquoi c'est important dans la conception PCB
- Comprendre l'efficacité de ligne : Métriques clés pour la production PCB
- Comprendre les légendes PCB : objectif, placement et avantages
- Internet industriel des objets (IIoT) : définition, portée et impact industriel
- Comprendre les interfaces homme-machine (IHM) dans l'industrie moderne
- Qu'est-ce que l'informatique quantique ? Guide pour débutants