



MLCommons dévoile MLPerf Inference Benchmark 2024 : résultats Edge, Data Center, Mobile et Notebook
MLCommons, l'organisation indépendante qui organise la suite de benchmarks MLPerf, a annoncé le dernier tour de scores MLPerf Inference. Les nouveaux résultats sont soigneusement divisés en quatre classes d'appareils — centre de données, edge, mobile et notebook — facilitant la comparaison des performances par acheteurs, vendeurs et chercheurs à travers des charges de travail réelles.
Segmentation par classe d'appareil
La séparation des scores par classe d'appareil reflète les facteurs de forme distincts et les profils de performance qui caractérisent chaque marché. Comme David Kanter, directeur exécutif de MLCommons l'a dit à EE Times, « Si vous parlez d'un notebook, il tourne probablement sous Windows ; si vous parlez d'un smartphone, vous tournez probablement sous iOS ou Android. » En isolant les résultats mobile et notebook, le benchmark fournit des insights plus clairs sur les capacités des accélérateurs les plus pertinents pour chaque cas d'usage.
Modèles à l'état de l'art
Contrairement au tour précédent, qui se concentrait principalement sur les tâches de vision, le benchmark actuel incorpore cinq modèles modernes, de qualité production :
- DLRM – un moteur de recommandation à grande échelle
- 3D-UNet – un modèle d'imagerie médicale pour la détection de tumeurs dans les IRM
- RNN-T – un moteur de reconnaissance vocale
- BERT – un transformateur de traitement du langage naturel
- MobileNetEdge, SSD-MobileNetv2, Deeplabv3 et Mobile BERT – variantes optimisées mobile des précédents
Ces choix ont été pilotés par un conseil consultatif incluant des experts de l'industrie des domaines de recommandation, imagerie médicale et parole, assurant que les benchmarks reflètent les charges de travail les plus exigeantes en production aujourd'hui.
Performance centre de données
Comme prévu, les GPU Nvidia dominent la classe centre de données. En fait, 85 % des soumissions totales étaient propulsées par du matériel Nvidia, et l'entreprise a balayé chaque catégorie qu'elle a entrée. Le benchmark montre un écart de performance qui se creuse : sur un modèle de vision par ordinateur de base, le Nvidia A100 délivre environ 30× le débit d'un CPU Intel Cooper Lake, et 237× plus rapide qu'un CPU comparable sur les charges de travail de systèmes de recommandation. Paresh Kharya, directeur senior de la gestion produit chez Nvidia, souligne qu'un seul DGX-A100 peut égaler la performance d'un cluster CPU de 1 000 nœuds pour les tâches de recommandation, offrant une valeur tremende pour l'échelle.
Le seul participant non-CPU, non-GPU dans cette classe était l'accélérateur Zebra de Mipsology, tournant sur un FPGA Xilinx Alveo U250. Zebra a atteint 4 096 requêtes ResNet par seconde en mode serveur versus 5 563 pour un Nvidia T4, et 5 011 échantillons par seconde hors ligne comparé à 6 112 pour le T4.
Dans la catégorie recherche-développement, RecAccel de la société taïwanaise Neuchips — un accélérateur basé FPGA pour DLRM — a performé au niveau ou en dessous des CPUs Intel Cooper Lake et est resté en deçà des résultats Nvidia. Ces prototypes de stade précoce démontrent la largeur du matériel IA émergent, même s'ils ne sont pas encore commercialement disponibles.
Résultats du tier Edge
Les systèmes Edge étaient largement propulsés par les puces Nvidia A100, T4, AGX Xavier et Xavier NX. Le design de référence de Centaur Technology, avec son processeur x86 propriétaire et un coprocesseur IA séparé, a battu le Tesla T4 de Nvidia en latence single-stream ResNet mais a traîné sur le débit. Le cabinet de conseil britannique dividiti a présenté une large gamme de scores — de Raspberry Pi à Nvidia AGX Xavier — soulignant comment les choix de système d'exploitation et l'utilisation d'accélérateurs sur puce peuvent influencer les résultats.
Nouveaux entrants du pool recherche-développement incluaient la société russe IVA Technologies et la startup coréenne Mobilint. Bien qu'aucun n'ait atteint une performance révolutionnaire, leur inclusion montre que les accélérateurs prototypes atteignent un niveau de maturité logicielle qui justifie le benchmarking contre des solutions commerciales.
Benchmarks Mobile et Notebook
La classe mobile a vu trois soumissions comparables : MediaTek Dimensity 820 (dans le Xiaomi Redmi 10X 5G), Qualcomm Snapdragon 865+ (testé sur un Asus ROG Phone 3), et Samsung Exynos 990 (utilisé dans le Galaxy Note 20 Ultra). Samsung a mené en classification d'image et NLP, MediaTek a excellé en détection d'objets, et Samsung a encore surpassé en segmentation d'image. Les résultats illustrent qu'aucun SoC unique ne domine à travers toutes les tâches, soulignant l'importance de l'optimisation spécifique à la charge de travail.
La catégorie notebook contenait un unique design de référence Intel avec le futur GPU Xe-LP. Bien que l'ensemble de données limité rende la comparaison détaillée difficile, le Xe-LP a atteint un débit 2,5× supérieur au meilleur SoC mobile sur la segmentation d'image (DeeplabV3) et 1,15× meilleur sur la détection d'objets (SSD-MobileNetv2).
Regard vers l'avenir
Kanri souligne l'engagement de MLCommons envers la diversité dans l'écosystème de benchmark. L'organisation encourage la participation non-Nvidia, non-Intel et des petites entreprises, avec une division ouverte qui permet à tout réseau ou modèle d'être testé. « Nous travaillons aussi sur l'ajout d'une dimension de mesure de puissance pour le prochain tour », dit Kanter, invitant la communauté à aider à développer l'outillage nécessaire.
Pour une liste complète et détaillée des résultats MLPerf Inference, cliquez ici.
Source : EE Times
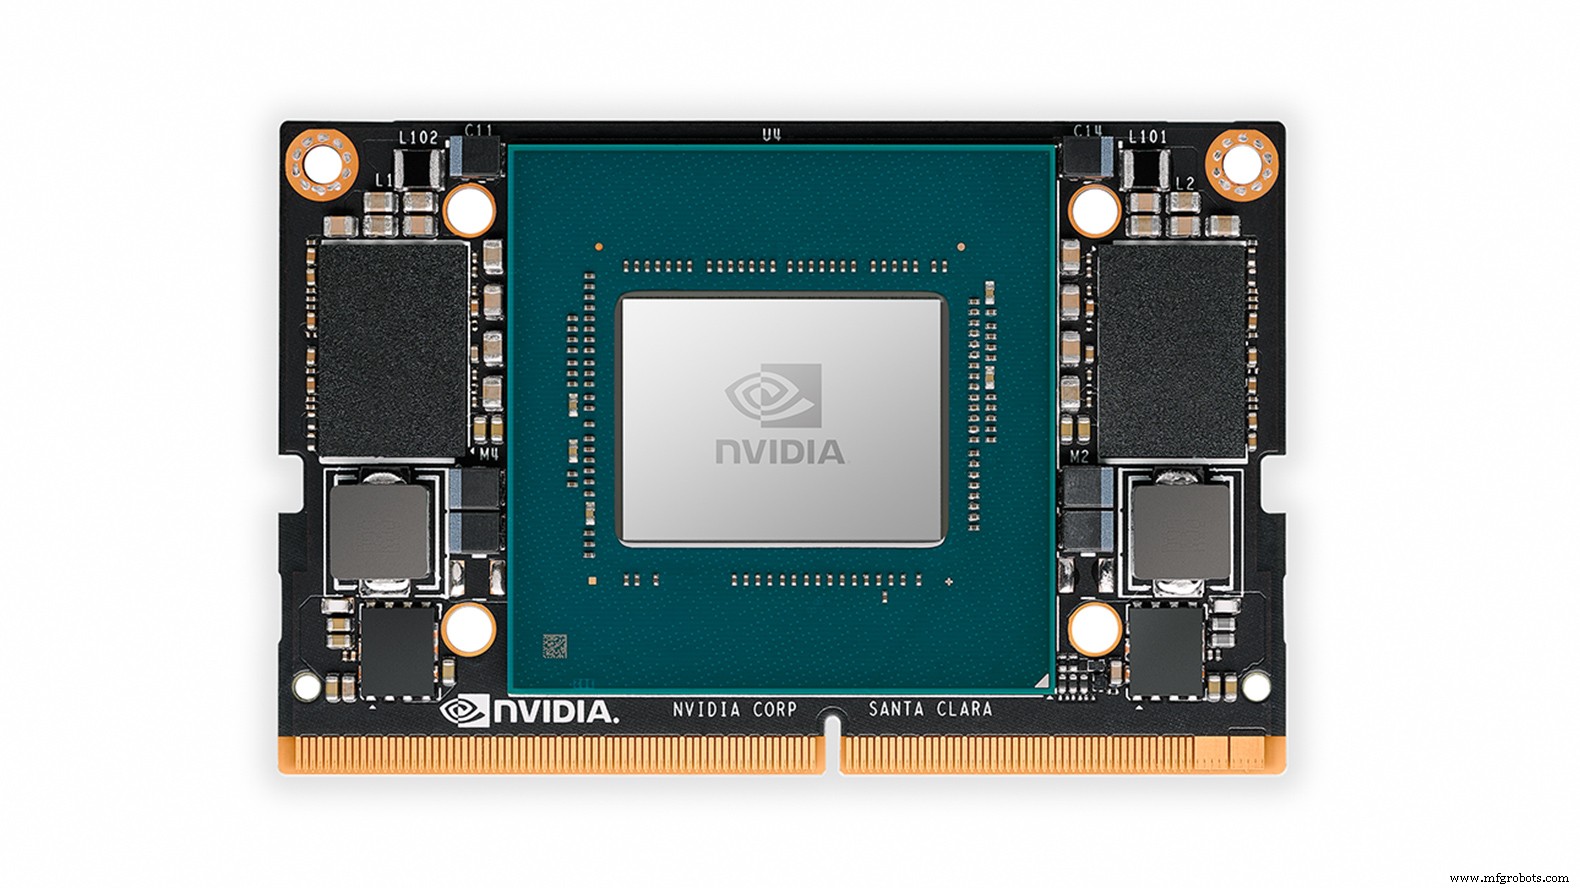
Résultats Edge dominés par les GPU Nvidia, incluant le Jetson Xavier NX
Embarqué
- STMicroelectronics LSM6DSOX : Capteur Inertiel Machine-Learning pour Suivi Activité Précis et Économe en Énergie
- ADLINK et Charles Industries dévoilent la première solution micro-edge IA/ML complète pour déploiements 5G sur poteaux
- NXP accélère l'IA en périphérie avec la boîte à outils eIQ
- Edge AI : Pourquoi le traitement se déplace vers la couche périphérique
- Booster la productivité avec les fonctionnalités avancées des centres d'usinage verticaux
- Booster l'efficacité de l'edge computing avec un réseau Wi-Fi robuste
- Le Machine Learning accélère la sécurité des pipelines : Détection de défauts en temps réel économise 10M$
- Edge Computing : Le Nouveau Cœur Battant de l'Ère du Cloud
- Johnford ST-80 CH : Centre de tournage CNC de précision pour industries lourdes