



Les microcontrôleurs propulsent la prochaine vague d'Edge AI
Jusqu'à récemment, l'apprentissage machine — et même l'apprentissage profond — était considéré comme l'apanage de serveurs puissants, avec entraînement et inférence gérés par passerelles, serveurs edge, ou centres de données. Cette vision tenait car le passage vers distribution du calcul entre cloud et edge était encore naissant. Aujourd'hui, percées de l'industrie et du monde académique ont renversé ce paradigme.
Par conséquent, les processeurs haute performance délivrant des trillions d'opérations par seconde (TOPS) ne sont plus prérequis pour charges de travail ML. Les microcontrôleurs modernes, nombreux équipés d'accélérateurs ML dédiés, apportent maintenant l'inférence intelligente directement aux dispositifs edge.
Ces contrôleurs exécutent les tâches ML efficacement, à coût et puissance minimaux, se connectant au cloud seulement quand nécessaire. En essence, microcontrôleurs avec accélérateurs ML embarqués marquent le prochain saut pour doter capteurs — microphones, caméras, moniteurs environnementaux — d'intelligence sur dispositif, pierre angulaire de la chaîne de valeur IoT.
Jusqu'où va l'edge ?
L'edge est communément défini comme le point le plus éloigné du cloud dans un réseau IoT, souvent représenté par une passerelle avancée ou serveur edge. En réalité, l'edge se termine aux capteurs eux-mêmes — ceux positionnés près de l'utilisateur final. Il est donc logique d'embarquer autant d'analytique que possible directement dans ces capteurs, rôle pour lequel les microcontrôleurs sont parfaitement adaptés.
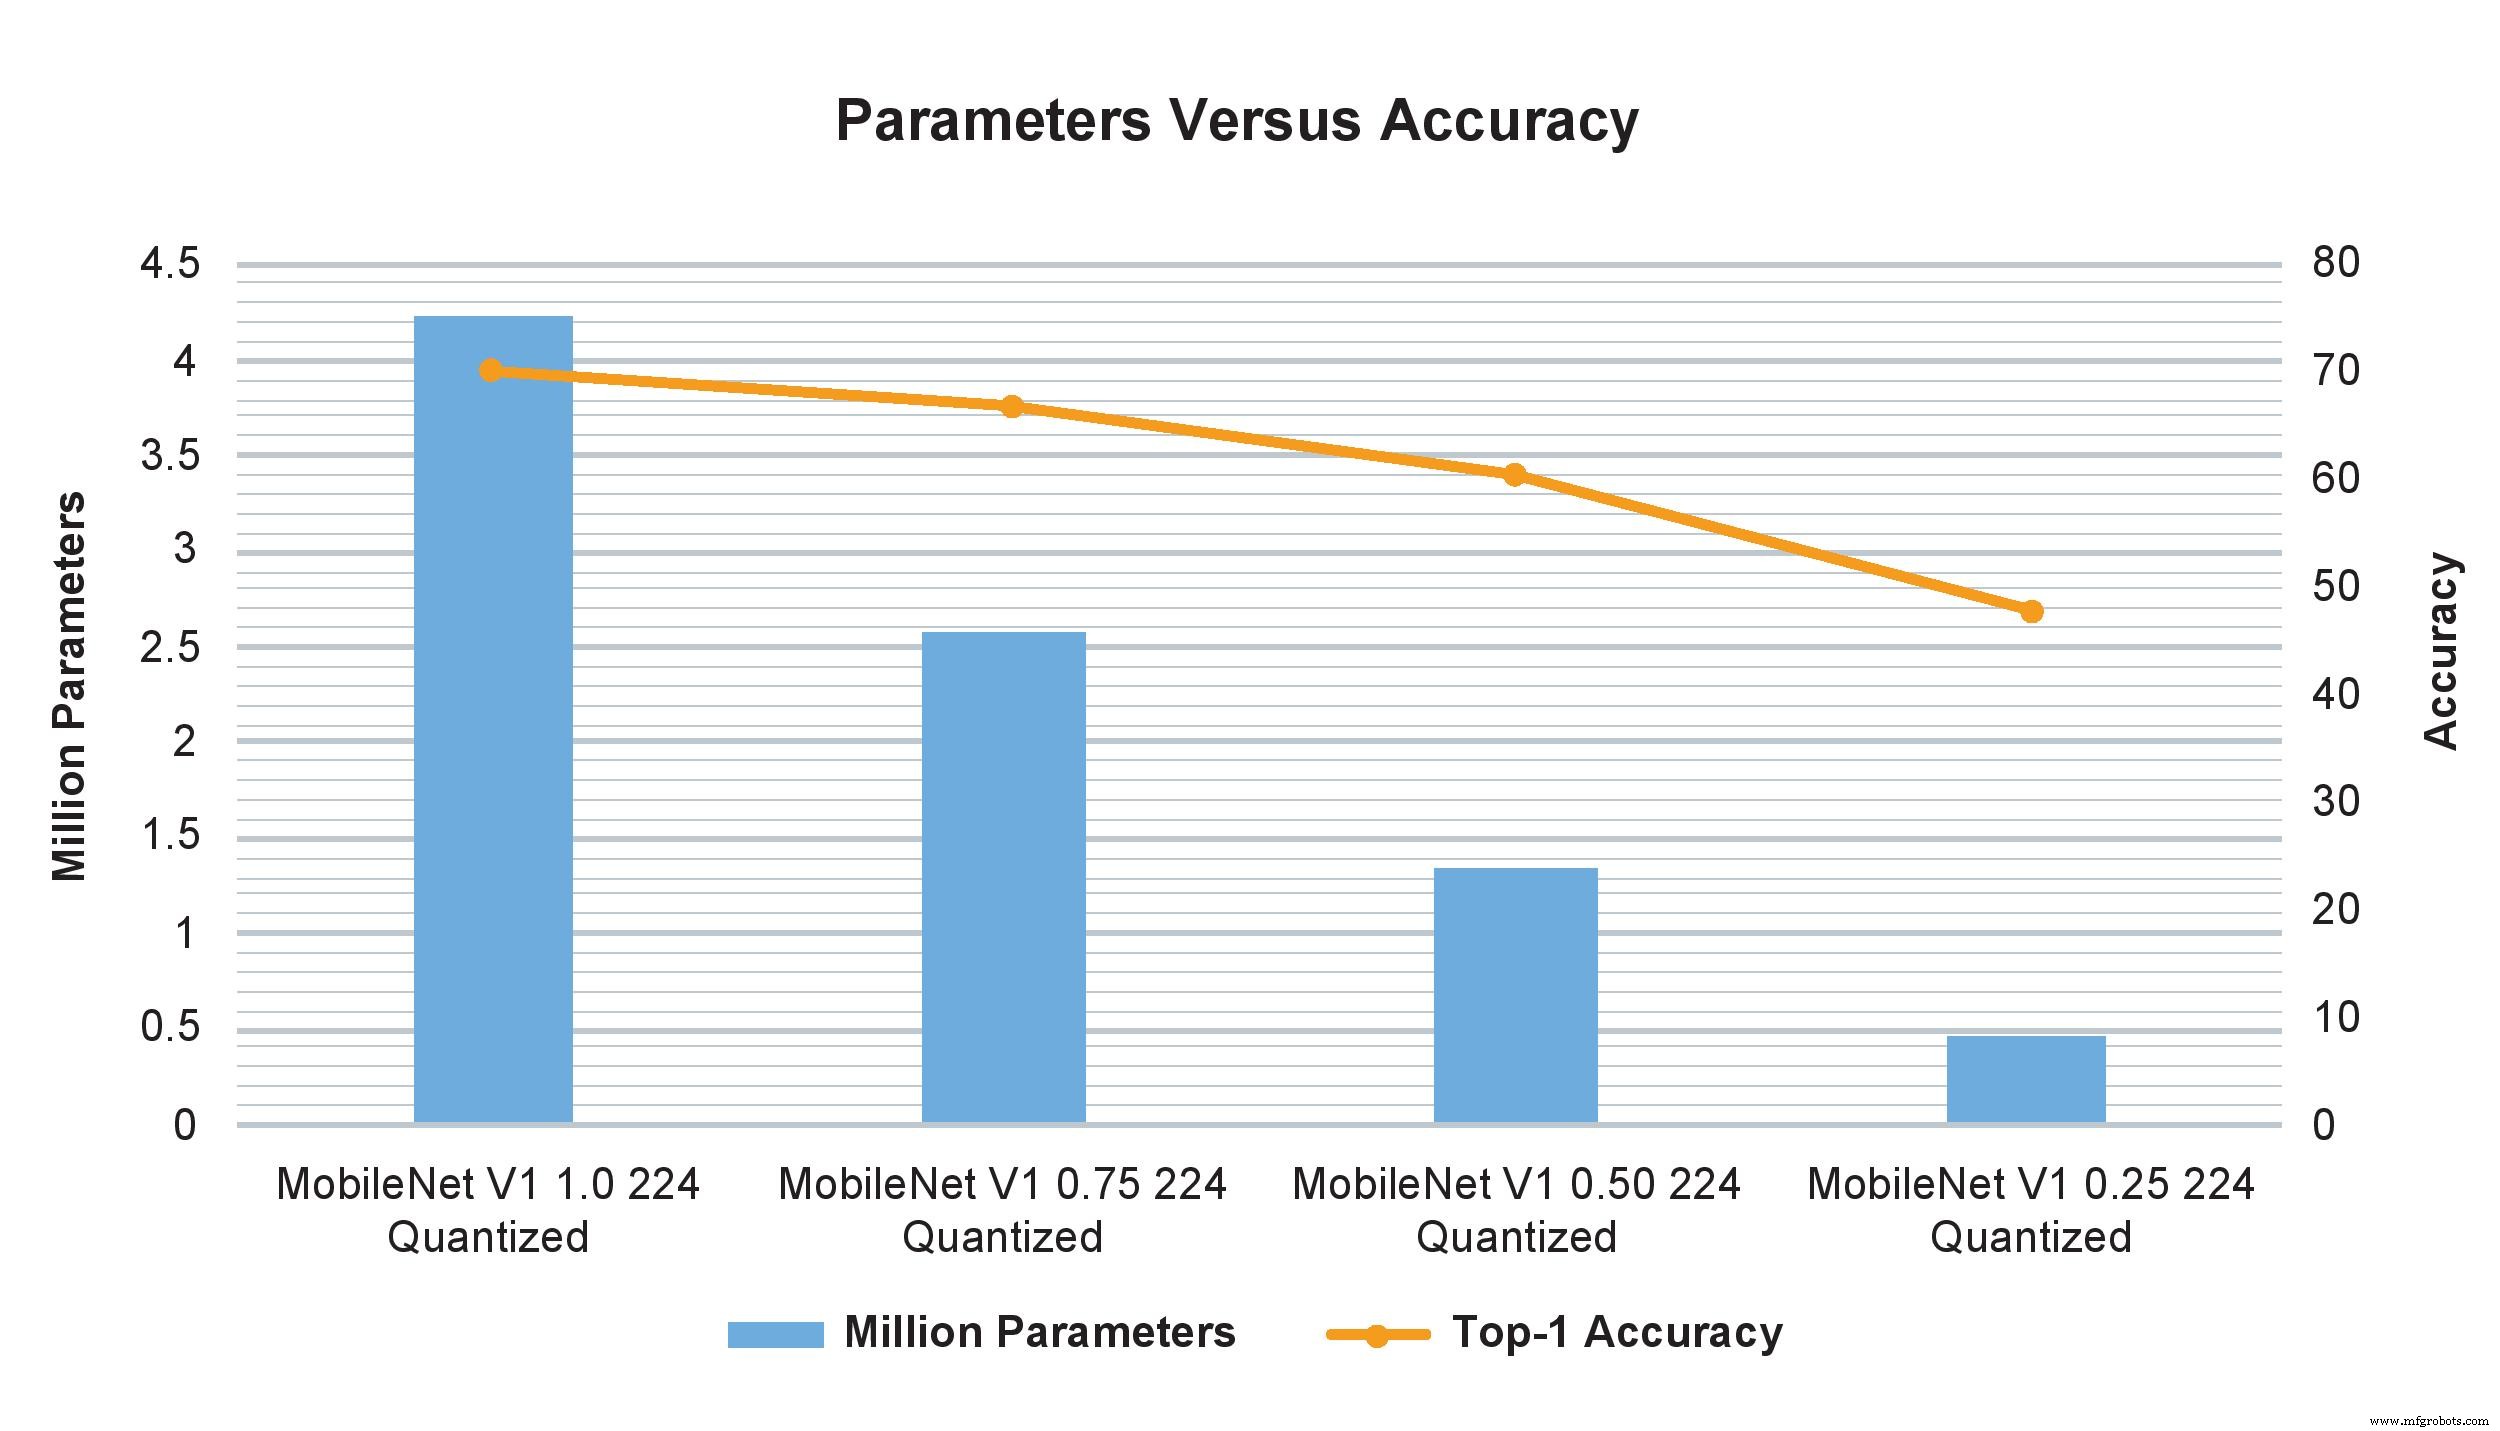
Exemples modèle MobileNet V1 de multiplicateurs de largeur variés montrent impact drastique sur nombre paramètres, calculs, précision. Cependant, changer multiplicateur largeur de 1.0 à 0.75 affecte minimement précision TOP-1 mais impacte significativement paramètres et calculs (Image : NXP)
Les ordinateurs monocarte peuvent en effet effectuer du traitement edge, délivrant performance impressionnante et, quand clusterisés, approchant supercalculateurs petite échelle. Pourtant ils restent trop encombrants et coûteux pour les milliers d'unités demandées par déploiements large échelle. De plus, ils requièrent alimentation DC externe — souvent indisponible en environnements contraints — alors qu'un MCU ne tire que des milliwatts et peut fonctionner sur piles bouton ou quelques cellules solaires.
Par conséquent, le domaine du ML basé microcontrôleur — connu comme TinyML — a explosé en popularité. TinyML vise à activer l'inférence, et éventuellement l'entraînement, sur petits dispositifs basse consommation, ressources contraintes, particulièrement microcontrôleurs, au lieu de compter sur plateformes plus grandes ou le cloud. Cela nécessite modèles réseaux de neurones compacts qui tiennent dans budgets limités de traitement, stockage, bande passante tout en préservant performance.
Les modèles optimisés ressources permettent aux dispositifs de capturer données capteur adéquates pour leurs tâches tout en affinant précision et réduisant demandes ressources. Par conséquent, bien que certaines données puissent encore être transmises — directement au cloud ou via passerelle edge — le volume est significativement plus bas car analyse préliminaire déjà exécutée sur le dispositif.
Un cas d'usage TinyML commun est un système détection d'objets caméra qui peut capturer images haute résolution mais fait face à stockage limité, nécessitant réduction résolution. Avec analytique sur dispositif, la caméra capture seulement objets d'intérêt, préservant haute résolution pour frames sélectionnées. Ce niveau de fonctionnalité — autrefois réservé à matériel puissant — est maintenant réalisable sur microcontrôleurs grâce à TinyML.
Petit mais puissant
Bien que TinyML soit un domaine naissant, il délivre déjà inférence impressionnante — et de plus en plus entraînement — performance sur microcontrôleurs modestes, avec perte de précision négligeable. Succès récents couvrent reconnaissance vocale et faciale, traitement langage naturel commandes vocales, et exécution simultanée de multiples algorithmes vision sophistiqués.
Pratiquement, un microcontrôleur sous 2 $, avec cœur Arm Cortex-M7 500 MHz et 28 Ko–128 Ko mémoire, peut délivrer performance nécessaire pour rendre capteurs véritablement intelligents.
Même à ce coût, tels microcontrôleurs intègrent fonctionnalités sécurité robustes (AES-128), supportent multiples types mémoire externe, Ethernet, USB, SPI, et interfaces pour gamme de capteurs, incluant Bluetooth, Wi-Fi, SPDIF, et I²C audio. Une légère hausse de prix donne typiquement Cortex-M7 1 GHz, Cortex-M4 400 MHz, 2 Mo RAM, et accélération graphique, tout en tirant seulement quelques milliampères d'une alimentation 3,3 V.
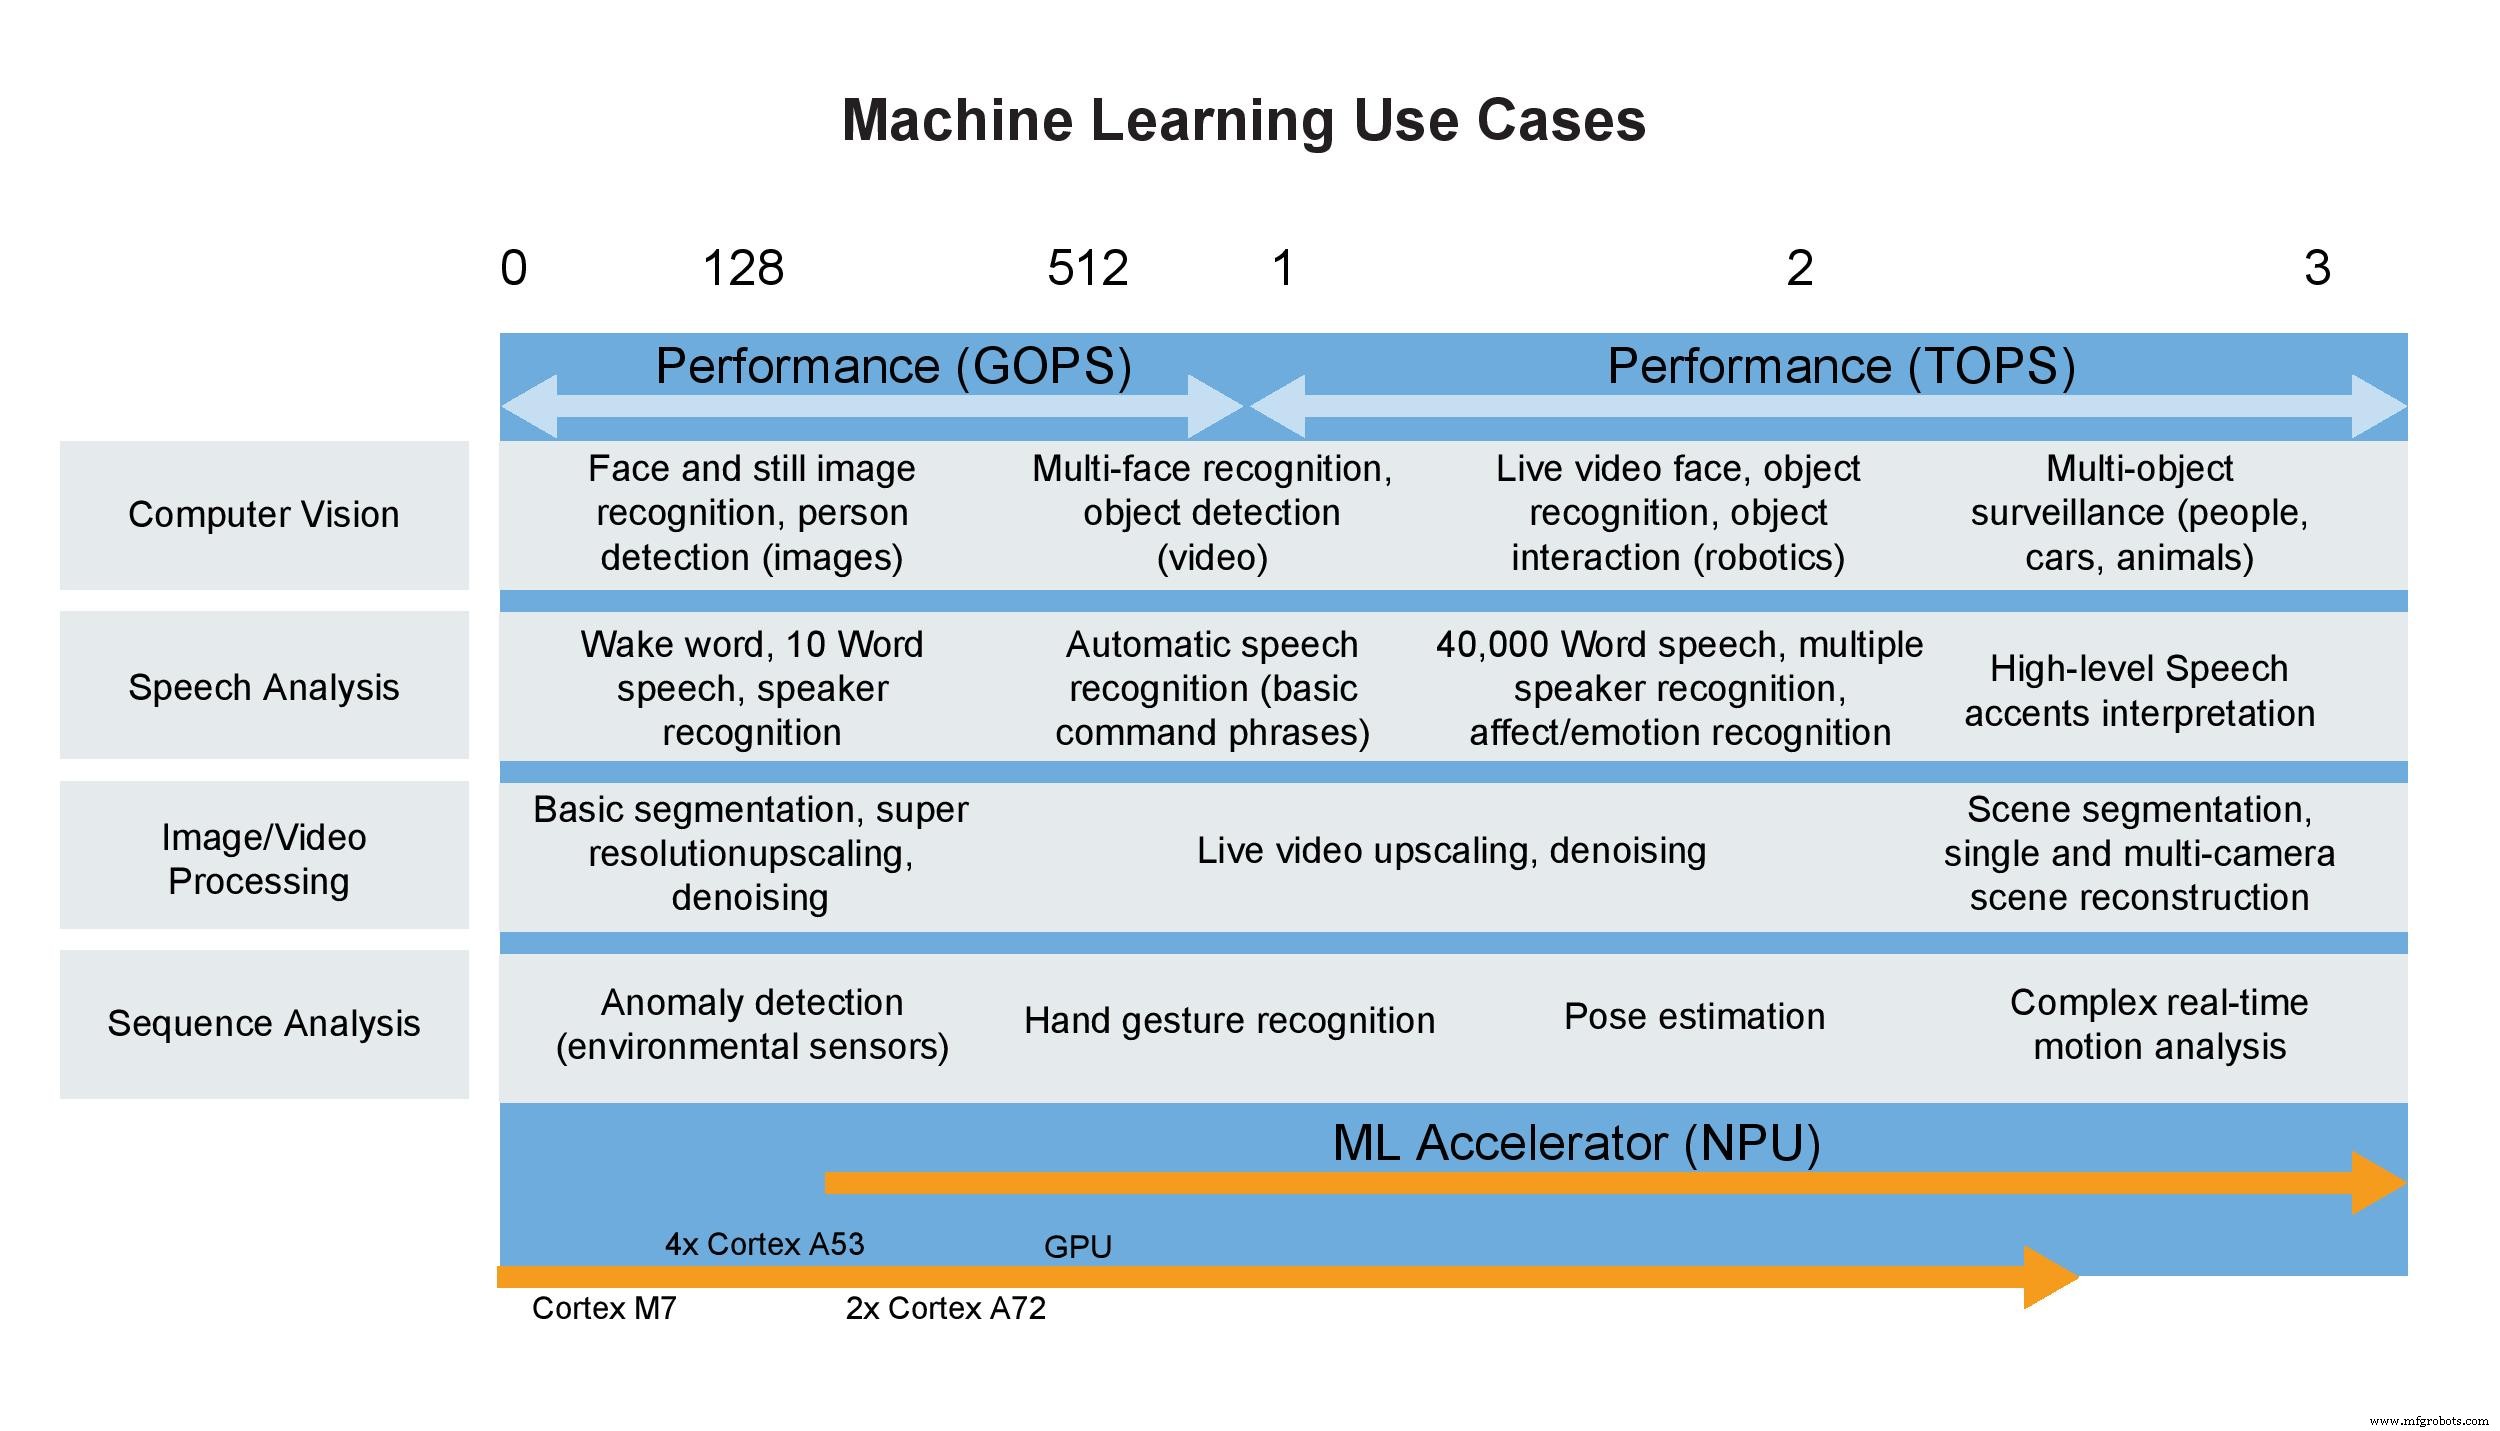
Cas d'usage apprentissage machine (Image : NXP)
Quelques mots sur les TOPS
Les fabricants benchmarkent souvent accélérateurs réseaux de neurones avec une métrique unique — trillions d'opérations par seconde (TOPS). Bien qu'attrayante, cette figure peut être trompeuse. Elle reflète capacité computationnelle brute en setting labo contrôlé et ignore contraintes pratiques comme bande passante mémoire, overhead CPU, pré/post-traitement données. En déploiements réels, le débit atteignable peut être 50-60 % du TOPS affiché.
De plus, pour microcontrôleurs, qui offrent typiquement 1-3 TOPS, la métrique est encore moins informative. La vraie puissance de ces minuscules dispositifs réside dans leurs processeurs Arm Cortex étroitement intégrés, support opérations entières et flottantes, et capacité à exécuter moteurs d'inférence comme TensorFlow Lite avec empreinte minimale.
Conclusion
La poussée pour exécuter l'inférence directement sur ou adjacent aux capteurs — caméras fixes ou vidéo — s'accélère alors que l'écosystème IoT migre vers traitement edge-centrique. Avancées rapides en accélérateurs réseaux de neurones niveau microcontrôleur consolident fonctionnalité IA avec processeurs applicatifs sans hausse dramique consommation ou taille. Modèles entraînés sur CPUs/GPUs puissants peuvent être affinés avec TensorFlow Lite et déployés sur microcontrôleurs, scalant sans effort pour demandes ML croissantes. Bientôt, même l'entraînement sera faisable sur ces dispositifs, positionnant microcontrôleurs comme concurrents redoutables aux systèmes plus grands, plus coûteux.
> Cet article a été publié à l'origine sur notre site sœur, EE Times.
Embarqué
- Comment le cloud computing alimente l'innovation IA et booste l'efficacité business
- Refroidissement par chambre à vapeur : une solution croissante pour l'électronique à forte dissipation thermique
- La récupération d'énergie RF propulse l'expansion des applications sans fil pilotées par l'IA
- Le rôle croissant de l'USB-C dans la gestion d'énergie pour wearables et dispositifs mobiles
- Murata et Google dévoilent le plus petit module Edge TPU IA : 4 TOPS en puce 10×15×1,5 mm
- ECM3532 : La première carte capteur IA intégrée ultra-basse consommation d'Eta Compute accélère le développement edge
- ADLINK lance NEON‑1000‑MDX : Caméra intelligente Edge AI clé en main pour déploiement vision industriel rapide
- Les robots pilotent l'avenir de l'Industrie 4.0 au NPE
- Comment l'informatique de périphérie révolutionne les déploiements IoT commerciaux