



Technologies mémoire pour l'IA en périphérie : défis et opportunités
L'IA en périphérie (Edge AI) redéfinit notre façon de penser la mémoire. Alors que les charges de travail IA migrent du cloud vers des dispositifs plus proches de l'utilisateur, les systèmes mémoire doivent offrir grande capacité, large bande passante, faible latence et efficacité énergétique tout en restant rentables et fiables.
Il n'existe pas de spécification unique « Edge AI ». Le terme couvre largement toute électronique IA hors cloud central — des centres de données d'entreprise aux véhicules autonomes, infrastructures de villes intelligentes et terminaux IoT.
Scénarios typiques : vision par ordinateur pour voitures autonomes, inférence IA dans portiques de fabrication pour détecter défauts, boîtiers 5G edge sur poteaux surveillant le trafic, téléphones appliquant filtres Snapchat ou assistants vocaux.
Le rôle de la mémoire est uniforme : stocker poids de réseaux neuronaux, code modèle, données d'entrée et activations intermédiaires. Le défi réside dans l'équilibre capacité, bande passante, puissance et coût tout en respectant les contraintes uniques de chaque déploiement.
Centres de données en périphérie
Les centres de données edge servent des domaines critiques en latence : imagerie médicale, finance à haute fréquence, contrôle véhicules autonomes. Ces sites utilisent les mêmes familles mémoire que les serveurs traditionnels — DRAM haute performance, RDIMM grande capacité, et options non volatiles comme NVDIMM.
« La DRAM faible latence est essentielle pour l'entraînement et le développement de modèles IA », note Pekon Gupta, architecte solutions chez Smart Modular Technologies. « Les gros jeux de données demandent des RDIMM ou LRDIMM haute capacité, tandis que les NVDIMM accélèrent les charges de travail écriture-intensive comme la mise en cache et les points de contrôle. »
Pekon Gupta
Les opérateurs télécoms suivent une voie similaire, ajoutant mémoire et calcul aux serveurs edge. Gupta souligne Intel Optane — mémoire non volatile 3D XPoint qui fait le pont entre DRAM et Flash — comme choix convaincant pour charges IA bénéficiant de mémoire persistante haute capacité.
« Les DIMM Optane et NVDIMM servent des buts distincts : Optane excelle pour bases de données en mémoire et gros jeux de données IA persistants, tandis que NVDIMM fournit une mise en cache et un étagement à faible latence », explique Gupta.
Kristie Mann d'Intel rapporte qu'Optane alimente déjà moteurs de recommandation e-commerce, personnalisation vidéo et analytique financière temps réel. Un serveur biprocesseur Xeon Scalable avec mémoire persistante Optane peut héberger jusqu'à 6 To de mémoire utilisable, offrant une alternative rentable aux configurations full-DRAM.
Kristie Mann d'Intel
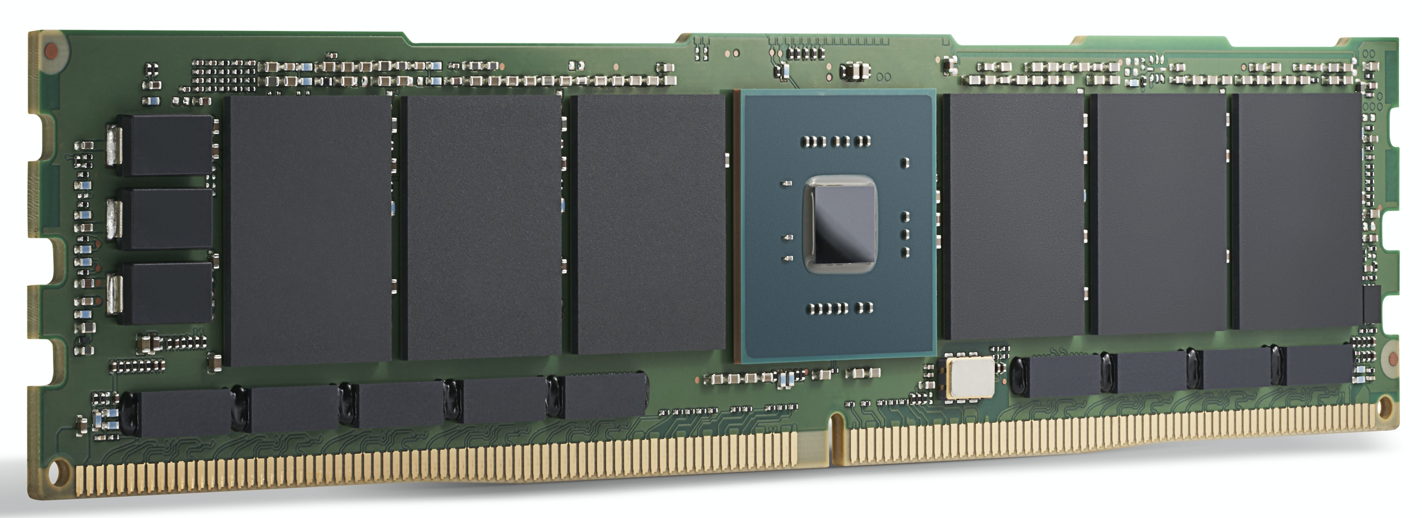
Module Intel Optane série 200. Intel affirme qu'Optane alimente déjà des applications IA aujourd'hui. (Source : Intel)
Accélération GPU
Pour les centres de données edge haute performance, les GPU pilotent le calcul IA. Les choix mémoire incluent GDDR, conçue pour GPU large bande passante, et HBM (mémoire à large bande passante), solution à empilement de dies plaçant plusieurs dies mémoire directement sur le boîtier GPU.
HBM2E délivre jusqu'à 3,6 Gbps par voie, soit 460 Go/s par pile — deux piles approchent 1 To/s. Cette performance, combinée à une faible consommation, fait de HBM le choix mémoire pour les GPU data-center de Nvidia.
GDDR6 offre 18 Gbps par voie et 72 Go/s bande passante. Quatre puces GDDR6 donnent près de 300 Go/s, un point idéal pour l'inférence edge. Frank Ferro, directeur senior marketing IP Cores chez Rambus, note que LPDDR, bien que rentable pour l'inférence terminaux, ne peut égaler les exigences de bande passante des modèles IA modernes, poussant les concepteurs vers GDDR6.
Frank Ferro de Rambus
D'autres accélérateurs — comme le FPGA Achronix Speedster7t — exploitent aussi la bande passante GDDR, prouvant que HBM et GDDR ont tous deux un rôle dans l'IA edge.
La périphérie lointaine (far edge)
Au bord extrême — téléphones mobiles, wearables, nœuds capteurs — l'IA est majoritairement de l'inférence. Des dispositifs comme les puces de contrôle vocal Syntiant et les accélérateurs d'effets caméra Gyrfalcon utilisent des techniques de calcul analogique, embarquant la multiplication matricielle directement dans les cellules mémoire.
L'IP phare de Mythic exploite les transistors de mémoire flash comme résistances variables pour effectuer des opérations multiply-accumulate 8 bits, atteignant une densité et une efficacité énergétique remarquables. Leur calibration d'annulation de bruit permet une inférence 8 bits fiable malgré la variabilité analogique.
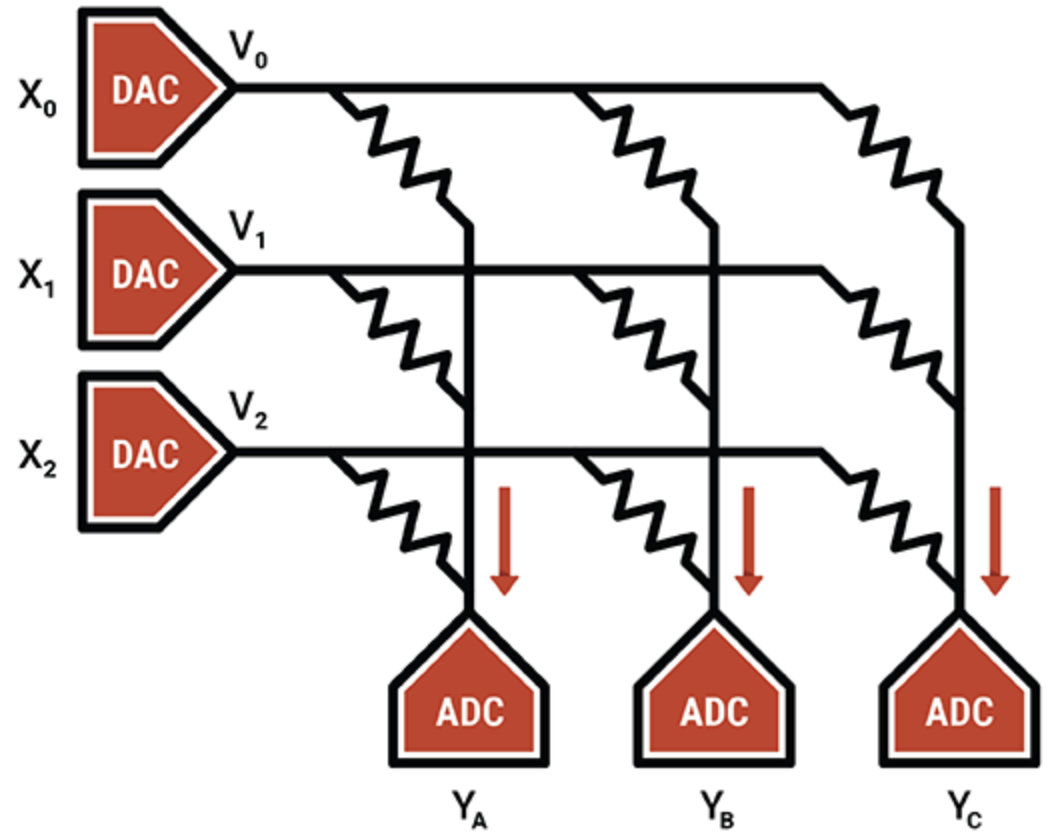
Mythic utilise un réseau de transistors de mémoire flash pour créer des moteurs multiply-accumulate denses (Source : Mythic)
Les ASIC adaptés à l'inférence ultra-basse consommation combinent SRAM distribué, SRAM bulk et DRAM hors puce. Geoff Tate de Flex Logix explique que l'InferX X1 atteint 7,5 TOPS à 933 MHz avec une seule DRAM LPDDR4 x32 et 10 Mo SRAM, trouvant un équilibre entre vitesse, surface et coût.
À mesure que l'économie de la mémoire évolue, LPDDR restera probablement le choix dominant pour l'inférence edge grâce à sa bande passante, simplicité et empreinte silicium minimale.
Mémoires émergentes
Au-delà des technologies établies, plusieurs mémoires non volatiles offrent des capacités nouvelles pour l'IA.
La MRAM (mémoire magnéto-résistive) stocke les bits via l'orientation magnétique, permettant un fonctionnement basse tension avec comportement stochastique contrôlé. Cette aléatoire peut être exploitée pour les réseaux neuronaux binarisés (BNN), qui tolèrent des taux d'erreur bit élevés tout en maintenant la précision. Andy Walker de Spin Memory note que la MRAM peut réduire drastiquement la consommation tout en préservant les performances pour tâches edge IA ne demandant pas une précision extrême.
Andy Walker de Spin Memory
La non-volatilité de la MRAM ouvre aussi la porte à des architectures mémoire unifiées remplaçant à la fois Flash embarqué et SRAM, réduisant surface de die et puissance statique.
ReRAM neuromorphique
La ReRAM (RAM résistive) introduit la plasticité synaptique, permettant des systèmes neuromorphiques qui apprennent in situ. La collaboration du Politecnico di Milano avec Weebit Nano a démontré le potentiel de la ReRAM pour l'apprentissage non supervisé, permettant aux dispositifs edge de s'adapter à des environnements changeants sans réentraînement depuis zéro.
En résumé, la technologie mémoire évolue rapidement pour répondre aux exigences de l'IA edge. Les mémoires établies — GDDR, HBM, Optane — continuent de dominer l'edge data-center, tandis que LPDDR et SRAM sur puce règnent sur le far edge. Les mémoires non volatiles émergentes comme MRAM et ReRAM sont prêtes à offrir une efficacité énergétique et des capacités adaptatives sans précédent, façonnant la prochaine génération de dispositifs IA.
— Cet article a été publié à l'origine sur notre site partenaire, EE Times.
Embarqué
- Comprendre ROM, PROM, EPROM et EEPROM : conception, programmation et identification
- Microprocesseurs : l'évolution de l'informatique à programme stocké
- Exploiter le Big Data pour la maintenance d'usine : surmonter les défis modernes
- STMicroelectronics présente des MCUs 28 nm FD-SOI avec PCM embarqué pour groupe motopropulseur, ADAS et électrification
- L'informatique de périphérie : transformer chaque industrie avec des solutions réelles
- 5G et Edge : défis cybersécurité émergents pour 2021
- Maîtriser la gestion d'actifs IIoT : 4 conseils essentiels et défis courants
- Trois exemples majeurs de technologies de fabrication avancées
- Technologie de mouvement linéaire : solutions de précision pour l'automatisation