



Comprendre Hadoop : Guide complet pour le traitement des Big Data
L'évolution des Big Data a engendré de nouveaux défis nécessitant de nouvelles solutions. Jamais dans l'histoire les serveurs n'ont eu à traiter, trier et stocker d'aussi vastes volumes de données en temps réel.
Ce défi a conduit à l'émergence de nouvelles plateformes, telles qu'Apache Hadoop, capables de gérer aisément d'énormes jeux de données.
Dans cet article, vous découvrirez ce qu'est Hadoop, ses composants principaux, et comment Apache Hadoop facilite le traitement des Big Data.
Qu'est-ce que Hadoop ?
La bibliothèque logicielle Apache Hadoop est un framework open source permettant de gérer et traiter efficacement les Big Data dans un environnement de calcul distribué.
Apache Hadoop se compose de quatre modules principaux :
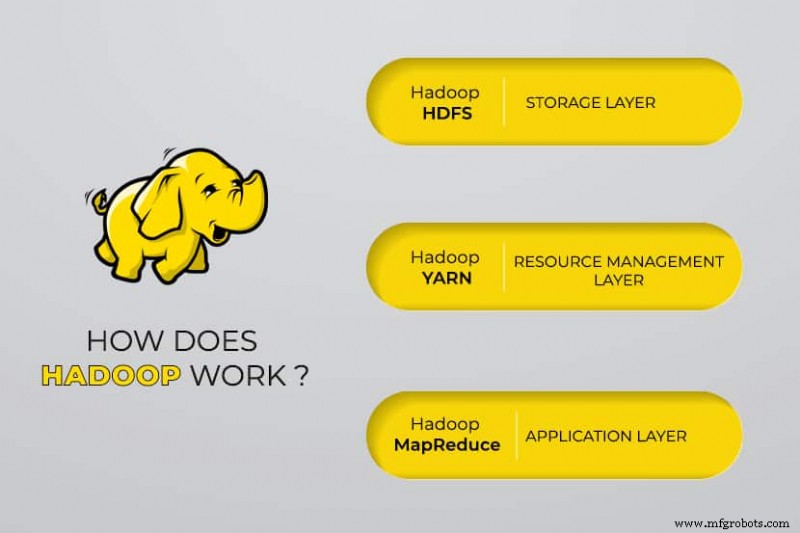
Hadoop Distributed File System (HDFS)
Les données résident dans le système de fichiers distribué de Hadoop, similaire à celui d'un système de fichiers local sur un ordinateur classique. HDFS offre un débit de données supérieur comparé aux systèmes de fichiers traditionnels.
De plus, HDFS assure une excellente évolutivité. Vous pouvez passer d'une seule machine à des milliers aisément et sur du matériel standard (commodity hardware).
Yet Another Resource Negotiator (YARN)
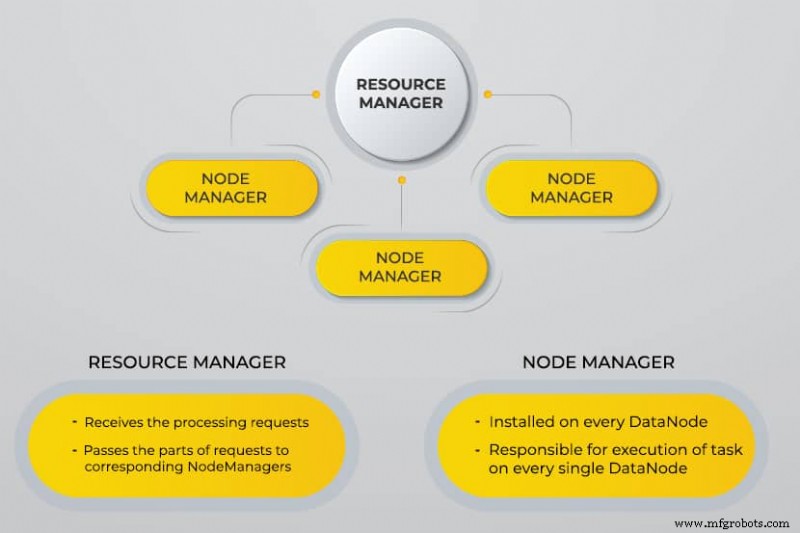
YARN facilite la planification des tâches, la gestion et la surveillance des nœuds de cluster et des autres ressources.
MapReduce
Le module Hadoop MapReduce permet aux programmes d'effectuer des calculs de données en parallèle. La tâche Map de MapReduce convertit les données d'entrée en paires clé-valeur. Les tâches Reduce consomment l'entrée, l'agrègent et produisent le résultat.
Hadoop Common
Hadoop Common utilise des bibliothèques Java standard dans tous les modules.
Pourquoi Hadoop a-t-il été développé ?
Le Web a connu une croissance exponentielle cette dernière décennie, atteignant des milliards de pages. La recherche d'informations en ligne est devenue difficile en raison de ce volume massif. Ces données sont devenues les Big Data, posant deux problèmes majeurs :
- Difficulté à stocker toutes ces données de manière efficace et facilement récupérable
- Difficulté à traiter les données stockées
Les développeurs ont travaillé sur de nombreux projets open source pour accélérer et optimiser les résultats de recherche web en résolvant ces problèmes. Leur solution : distribuer données et calculs sur un cluster de serveurs pour atteindre le traitement simultané.
Finalement, Hadoop s'est imposé comme solution à ces problèmes, apportant de nombreux autres avantages, dont la réduction des coûts de déploiement des serveurs.
Comment fonctionne le traitement Big Data avec Hadoop ?
Avec Hadoop, nous exploitons la capacité de stockage et de traitement des clusters pour implémenter le traitement distribué des Big Data. Essentiellement, Hadoop fournit une base sur laquelle construire d'autres applications pour traiter les Big Data.
Les applications qui collectent des données sous différents formats les stockent dans le cluster Hadoop via l'API Hadoop, qui se connecte au NameNode. Le NameNode capture la structure du répertoire de fichiers et le placement des « chunks » (blocs) pour chaque fichier créé. Hadoop réplique ces chunks sur les DataNodes pour le traitement parallèle.
MapReduce effectue l'interrogation des données. Il mappe tous les DataNodes et réduit les tâches liées aux données dans HDFS. Le nom « MapReduce » décrit exactement son fonctionnement : les tâches Map s'exécutent sur chaque nœud pour les fichiers d'entrée fournis, tandis que les reducers s'exécutent pour lier les données et organiser la sortie finale.
Outils Big Data de l'écosystème Hadoop
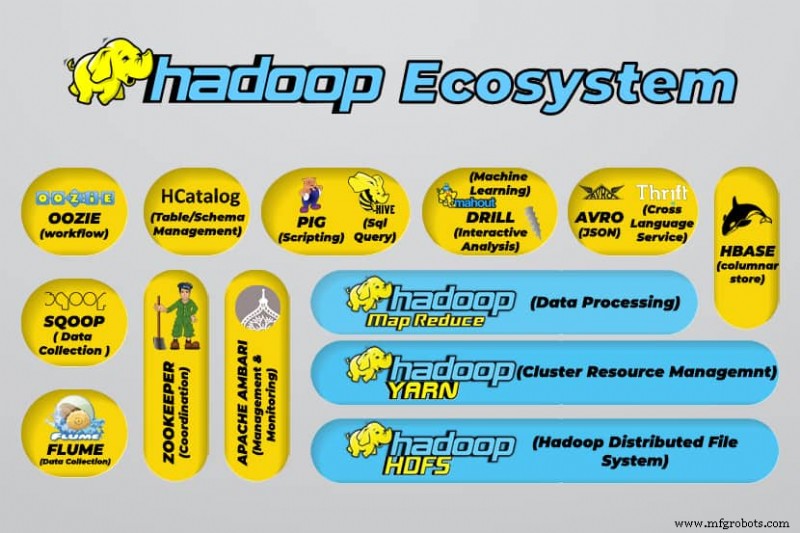
L'écosystème Hadoop prend en charge une variété d'outils open source Big Data. Ces outils complètent les composants principaux de Hadoop et renforcent sa capacité à traiter les Big Data.
Les outils de traitement Big Data les plus utiles incluent :
- Apache Hive
Apache Hive est un entrepôt de données pour traiter de grands ensembles de données stockés dans le système de fichiers de Hadoop.
- Apache Zookeeper
Apache Zookeeper automatise les basculements et réduit l'impact d'un NameNode défaillant.
- Apache HBase
Apache HBase est une base de données non relationnelle open source pour Hadoop.
- Apache Flume
Apache Flume est un service distribué pour le streaming de grandes quantités de données de logs.
- Apache Sqoop
Apache Sqoop est un outil en ligne de commande pour migrer des données entre Hadoop et les bases de données relationnelles.
- Apache Pig
Apache Pig est la plateforme de développement d'Apache pour créer des jobs s'exécutant sur Hadoop. Le langage utilisé est Pig Latin.
- Apache Oozie
Apache Oozie est un système d'ordonnancement facilitant la gestion des jobs Hadoop.
- Apache HCatalog
Apache HCatalog est un outil de gestion de stockage et de tables pour trier les données provenant de différents outils de traitement.
Avantages de Hadoop
Hadoop est une solution robuste pour le traitement des Big Data et un outil essentiel pour les entreprises qui manipulent de gros volumes de données.
Les principales caractéristiques et avantages de Hadoop sont détaillés ci-dessous :
- Stockage et traitement plus rapides d'énormes volumes de données
La quantité de données à stocker a explosé avec l'arrivée des réseaux sociaux et de l'Internet des Objets (IoT). Le stockage et le traitement de ces jeux de données sont critiques pour les entreprises qui les possèdent. - Flexibilité
La flexibilité de Hadoop permet de sauvegarder des types de données non structurées : texte, symboles, images, vidéos. Dans les bases de données relationnelles traditionnelles (RDBMS), il faut traiter les données avant de les stocker. Avec Hadoop, le prétraitement n'est pas nécessaire : vous stockez les données brutes et décidez comment les traiter plus tard. En d'autres termes, il se comporte comme une base de données NoSQL. - Puissance de traitement
Hadoop traite les Big Data via un modèle de calcul distribué. Son utilisation efficace de la puissance de traitement le rend à la fois rapide et efficient. - Coût réduit
De nombreuses équipes abandonnaient leurs projets avant l'arrivée de frameworks comme Hadoop, en raison des coûts élevés. Hadoop est un framework open source, gratuit, qui utilise du matériel standard bon marché pour stocker les données. - Évolutivité
Hadoop permet de faire évoluer rapidement votre système sans administration lourde, simplement en modifiant le nombre de nœuds dans un cluster. - Tolérance aux pannes
L'un des avantages majeurs du modèle de données distribué est sa capacité à tolérer les défaillances. Hadoop ne dépend pas du matériel pour maintenir la disponibilité. Si un périphérique tombe en panne, le système redirige automatiquement la tâche vers un autre. La tolérance aux pannes est possible car des données redondantes sont maintenues en sauvegardant plusieurs copies à travers le cluster. En d'autres termes, la haute disponibilité est maintenue au niveau logiciel.
Les trois principaux cas d'usage
Traitement des Big Data
Nous recommandons Hadoop pour d'énormes volumes de données, généralement dans la gamme des pétaoctets ou plus. Il est mieux adapté aux quantités massives de données nécessitant une puissance de traitement énorme. Hadoop n'est pas la meilleure option pour une organisation traitant des volumes plus modestes, de l'ordre de quelques centaines de gigaoctets.
Stockage d'un ensemble diversifié de données
L'un des nombreux avantages de Hadoop est sa flexibilité et son support de divers types de données. Qu'il s'agisse de texte, d'images ou de données vidéo, Hadoop les stocke efficacement. Les organisations choisissent comment traiter les données selon leurs besoins. Hadoop a les caractéristiques d'un data lake en offrant une flexibilité sur les données stockées.
Traitement parallèle des données
L'algorithme MapReduce utilisé dans Hadoop orchestrera le traitement parallèle des données stockées, ce qui signifie que vous pouvez exécuter plusieurs tâches simultanément. Cependant, les opérations jointes ne sont pas autorisées car elles perturbent la méthodologie standard de Hadoop. Il incorpore le parallélisme tant que les données sont indépendantes les unes des autres.
À quoi sert Hadoop dans le monde réel ?
Des entreprises du monde entier utilisent les systèmes de traitement Big Data Hadoop. Voici quelques-unes des nombreuses utilisations pratiques :
- Comprendre les besoins clients
De nos jours, Hadoop s'avère très utile pour comprendre les besoins clients. Les grandes entreprises de la finance et des réseaux sociaux utilisent cette technologie pour analyser les Big Data sur leur activité.
Les entreprises exploitent ces données pour proposer des offres personnalisées. Vous l'avez peut-être expérimenté via les publicités sur les réseaux sociaux et sites e-commerce basées sur vos centres d'intérêt et votre activité Internet. - Optimiser les processus métier
Hadoop aide à optimiser la performance des entreprises en analysant mieux leurs données transactionnelles et clients. L'analyse des tendances et l'analyse prédictive aident les entreprises à personnaliser leurs produits et stocks pour augmenter les ventes. Cela facilite une meilleure prise de décision et conduit à des profits plus élevés.
De plus, les entreprises utilisent Hadoop pour améliorer leur environnement de travail en surveillant le comportement des employés via la collecte de données sur leurs interactions. - Améliorer les services de santé
Les institutions médicales peuvent utiliser Hadoop pour surveiller l'énorme volume de données sur les problèmes de santé et les résultats des traitements. Les chercheurs peuvent analyser ces données pour identifier des problèmes de santé, prédire des médicaments et décider des plans de traitement. De telles améliorations permettront aux pays d'améliorer rapidement leurs services de santé. - Trading financier
Hadoop possède un algorithme sophistiqué pour scanner les données de marché avec des paramètres prédéfinis afin d'identifier les opportunités de trading et les tendances saisonnières. Les sociétés financières peuvent automatiser la plupart de ces opérations grâce aux capacités robustes de Hadoop. - Utiliser Hadoop pour l'IoT
Les appareils IoT dépendent de la disponibilité des données pour fonctionner efficacement. Les fabricants et inventeurs utilisent Hadoop comme entrepôt de données pour des milliards de transactions. L'IoT étant un concept de streaming de données, Hadoop est une solution adaptée et pratique pour gérer les vastes volumes de données qu'il englobe.
Hadoop est mis à jour en continu, nous permettant d'améliorer les instructions utilisées avec les plateformes IoT.
D'autres utilisations pratiques de Hadoop incluent l'amélioration des performances des appareils, l'amélioration de la quantification personnelle et de l'optimisation des performances, l'amélioration de la recherche sportive et scientifique.
Quels sont les défis de l'utilisation de Hadoop ?
Toute application comporte avantages et défis. Hadoop introduit également plusieurs défis :
- L'algorithme MapReduce n'est pas toujours la solution
L'algorithme MapReduce ne prend pas en charge tous les scénarios. Il convient aux requêtes d'information simples et aux problèmes pouvant être découpés en unités indépendantes, mais pas aux tâches itératives.
MapReduce est inefficace pour l'informatique analytique avancée car les algorithmes itératifs nécessitent une communication intensive et créent de multiples fichiers pendant la phase MapReduce. - Gestion de données incomplète
Hadoop ne fournit pas d'outils complets pour la gestion des données, les métadonnées et la gouvernance des données. De plus, il manque d'outils pour la standardisation des données et la détermination de leur qualité. - Pénurie de talents
En raison de la courbe d'apprentissage abrupte de Hadoop, il peut être difficile de trouver des programmeurs juniors avec des compétences Java suffisantes pour être productifs avec MapReduce. Cette intensité est la principale raison pour laquelle les fournisseurs s'intéressent à superposer la technologie de base de données relationnelle (SQL) sur Hadoop, car il est bien plus facile de trouver des programmeurs ayant de solides connaissances en SQL que des compétences en MapReduce.
L'administration Hadoop est à la fois un art et une science, nécessitant une connaissance bas niveau des systèmes d'exploitation, du matériel et des paramètres du noyau Hadoop. - Sécurité des données
Le protocole d'authentification Kerberos est une étape importante vers la sécurisation des environnements Hadoop. La sécurité des données est cruciale pour protéger les systèmes Big Data des problèmes de sécurité des données fragmentées.
Conclusion
Hadoop est hautement efficace pour répondre aux besoins de traitement des Big Data lorsqu'il est implémenté efficacement avec les étapes requises pour surmonter ses défis. C'est un outil polyvalent pour les entreprises qui gèrent d'importants volumes de données.
L'un de ses principaux avantages est qu'il peut s'exécuter sur n'importe quel matériel et qu'un cluster Hadoop peut être distribué parmi des milliers de serveurs. Une telle flexibilité est particulièrement significative dans les environnements d'infrastructure-as-code.
Cloud computing
- Exploiter le Big Data avec le Cloud Computing : un avantage stratégique
- Comprendre la sécurité Cloud : pourquoi votre entreprise en a besoin
- Big Data et Cloud Computing : Comment ils fonctionnent ensemble
- Exploiter Big Data & Cloud Computing pour stimuler la croissance business
- Tendances émergentes des plateformes IdO pour 2018 : Edge Computing, Blockchain et plus
- Maintenance prédictive : débloquer l'efficacité et réduire les risques grâce aux insights data-driven
- DDR5 RAM expliquée : caractéristiques, avantages et disponibilité
- Internet industriel des objets (IIoT) : définition, portée et impact industriel
- Big Data vs IA : la synergie derrière la transformation digitale