



Construction d'un autoencodeur variationnel avec TensorFlow : guide pratique
Maîtrisez les fondamentaux des autoencodeurs, découvrez comment les autoencodeurs variationnels les améliorent, et parcourez une implémentation TensorFlow pas à pas.
L'intelligence artificielle a remodelé d'innombrables secteurs, et la compression de données ne fait pas exception. Les autoencodeurs — surtout leurs variantes variationnelles — offrent des schémas de compression génératifs puissants, à la fois efficaces et expressifs. Ce guide décompose les concepts de base et vous guide à travers une implémentation TensorFlow complète utilisant le jeu de données MNIST.
Applications des autoencodeurs
Les autoencodeurs sont largement adoptés dans des domaines allant de la traduction automatique neuronale à la découverte de médicaments, le débruitage d'images et la détection d'anomalies. Leur capacité à apprendre des représentations compressées et informatives en fait un outil incontournable pour les pipelines ML modernes.
Composants clés d'un autoencodeur
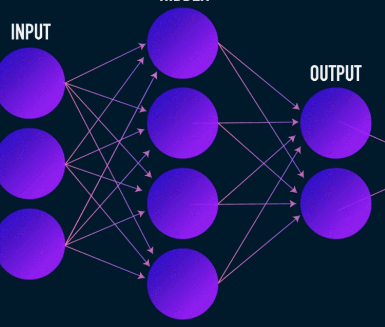
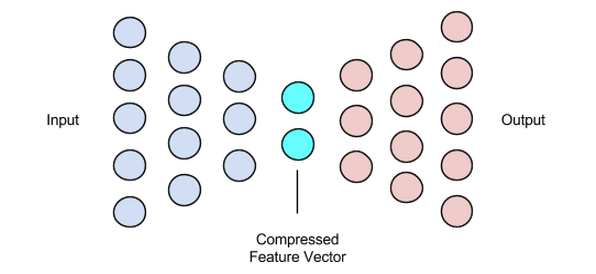
Contrairement aux réseaux de neurones typiques, les autoencodeurs comportent un goulot d'étranglement qui force une représentation latente de faible dimension. L'architecture comprend trois parties principales :
- Encodeur – compresse les données d'entrée en un vecteur latent.
- Goulot d'étranglement (Vecteur latent) – stocke les caractéristiques les plus saillantes.
- Décodeur – reconstrruit l'entrée à partir du vecteur latent.
L'encodeur et le décodeur sont généralement des réseaux feed-forward, mais des variantes spécialisées — convolutionnelles pour images, récurrentes pour texte — sont courantes en pratique.
Encodeur
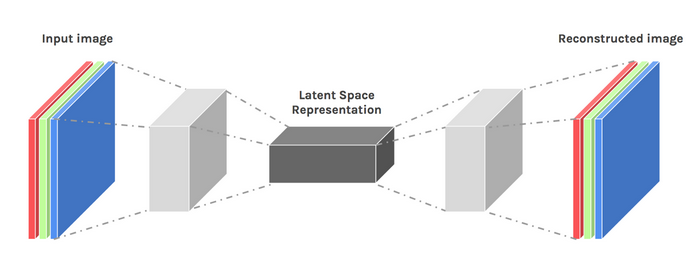
L'encodeur mappe des entrées de haute dimension (ex. images 28×28 pixels) vers un vecteur latent compact. Pendant l'entraînement, il optimise ses poids pour que le vecteur latent capture l'information essentielle, permettant au décodeur de reconstruire l'entrée avec une perte minimale.
Goulot d'étranglement (Vecteur latent)
La taille du vecteur latent est un compromis : trop petit et vous perdez des détails critiques ; trop grand et vous compromettez la compression et gonflez le calcul. Sélectionner une dimensionalité appropriée est crucial pour la performance du modèle.
Décodeur
Le décodeur est un miroir de l'encodeur, transformant le vecteur latent de retour dans l'espace de données original. Il utilise généralement des convolutions transposées ou des couches d'upsampling pour récupérer la résolution spatiale.
Entraînement des autoencodeurs
Les autoencodeurs sont entraînés de bout en bout en utilisant des optimiseurs basés sur le gradient comme Adam. L'objectif est de minimiser une perte de reconstruction qui quantifie l'écart entre l'entrée et sa reconstruction.
Fonctions de perte
Choix courants : L1, L2, et erreur quadratique moyenne (MSE). Chacune mesure à quel point la sortie est proche de l'entrée, les rendant adaptées aux tâches de reconstruction générative.
Variantes de réseau
Bien que les perceptrons multicouches (MLP) puissent servir d'encodeurs/décodeurs, les réseaux de neurones convolutifs (CNN) sont préférés pour les données d'image grâce à leur conscience spatiale. Les réseaux récurrents excellent avec les données séquentielles comme le texte.
Les autoencodeurs standards manquent de créativité — ils ne peuvent que reproduire les données vues pendant l'entraînement. L'introduction de stochasticité via un cadre variationnel débloque des capacités génératives.
Autoencodeurs variationnels (VAE)
Les VAE modifient l'architecture standard de deux façons :
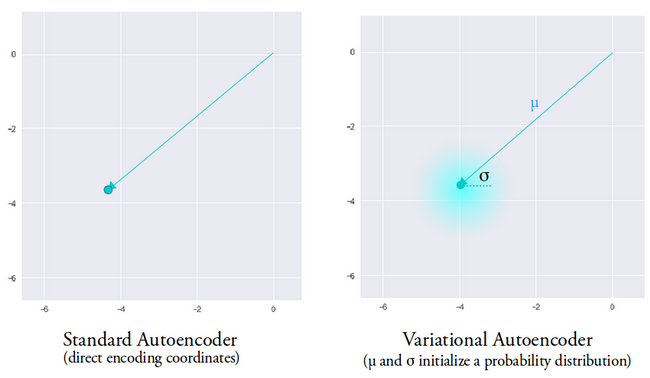
- L'encodeur produit un vecteur de moyenne et un vecteur de variance, définissant une distribution gaussienne.
- Un terme de divergence Kullback-Leibler (KL) est ajouté à la perte pour régulariser la distribution latente vers une gaussienne unitaire.
Pendant l'inférence, l'encodeur échantillonne un vecteur latent depuis la distribution apprise, permettant au décodeur de générer des reconstructions diverses et réalistes. Cette stochasticité atténue les discontinuités souvent observées dans les autoencodeurs déterministes.
Implémentation TensorFlow
Voici une implémentation TensorFlow concise, prête pour la production, d'un VAE convolutionnel entraîné sur MNIST.
Préparation des données
(train_images, _), (test_images, _) = tf.keras.datasets.mnist.load_data()
train_images = train_images.reshape(-1, 28, 28, 1).astype('float32')
test_images = test_images.reshape(-1, 28, 28, 1).astype('float32')
train_images /= 255.
test_images /= 255.
train_images[train_images >= .5] = 1.
train_images[train_images < .5] = 0.
test_images[test_images >= .5] = 1.
test_images[test_images < .5] = 0.
TRAIN_BUF = 60000
BATCH_SIZE = 100
TEST_BUF = 10000
train_dataset = tf.data.Dataset.from_tensor_slices(train_images).shuffle(TRAIN_BUF).batch(BATCH_SIZE)
test_dataset = tf.data.Dataset.from_tensor_slices(test_images).shuffle(TEST_BUF).batch(BATCH_SIZE)
Définition du modèle VAE
class CVAE(tf.keras.Model):
    def __init__(self, latent_dim):
        super(CVAE, self).__init__()
        self.latent_dim = latent_dim
        self.inference_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(28, 28, 1)),
            tf.keras.layers.Conv2D(32, 3, strides=2, activation='relu'),
            tf.keras.layers.Conv2D(64, 3, strides=2, activation='relu'),
            tf.keras.layers.Flatten(),
            tf.keras.layers.Dense(latent_dim + latent_dim), # mean & logvar
        ])
        self.generative_net = tf.keras.Sequential([
            tf.keras.layers.InputLayer(input_shape=(latent_dim,)),
            tf.keras.layers.Dense(7*7*32, activation='relu'),
            tf.keras.layers.Reshape((7, 7, 32)),
            tf.keras.layers.Conv2DTranspose(64, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(32, 3, strides=2, padding='SAME', activation='relu'),
            tf.keras.layers.Conv2DTranspose(1, 3, padding='SAME'), # logits
        ])
    @tf.function
    def sample(self, eps=None):
        if eps is None:
            eps = tf.random.normal(shape=(100, self.latent_dim))
        return self.decode(eps, apply_sigmoid=True)
    def encode(self, x):
        mean, logvar = tf.split(self.inference_net(x), num_or_size_splits=2, axis=1)
        return mean, logvar
    def reparameterize(self, mean, logvar):
        eps = tf.random.normal(shape=mean.shape)
        return eps * tf.exp(logvar * .5) + mean
    def decode(self, z, apply_sigmoid=False):
        logits = self.generative_net(z)
        if apply_sigmoid:
            return tf.sigmoid(logits)
        return logits
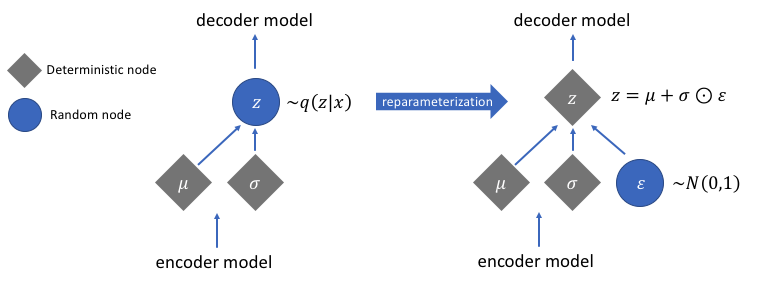
Les fonctions auxiliaires clés — encode, reparameterize, et decode — encapsulent le flux de travail VAE. La méthode reparameterize implémente le truc de réparamétrisation, permettant le flux de gradient à travers l'échantillonnage stochastique.
Truc de réparamétrisation
Échantillonner un vecteur latent directement depuis une distribution brise la différentiabilité. En exprimant l'échantillon comme z = mean + std * eps où eps ~ N(0,1), les gradients se propagent à travers mean et std. Le terme de divergence KL aligne davantage la distribution apprise avec une normale standard, favorisant des espaces latents lisses.
Résumé rapide des étapes
- Définir les architectures encodeur et décodeur.
- Implémenter le truc de réparamétrisation pour permettre la rétropropagation.
- Entraîner le modèle de bout en bout, en minimisant la perte de reconstruction plus divergence KL.
Pour le code complet et scripts d'entraînement additionnels, visitez le tutoriel officiel TensorFlow.
Crédit image : Chiman Kwan (modifié)
Robot industriel
- Comment les imprimantes 3D fabriquent pièces métal : de la poudre à la précision
- Réduire le Gaspillage et les Coûts Énergétiques avec les Robots Autonomes
- Sécuriser la Technologie Cloud : Meilleures Pratiques pour Protection Données et Atténuation Risques
- Exploiter les données dans l'Internet de la fiabilité : stratégies pour une gestion efficace
- Exploiter l'IoT pour les Big Data CVC : optimiser énergie, confort et qualité de l'air – Partie 2
- Donner vie à l'IoT avec IBM et Tech Data – Partie 2
- Transformer l'IoT en réalité : insights Tech Data et IBM – Partie 1
- Feuilles de route pilotées par l'IA : guide stratégique pour les entreprises de la chaîne d'approvisionnement
- Exploiter le data mining et l'IA : la feuille de route des marques industrielles pour prospérer dans l'e-commerce