



Minima locaux dans l'entraînement des réseaux de neurones : mythe ou réalité ?
Comprendre le rôle des minima locaux dans l'entraînement du perceptron et des réseaux de neurones multicouches.
Dans la série réseaux de neurones d'AAC, nous avons examiné de nombreux aspects de la conception et l'entraînement du perceptron multicouche. Avant de plonger dans les minima locaux, révisez les articles précédents :
- Comment effectuer une classification avec un réseau de neurones : qu'est-ce que le perceptron ?
- Comment utiliser un exemple simple de réseau de neurones perceptron pour classifier des données
- Comment entraîner un perceptron de base
- Comprendre l'entraînement simple de réseau de neurones
- Introduction à la théorie de l'entraînement pour réseaux de neurones
- Comprendre le taux d'apprentissage dans les réseaux de neurones
- Apprentissage automatique avancé avec le perceptron multicouche
- La fonction d'activation sigmoïde : activation dans les réseaux de neurones perceptron multicouches
- Comment entraîner un perceptron multicouche
- Comprendre les formules d'entraînement et la rétropropagation pour perceptrons multicouches
- Architecture de réseau de neurones pour une implémentation Python
- Comment créer un perceptron multicouche en Python
- Traitement du signal avec réseaux de neurones : validation dans la conception de réseaux de neurones
- Jeux de données d'entraînement pour réseaux de neurones : comment entraîner et valider un réseau de neurones Python
- Combien de couches cachées et nœuds cachés un réseau de neurones a-t-il besoin ?
- Comment augmenter la précision d'un réseau de neurones à couche cachée
- Incorporation de nœuds de biais dans votre réseau de neurones
- Comprendre les minima locaux dans l'entraînement des réseaux de neurones
L'entraînement d'un réseau de neurones est une tâche d'optimisation sophistiquée. Bien que nous n'ayons rarement besoin de comprendre chaque nuance mathématique pour construire des modèles efficaces, le phénomène des minima locaux reste une considération théorique critique.
Pourquoi les minima locaux importent
Historiquement, les minima locaux étaient vus comme un obstacle majeur à l'entraînement, surtout pour les correspondances entrée-sortie complexes. Des recherches récentes — comme les études sur la géométrie de la surface de perte (ex. Choromanska et al., 2015 ; Dauphin et al., 2014) — suggèrent que les architectures modernes et les heuristiques d'entraînement réduisent la sévérité de ce problème. Néanmoins, comprendre les minima locaux nous aide à apprécier comment les optimiseurs basés sur le gradient naviguent dans les paysages de perte de haute dimension et pourquoi certaines stratégies d'entraînement peuvent échapper à des points sous-optimaux.
Définition d'un minimum local
Considérons une surface d'erreur quadratique simple : f(x, y) = x² + y². Tout point qui donne l'erreur la plus basse possible — appelé minimum global — est la cible de l'entraînement. Dans un bol parfaitement convexe, la descente de gradient convergera toujours vers ce point peu importe la position de départ.
En pratique, les surfaces de perte sont loin d'être convexes. Elles peuvent contenir plusieurs vallées et plateaux, comme illustré ci-dessous :
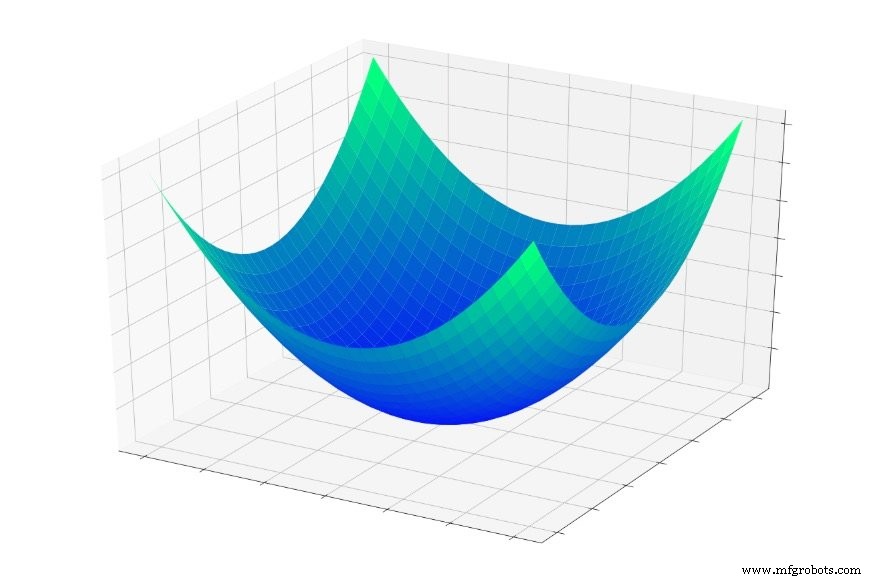
Quand l'optimiseur entre dans un bassin peu profond, il peut se stabiliser dans un minimum local — le point le plus bas dans cette région locale — mais pas le global. Sans connaissance globale, l'algorithme ne peut pas « remonter » pour explorer des vallées plus profondes.
Avons-nous vraiment besoin du minimum global ?
Bien qu'atteindre le minimum global corrèle souvent avec une erreur d'entraînement plus faible, ce n'est pas toujours synonyme de meilleure généralisation. Des réseaux hautement expressifs qui atteignent un ajustement parfait sur les données d'entraînement peuvent surapprendre, réduisant la performance sur des échantillons inédits. Dans de tels cas, un minimum local bien situé peut fournir une solution plus robuste. De plus, les points de selle — régions plates où les gradients s'annulent dans certaines directions — peuvent poser un défi plus grand que de simples minima locaux (Goodfellow et al., 2015).
Implications pratiques
Les pratiques d'entraînement modernes atténuent les effets des minima locaux via des techniques telles que la descente de gradient stochastique, planification du taux d'apprentissage, momentum, optimiseur Adam, et schémas d'initialisation des poids. Les méthodes d'ensemble et la régularisation (dropout, L2) aident aussi le modèle à éviter le surapprentissage au minimum global.
Conclusion
Les minima locaux restent un aspect fascinant de l'entraînement des réseaux de neurones. Comprendre leur impact informe le choix d'architecture, d'optimiseur et de stratégie de régularisation. Dans le prochain article, nous explorerons des techniques concrètes — comme le recuit du taux d'apprentissage et les optimiseurs adaptatifs — qui guident les réseaux vers des minima souhaitables.
Robot industriel
- Comprendre les topologies de réseau : du point-à-point à l'anneau et l'étoile
- Comprendre les protocoles réseau : de la couche physique à l'arbitrage avancé
- STMicroelectronics Lance STM32Cube.AI : Réseaux Neuronaux Embarqués pour Terminaux Edge
- CEVA dévoile NeuPro-S : processeur IA nouvelle génération pour inférence réseaux neuronaux profonds en edge
- Ajout de nœuds de biais à un perceptron multicouche en Python
- Réseaux de neurones artificiels boostent les performances des communications sans fil
- L'entraînement d'un grand réseau neuronal génère 284 000 kg de CO₂ — Équivalent à 5 voitures sur leur durée de vie
- Découpe Laser Fibre Robotisée vs Découpe Plasma : Différences Clés et Choix de la Bonne Solution
- Réseau de neurones NIST : détection de formes géométriques minuscules dans images denses avec 97% de précision