



Maîtriser le cycle de vie de la Data Science : guide complet
Depuis l'avènement du Big Data, l'informatique moderne repousse sans cesse les limites de capacité et de puissance de traitement. Aujourd'hui, il n'est pas rare de trouver des applications générant des jeux de données de 100 téraoctets ou plus — ce qu'on qualifie de Big Data.
Face à de tels volumes d'information, il est facile de se désorganiser et de perdre du temps avec du contenu inutile. Deux raisons majeures pour suivre une méthodologie qui augmente l'efficacité et l'efficience d'un projet Big Data.
Figure 1. La Data Science moderne travaille sur des jeux de données très volumineux, aussi appelés Big Data.
Le cycle de vie de la Data Science fournit un cadre pour définir, collecter, organiser, évaluer et déployer des projets Big Data. C'est un processus itératif constitué d'étapes séquencées logiquement, facilitant le retour d'information et les pivots.
À quoi ressemble cette séquence ? Il n'existe pas de modèle universel unique. De nombreuses entreprises adaptent le cycle à leurs processus métier, y ajoutant souvent des étapes. Pourtant, tous les modèles et flux de processus partagent des dénominateurs communs. Cet article utilise le modèle CRISP-DM, l'un des premiers et plus populaires modèles de cycle de vie Data Science.
Le modèle CRISP-DM
CRISP-DM signifie Cross Industry Standard Process for Data Mining. Publié en 1999 par ESPRIT, programme européen de soutien à la recherche en technologies de l'information (TI). Le modèle comprend six phases guidant le projet Big Data. Il incite les parties prenantes à réfléchir au métier en posant et répondant aux questions clés sur le problème.
Examinons en détail les six phases du modèle CRISP-DM.
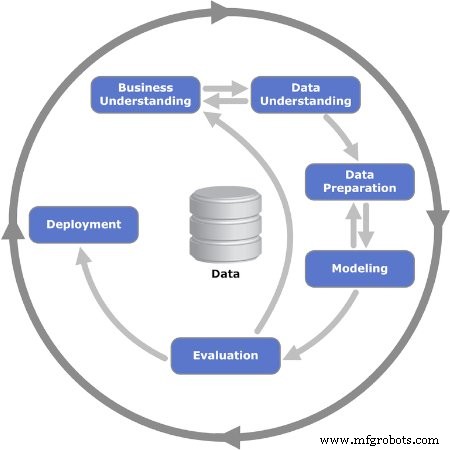
Figure 2. Les six phases itératives du modèle CRISP-DM. Image utilisée avec l'autorisation de Kenneth Jensen.
Phase 1 : Compréhension métier (Business Understanding)
Cette phase initiale comprend plusieurs tâches pour définir le problème et fixer les objectifs. C'est là que les objectifs du projet sont définis avec un focus sur le métier — ou, autrement dit, le client. L'équipe assemblée pour le projet Big Data doit livrer une solution au client, qui peut être un autre département de l'entreprise.
Une fois le besoin métier établi, l'étape suivante est de définir les critères de succès. Ce peuvent être des KPI (indicateurs clés de performance) ou des SLA (accords de niveau de service), offrant des moyens objectifs d'évaluer l'avancement et l'achèvement.
Ensuite, la situation métier doit être analysée pour identifier risques, plans de retour arrière, mesures de contingence, et surtout la disponibilité des ressources. Un plan de projet est établi, avec jalons et ressources.
Phase 2 : Compréhension des données (Data Understanding)
Une fois les fondations posées, place aux données. Cette phase commence par une définition initiale des données jugées nécessaires, puis documente leurs spécificités : où les trouver, type, format, relations entre champs, etc.
Avec cette première documentation, on lance la première collecte de données. Cela donne un aperçu utile de la structure en formation. Cet aperçu est ensuite évalué pour sa qualité.
Phase 3 : Préparation des données (Data Preparation)
La troisième phase renforce la précédente et prépare le jeu de données pour la modélisation. Les champs de données de la première collecte sont affinés, et toute information jugée superflue est retirée : c'est le nettoyage des données.
Parfois, une information spécifique doit être déduite d'autres disponibles ; d'autres fois, elle doit être combinée. En résumé, les données doivent être transformées pour produire un format final.
Phase 4 : Modélisation (Modeling)
La tâche cruciale ici est de sélectionner un algorithme pour traiter les données collectées. Dans ce contexte, un algorithme est un ensemble d'étapes séquentielles et de règles programmées dans un logiciel pour projets Big Data.
De nombreux algorithmes sont utilisables : régressions linéaires, arbres de décision, machines à vecteurs de support (SVM), etc. Choisir le bon algorithme pour résoudre le problème requiert l'expertise de data scientists expérimentés.
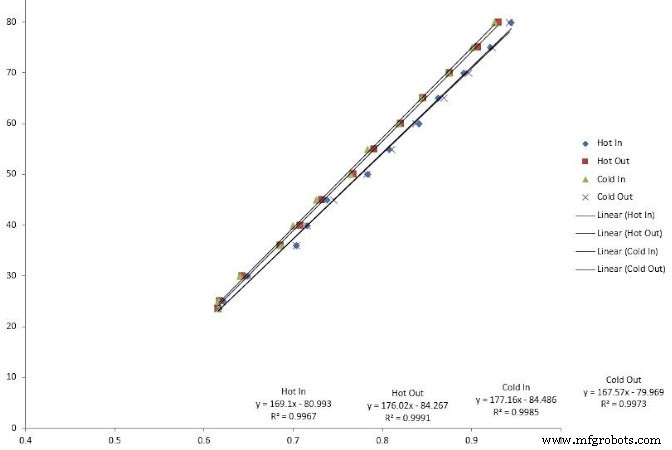
Figure 3. La régression linéaire est un type d'algorithme utilisé en modélisation Big Data.
L'étape suivante : coder l'algorithme dans l'application logicielle. C'est aussi là qu'on planifie la phase de test, consistant à allouer des jeux de données spécifiques pour test et validation.
Phase 5 : Évaluation (Evaluation)
Parfois, il est difficile de choisir un algorithme dès le départ. Les scientifiques en exécutent alors plusieurs et analysent les résultats pour trancher. Une fois les tests terminés, les résultats sont revus pour exhaustivité et exactitude.
Surtout, c'est l'occasion d'évaluer si les résultats mènent vers une solution. Dans le modèle itératif, c'est un carrefour crucial où de nouvelles séquences d'itération majeures peuvent être lancées, ou la décision de passer à la phase finale prise.
Phase 6 : Déploiement (Deployment)
C'est le passage de l'environnement de test à la production réelle. Planifier le calendrier et la stratégie de déploiement est crucial pour réduire risques et temps d'arrêt potentiels.
Bien que le diagramme suggère la fin du projet, de nombreuses étapes de suivi restent : surveillance et maintenance. La surveillance est une période d'observation rapprochée (aussi appelée hyper care) immédiatement après la mise en production. La maintenance est un processus semi-permanent pour maintenir et faire évoluer la solution déployée.
Le Big Data porte bien son nom : une quantité massive de données à analyser. Implémenter un modèle de cycle de vie Data Science aide à décider quelles informations valent la peine d'être conservées et utilisées pour des processus comme la maintenance prédictive.
Technologie de l'Internet des objets
- Exploiter le son : Transformer la transmission de données au-delà des smartphones
- Externalisation de l'IA et du Deep Learning dans la santé : protéger la confidentialité des données
- Maintenance prédictive : exploiter l'Industrie 4.0 pour une production ininterrompue
- Rationaliser le cycle de vie SIM : stratégie digitale pour CSPs
- Démocratiser l'Internet des objets : la prochaine génération satellite IoT apporte connectivité universelle, abordable
- Libérer la valeur des données IoT : stratégies sécurisées et pilotées par les insights
- Donner aux experts métier les moyens de la data science pour des insights manufacturiers plus intelligents
- Pourquoi la connectivité directe des appareils est la prochaine étape majeure de l'IoT industriel
- Pourquoi les mesures analogiques pilotent la performance usine