



Accélérer le Deep Learning avec les FPGA : vitesse, flexibilité et efficacité énergétique
Accélérer le Deep Learning avec les FPGA : vitesse, flexibilité et efficacité énergétique
J'ai récemment assisté au Xilinx Development Forum 2018 dans la Silicon Valley, où j'ai découvert Mipsology, une startup qui prétend avoir résolu les défis IA liés au déploiement de réseaux de neurones sur les field-programmable gate arrays (FPGA). Fondée avec une vision audacieuse, Mipsology démontre comment les FPGA peuvent accélérer n'importe quel réseau de neurones à la performance la plus haute possible, sans les contraintes de déploiement traditionnelles.
En utilisant les nouvelles cartes Alveo de Xilinx, Mipsology a atteint plus de 20 000 images par seconde sur une suite de réseaux populaires, incluant ResNet-50, Inception-V3, et VGG-19.
Que sont les réseaux de neurones et le Deep Learning ?
Les réseaux de neurones, inspirés par le réseau de neurones du cerveau humain, forment l'épine dorsale du deep learning (DL). Le DL est un cadre mathématique qui apprend à effectuer des tâches autonomement en exposant le réseau à de larges volumes de données. Le processus d'entraînement d'un réseau de neurones — le présenter à des millions d'échantillons étiquetés — est suivi par l'inférence, où le modèle entraîné prédit des résultats pour de nouvelles données.
Par exemple, un réseau de reconnaissance vocale pourrait être entraîné sur des milliers d'enregistrements vocaux et ensuite déployé pour transcrire des mots parlés en temps réel.
Pourquoi l'inférence demande une performance extrême
L'inférence requiert des milliards ou trillions d'additions et multiplications par seconde — bien plus que l'entraînement, qui n'occure qu'une fois. Par conséquent, l'inférence est le driver principal de la demande computationnelle en production IA.
Quatre options hardware pour l'inférence Deep Learning
Les ingénieurs ont traditionnellement compté sur quatre catégories de processeurs, classées du plus gourmand en énergie et moins flexible au moins : CPUs → GPUs → FPGAs → ASICs. Le tableau ci-dessous résume les différences clés.
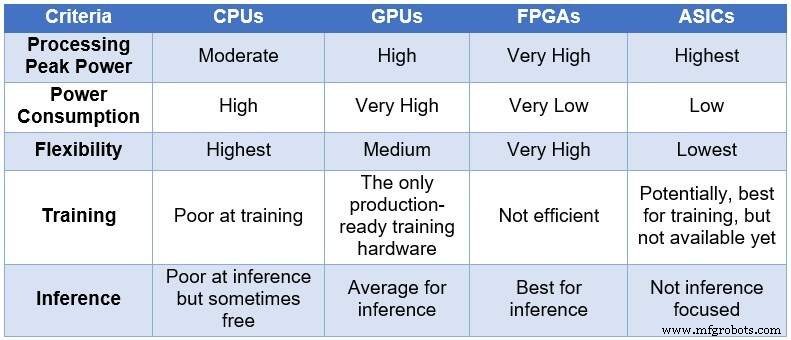
Comparaison CPUs, GPUs, FPGAs, et ASICs pour calcul DL (Source : Lauro Rizzatti)
- Les CPUs offrent flexibilité maximale mais souffrent de latence haute et débit bas pour charges DL.
- Les GPUs livrent un parallélisme massif mais consomment puissance significative et requièrent refroidissement robuste.
- Les ASICs peuvent être extrêmement efficaces pour une tâche étroite, pourtant leur cycle développement long et architecture fixe les rendent mal adaptés aux modèles en évolution rapide.
- Les FPGAs combinent haut débit, faible consommation, et reconfigurabilité, les rendant idéaux pour charges d'inférence dynamiques.
Pourquoi les FPGA excellent à l'inférence
Les FPGA modernes contiennent des millions d'éléments logiques, milliers de blocs DSP, et mémoire embarquée et cœurs ARM — tous opérant en parallèle. Un seul cycle d'horloge peut déclencher des millions d'opérations concurrentes, permettant des trillions de calculs par seconde qui mappent naturellement sur charges DL.
Avantages clés des FPGAs sur CPUs et GPUs incluent :
- Support pour précision de données arbitraire, permettant arithmétique basse précision qui booste le débit.
- Enveloppes de puissance cinq à dix fois plus basses que solutions CPU ou GPU comparables pour charges identiques.
- Reconfigurabilité : le même dispositif peut être mis à jour pour supporter de nouveaux modèles sans fabriquer nouveau silicium.
- Scalabilité dispositif : des cartes data-center haut de gamme aux modules edge compacts, les FPGAs s'adaptent à une large gamme de scénarios de déploiement.
Défis et compromis
Malgré leurs forces, les FPGAs présentent une courbe d'apprentissage raide. Développer des designs haute performance requiert langages de description hardware spécialisés et compréhension profonde du parallélisme, ce qui peut être une barrière pour équipes habituées aux workflows software-centric.
Néanmoins, pour organisations qui exigent la combinaison de vitesse, flexibilité, et efficacité énergétique, les FPGAs représentent la plateforme la plus convaincante pour l'inférence deep-learning aujourd'hui.
Technologie de l'Internet des objets
- CEVA dévoile NeuPro-S : processeur IA nouvelle génération pour inférence réseaux neuronaux profonds en edge
- Puces neuromorphiques : la prochaine frontière pour la performance IA
- ICP Mustang-F100 : accélérateur FPGA pour inférence deep learning temps réel
- Externalisation de l'IA et du Deep Learning dans la santé : protéger la confidentialité des données
- Le rôle de l'IA dans la croissance exponentielle du secteur high-tech
- IA, apprentissage machine et deep learning : différences clés et fonctionnement
- Apple et IBM Watson unissent leurs forces pour propulser le Machine Learning mobile en entreprise
- Deep Learning : Transformer les industries par l'automatisation intelligente
- Atteindre une stabilité inégalée en perçage de trous profonds