



Assurer la Santé Continue de Vos Systèmes IIoT
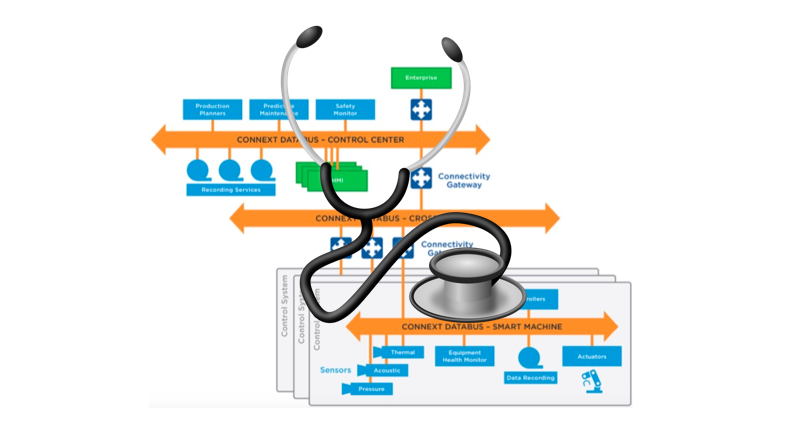
Pourquoi le Monitoring Continu Compte
Quand votre réseau IIoT est up et running, il peut encore souffrir de problèmes cachés : latence réseau, pannes nœuds, ou changements inattendus depuis software upgrades et nouveaux déploiements. Ces problèmes dégradent performance applicative, mais sans observation continue, identifier la cause racine devient difficile.
Les Trois Piliers du Monitoring Opérationnel
Un monitoring efficace repose sur trois composants core :
- Un moteur collecte données fiable
- Un système stockage scalable pour données time-series
- Une plateforme visualisation transformant raw metrics en actionable insights
TICK Stack d'InfluxData : Le Backbone Time-Series
Nous avons sélectionné le TICK stack d'InfluxData pour power notre monitoring pipeline :
- Telegraf – agent plugin-driven qui gather métriques. Il ship avec plus de 100 built-in plugins et peut être extended avec custom plugins.
- InfluxDB – core time-series database. Key features incluent SQL-like queries, built-in time-series functions, automated retention policies, schema-less model, continuous queries pour down-sampling, et high-availability clustering (commercial edition only).
- Chronograf – interface web qui visualise les données.
- Kapacitor – rule-engine qui triggers alerts based on user-defined conditions.

Le TICK stack d'InfluxData délivre solution end-to-end pour collecter, stocker, et visualiser monitoring data.
Designing a Robust Monitoring Architecture
Notre architecture est split en deux layers :
- Management Services Layer – software qui tourne sur chaque node pour collecter health metrics. Dans notre proof-of-concept, les user applications étaient OpenFMB simulations, mais le layer est agnostic à toute application DDS.
- Administration Layer – software qui ingère collected time-series data, le stocke, et fournit visualization et alerting.

Métriques Clés Capturées
- Node metrics – CPU, memory, et network utilization au niveau host.
- Container metrics – même set statistiques pour containers individuels.
- DDS metrics – discovery statistics, protocol usage, et events comme liveliness loss, sample lost, et sample rejected.
Les plugins existants Telegraf ont extrait node et container data depuis OS et container engine. DDS metrics étaient harvested using RTI's Monitoring Library.
De la Collecte Locale à l'Analyse Distante
Un intelligent bridge transforme locally collected data en format suitable pour le monitoring bus. Il peut filter out noise, reduce bandwidth usage, et enrich payloads (ex: adding hostname as tag). Côté administration, nous avons utilisé une instance Telegraf equipped avec un DDS plugin pour souscrire au bus. Pour enable this, nous avons développé un Go binding pour RTI Connector, disponible à GitHub.
Visualization & Alerting avec Grafana
Grafana fournit flexible dashboards et alert rules tailored to your system. Avec les collected data, vous pouvez créer real-time visualizations et set up thresholds qui trigger notifications.
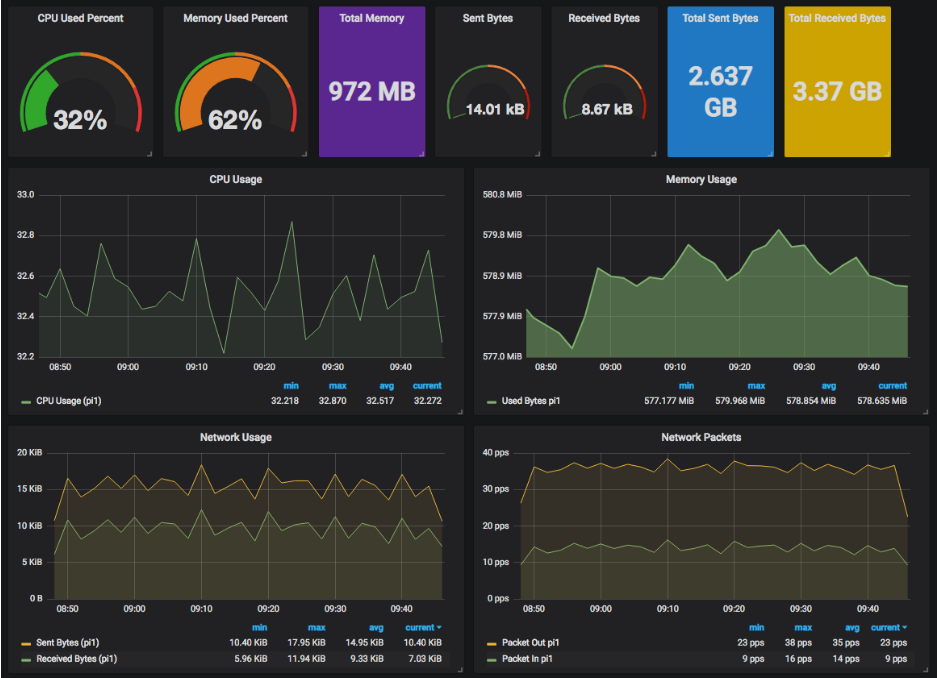
Grafana vous empowers à designer system-specific dashboards qui surface les metrics most critical to vos operations.
Try It Yourself
Nous avons démontré cette end-to-end monitoring solution usando nos energy-system simulations. Le full case study et source code sont disponibles sur notre page Case + Code. Reach out si vous'd like to experiment with the architecture ou share feedback.
Next Steps
Dans notre upcoming post, nous plongerons deeper into InfluxDB integration, partagerons sample code, et vous walkerons through setting up your own monitoring stack.
Technologie de l'Internet des objets
- Pourquoi Adopter l'IIoT dans Votre Usine : 4 Avantages Clés
- Débloquer les données IoT : comment le Business Rules Management pilote la valeur d'entreprise
- Perspectives futures : faire progresser l'IIoT industriel pour l'excellence de production
- Télémétrie à distance : la fondation d'un déploiement IIoT réussi
- AWS Lance Snowmobile : Transporter des Pétaoctets dans une Remorque Sécurisée
- Données : le nouveau pétrole — Comment les raffineries transforment l'information brute en valeur business
- Maximiser le ROI de l'IoT avec une surveillance de performance avancée
- Surveillance proactive de l'état des machines d'usine : prévenir les temps d'arrêt et renforcer la fiabilité
- Comment l'IIoT améliore les systèmes de surveillance d'actifs : fiabilité et efficacité boostées