



Guide débutant sur les réseaux de neurones Perceptron : classification de données avec un exemple simple
Comprendre le Perceptron : un exemple pratique de classification de données
Cet article fait partie d'une série qui démystifie les réseaux de neurones Perceptron. Que vous débutiez ou vouliez revisiter un sujet spécifique, les articles connexes ci-dessous fournissent une feuille de route complète.
- Comment effectuer une classification avec un réseau de neurones : qu'est-ce que le Perceptron ?
- Comment utiliser un exemple simple de réseau de neurones Perceptron pour classifier des données
- Comment entraîner un Perceptron de base
- Comprendre l'entraînement simple de réseau de neurones
- Introduction à la théorie de l'entraînement pour réseaux de neurones
- Comprendre le taux d'apprentissage dans les réseaux de neurones
- Apprentissage automatique avancé avec le Perceptron multicouche
- La fonction d'activation sigmoïde : activation dans les réseaux de neurones Perceptron multicouches
- Comment entraîner un Perceptron multicouche
- Comprendre les formules d'entraînement et la rétropropagation pour Perceptrons multicouches
- Architecture de réseau de neurones pour une implémentation Python
- Comment créer un Perceptron multicouche en Python
- Traitement du signal avec réseaux de neurones : validation dans la conception de réseaux de neurones
- Jeux de données d'entraînement pour réseaux de neurones : comment entraîner et valider un réseau de neurones Python
Qu'est-ce qu'un Perceptron monocouche ?
Un perceptron est le type le plus élémentaire de réseau de neurones. Il consiste en une couche d'entrée qui distribue les données à une unique couche computationnelle, dont les neurones effectuent des sommes pondérées suivies d'une fonction d'activation. Les connexions entre les nœuds d'entrée et la couche computationnelle se voient attribuer des poids scalaires, qui déterminent l'influence de chaque caractéristique d'entrée sur la sortie finale.
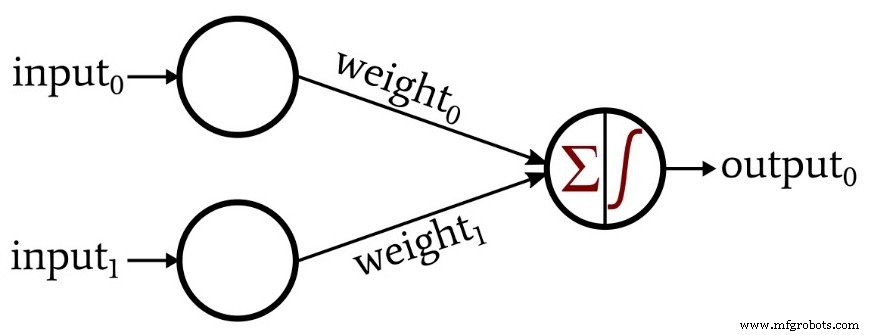
Bien que le réseau contienne deux couches physiques (entrée et sortie), il ne contient qu'une seule couche computationnelle, c'est pourquoi on l'appelle perceptron monocouche.
Classification avec un Perceptron
Examinons un exemple concret. Nous allons construire un perceptron qui reçoit un vecteur tridimensionnel ⟨x, y, z⟩ et classe les points selon leur position par rapport à l'axe des x :
- En dessous de l'axe des x (y < 0) : classé comme invalide (sortie 0)
- Sur ou au-dessus de l'axe des x (y ≥ 0) : classé comme valide (sortie 1)
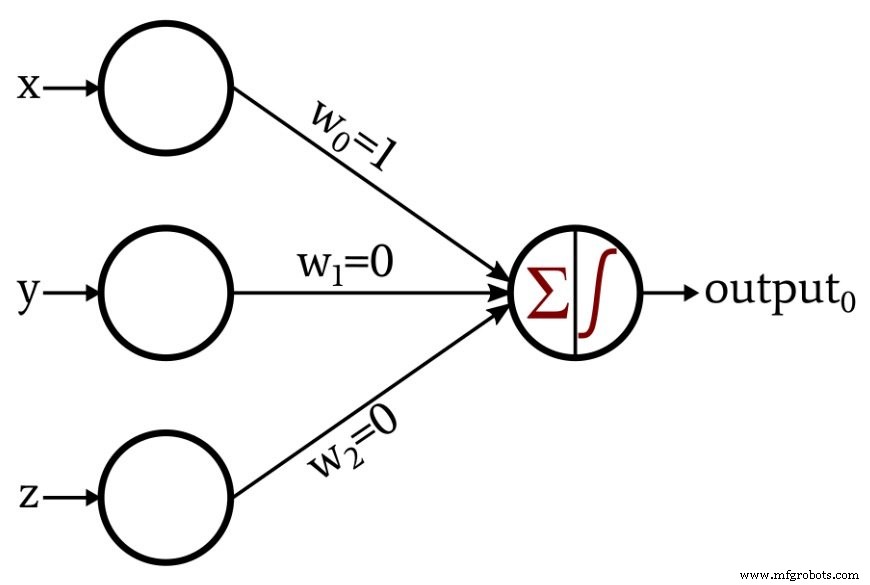
Le vecteur d'entrée du réseau mappe directement aux trois coordonnées : input₀ = x, input₁ = y, et input₂ = z. Comme le problème est linéaire, nous pouvons assigner les poids directement :
Nous définissons ensuite l'activation du neurone de sortie sur une fonction à seuil unitaire :
\[f(x)=\begin{cases}0 & x < 0\\1 & x \geq 0\end{cases}\]
Avec ces réglages, les composantes y et z sont effectivement ignorées (poids 0), et la classification dépend uniquement de la coordonnée x. Si le point se trouve en dessous de l'axe des x, la somme pondérée est négative et la fonction seuil sort 0 ; sinon elle sort 1.
De la conception manuelle à l'entraînement automatisé
L'exemple ci-dessus montre comment un humain peut concevoir un perceptron pour un problème trivial. Dans de nombreux scénarios réels — reconnaissance d'écriture manuscrite, traitement de la parole, diagnostic médical — définir une relation mathématique précise entre entrées et sorties désirées est impraticable. Au lieu de cela, nous comptons sur une approche pilotée par les données : nous fournissons au réseau de nombreuses paires entrée-sortie et le laissons apprendre le pattern sous-jacent.
L'entraînement est le processus qui ajuste les poids pour que le perceptron produise des sorties correctes sur des données inédites. Il compare itérativement les prédictions du réseau avec les étiquettes connues et pousse les poids dans la direction qui réduit l'erreur.
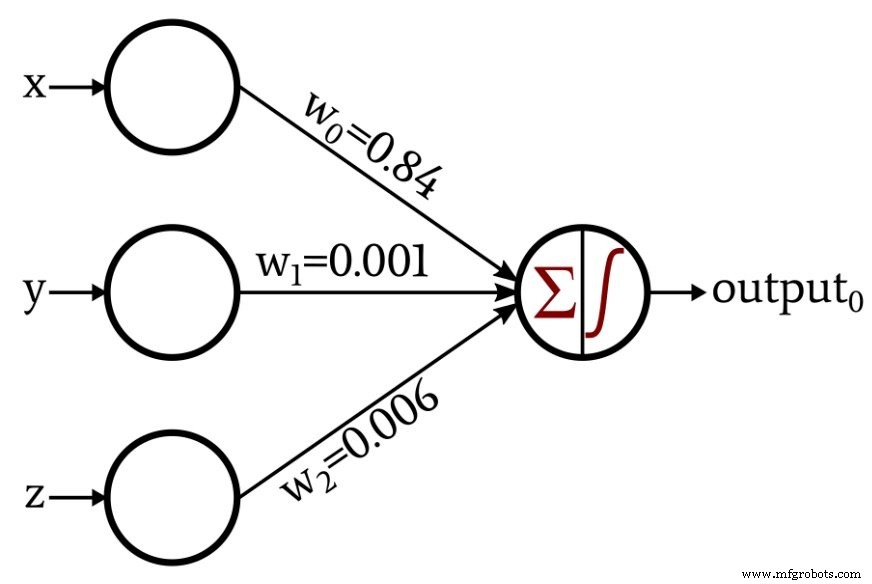
Après entraînement sur 1 000 points synthétiques pour notre classifieur valide/invalide, le perceptron a automatiquement découvert le vecteur de poids approprié, qui correspond maintenant à la solution dérivée manuellement :
Qu'est-ce qui suit ?
Dans l'article à venir, nous parcourrons une implémentation Python concise d'un perceptron monocouche et détaillerons la routine d'entraînement qui a produit les poids montrés ci-dessus. Restez à l'écoute pour apprendre comment coder et entraîner votre propre perceptron à partir de zéro.
Embarqué
- Sécuriser la Technologie Cloud : Meilleures Pratiques pour Protection Données et Atténuation Risques
- Exploiter Azure DevOps : Pratiques Prouvées pour une Livraison Accélérée
- Comprendre les protocoles réseau : de la couche physique à l'arbitrage avancé
- Comment les réseaux connectés révolutionnent l'agriculture moderne
- Utilisation de realloc() en C : Syntaxe, bonnes pratiques et exemple
- Maîtriser la fonction free() en C : Guide pratique et exemple
- Exploiter l'analytique pour améliorer l'expérience client dans la fabrication
- Réseau de neurones NIST : détection de formes géométriques minuscules dans images denses avec 97% de précision
- Maîtriser les techniques de la rectifieuse d'outils : guide pratique