



Entraînement d'un perceptron de base en Python : guide pas à pas
Entraînement d'un perceptron de base en Python
Ce guide vous accompagne à travers une implémentation Python entièrement commentée qui apprend automatiquement les poids pour un perceptron monocouche. Le code est prêt à copier-coller, exécuter, et adapter à vos propres données.
Explorez la série Perceptron d'AAC
Pour un contexte plus profond ou pour sauter vers des sujets avancés, consultez le reste de nos articles :
- Comment effectuer une classification avec un réseau de neurones : qu'est-ce que le perceptron ?
- Comment utiliser un exemple simple de réseau de neurones perceptron pour classifier des données
- Comment entraîner un perceptron de base
- Comprendre l'entraînement simple de réseau de neurones
- Introduction à la théorie de l'entraînement pour réseaux de neurones
- Comprendre le taux d'apprentissage dans les réseaux de neurones
- Apprentissage automatique avancé avec le perceptron multicouche
- La fonction d'activation sigmoïde : activation dans les réseaux de neurones perceptron multicouches
- Comment entraîner un perceptron multicouche
- Comprendre les formules d'entraînement et la rétropropagation pour perceptrons multicouches
- Architecture de réseau de neurones pour une implémentation Python
- Comment créer un perceptron multicouche en Python
- Traitement du signal avec réseaux de neurones : validation dans la conception de réseaux de neurones
- Jeux de données d'entraînement pour réseaux de neurones : comment entraîner et valider un réseau de neurones Python
Classification avec un perceptron monocouche
Nous commençons avec un problème classique de classification binaire dans l'espace 3D. L'architecture du réseau est une couche cachée unique avec trois nœuds d'entrée et un nœud de sortie qui utilise une fonction d'activation à seuil unitaire.
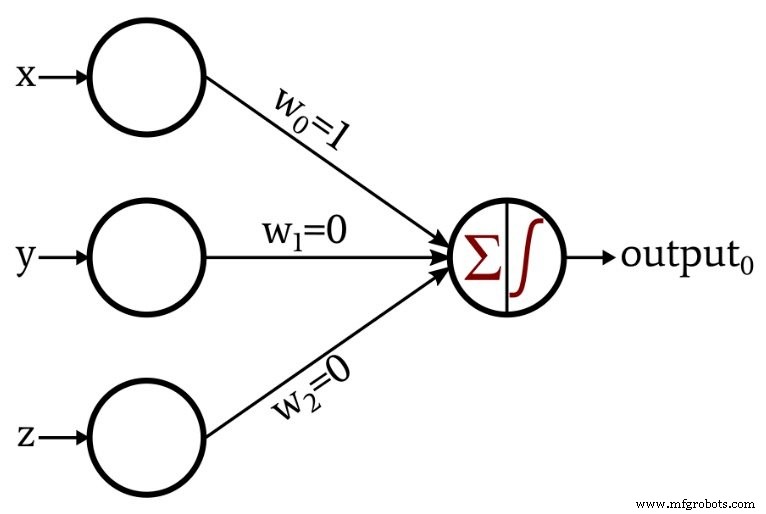
Le nœud de sortie applique la fonction à seuil unitaire suivante :
\[f(x)=\begin{cases}0 & x < 0\\1 & x \ge 0\end{cases}\]
Pour illustrer l'apprentissage, nous étendons l'architecture pour ajuster automatiquement ses poids via une boucle d'entraînement simple :
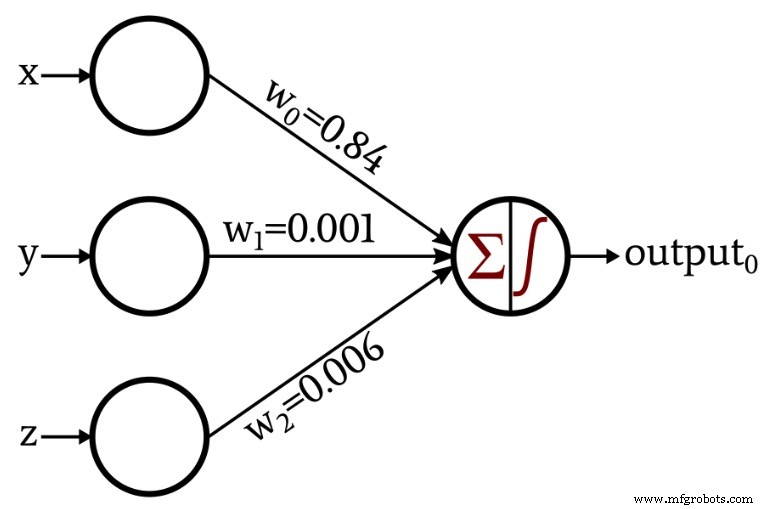
Une implémentation Python
Le script suivant lit les données d'entraînement depuis un fichier Excel, initialise les poids aléatoirement, et les met à jour itérativement en utilisant la règle d'apprentissage du perceptron.
 import pandas
import numpy as np
# Dimensionalité de l'espace d'entrée (x, y, z)
input_dim = 3
# Taux d'apprentissage contrôle l'amplitude d'ajustement des poids
learning_rate = 0.01
# Poids initiaux aléatoires ; vous pouvez fixer des valeurs pour reproductibilité
Weights = np.random.rand(input_dim)
# Weights = np.array([0.5, 0.5, 0.5])
# Charger le jeu de données : une feuille avec colonnes pour chaque caractéristique et une colonne 'output'
Training_Data = pandas.read_excel("3D_data.xlsx")
# Séparer les sorties attendues de la matrice de caractéristiques
Expected_Output = Training_Data.output
Training_Data = Training_Data.drop(["output"], axis=1)
# Convertir en tableau NumPy pour opérations vectorisées
Training_Data = np.asarray(Training_Data)
training_count = len(Training_Data[:, 0])
# Entraîner sur plusieurs époques
for epoch in range(5):
    for datum in range(training_count):
        # Somme pondérée des entrées
        Output_Sum = np.sum(np.multiply(Training_Data[datum, :], Weights))
        # Appliquer l'activation à seuil unitaire
        Output_Value = 0 if Output_Sum < 0 else 1
        # Calculer l'erreur entre sortie attendue et réelle
        error = Expected_Output[datum] - Output_Value
        # Mettre à jour chaque poids selon la règle d'apprentissage
        for n in range(input_dim):
            Weights[n] += learning_rate * error * Training_Data[datum, n]
print(f"w_0 = {Weights[0]:.3f}")
print(f"w_1 = {Weights[1]:.3f}")
print(f"w_2 = {Weights[2]:.3f}")
Concepts clés expliqués
Configuration du réseau et organisation des données
Le réseau a trois nœuds d'entrée pour correspondre aux coordonnées 3D. Le taux d'apprentissage de 0,01 est un point de départ standard ; vous pouvez l'ajuster après expérimentation. Les poids sont initialisés aléatoirement pour éviter la symétrie, mais vous pouvez les fixer à une valeur constante si vous voulez un comportement déterministe.
Les données d'entraînement sont lues depuis un fichier Excel, séparées en entrées et sorties attendues, puis converties en tableau NumPy pour calcul efficace.
Calcul des valeurs de sortie
Chaque époque itère sur tous les échantillons d'entraînement. Pour chaque échantillon, la somme pondérée des entrées est calculée. La fonction à seuil unitaire mappe alors cette somme à une sortie binaire : 0 si la somme est négative, 1 sinon.
Mise à jour des poids
Quand la sortie prédite diffère de la sortie attendue, la règle d'apprentissage du perceptron ajuste chaque poids proportionnellement à la valeur d'entrée, l'erreur, et le taux d'apprentissage :
\[w_{new} = w + (\alpha \times \delta \times input)\]
où \(\delta = \text{output}_{expected} - \text{output}_{calculated}\) et \(\alpha\) est le taux d'apprentissage.
Conclusion
Vous avez maintenant vu une implémentation complète, annotée, d'un perceptron monocouche en Python. Le code est une base solide pour expérimenter avec différents jeux de données, taux d'apprentissage, ou même étendre le réseau à plusieurs sorties dans de futurs projets.
Embarqué
- Systèmes de détection d'intrusion : protéger votre réseau avec alertes intelligentes
- Comment devenir électricien automobile : formation, tâches et perspectives de carrière
- Durcir les dispositifs IoT industriels pour prévenir les cyberattaques
- CEVA dévoile NeuPro-S : processeur IA nouvelle génération pour inférence réseaux neuronaux profonds en edge
- Raspberry Pi et HDC2010 : guide complet de configuration du capteur I2C température et humidité
- Découvrez votre clé de sécurité réseau : étapes simples pour trouver et protéger votre Wi‑Fi
- 5 stratégies essentielles de sécurité réseau pour les petites entreprises
- Évaluer la Sécurité de Votre Réseau d'Atelier : Êtes-vous Prêt ?
- Préparer les talents de demain pour l'industrie 4.0 : stratégies de formation pour l'usine digitale