



Intégrer des accélérateurs dédiés dans RISC-V pour charges de travail IA, AR/VR et vision
Quand l'écosystème RISC-V a émergé, l'objectif principal était de réduire les coûts dans les systèmes profondément embarqués qui reposaient auparavant sur des architectures de jeu d'instructions (ISA) CPU propriétaires. Alors que les SoC migraient vers des processus FinFET, les coûts élevés de masque ont poussé de nombreux concepteurs à remplacer les machines à états finis par des micro-séquenceurs programmables basés sur l'ISA RISC-V. Ce changement a suscité l'enthousiasme initial et, de 2014 à 2018, a mené à la commoditisation des cœurs RISC-V légers.
À mesure que l'architecture mûrissait, RISC-V a gagné du terrain dans les applications temps réel haute performance — particulièrement comme frontal pour des moteurs d'accélération hautement spécialisés pour l'IA, AR/VR et vision par ordinateur. La nature ouverte de RISC-V permet aux concepteurs d'étendre l'ISA, permettant aux processeurs de communiquer avec les accélérateurs via des interfaces co-processeur à faible latence plutôt que via I/O mémoire-mappé traditionnel.
L'extension vectorielle RISC-V a encore renforcé ces accélérateurs pour traiter les couches intermédiaires dans les boucles internes des noyaux. Cependant, cela nécessitait des extensions sur mesure, comme une instruction de chargement personnalisée qui transfère des données d'un accélérateur externe vers les registres vectoriels internes.
Ces applications exigent un modèle de programmation qui équilibre efficacité et flexibilité. Un accélérateur dédié au domaine — essentiellement un grand réseau de multiplicateurs — est hautement efficace mais limité dans les opérations qu'il peut effectuer et dans ses capacités de mouvement de données. En contraste, un CPU généraliste comme x86 offre une flexibilité maximale, mais la plupart des conceptions ne peuvent pas se permettre le budget énergétique de >100 W requis pour une telle polyvalence.
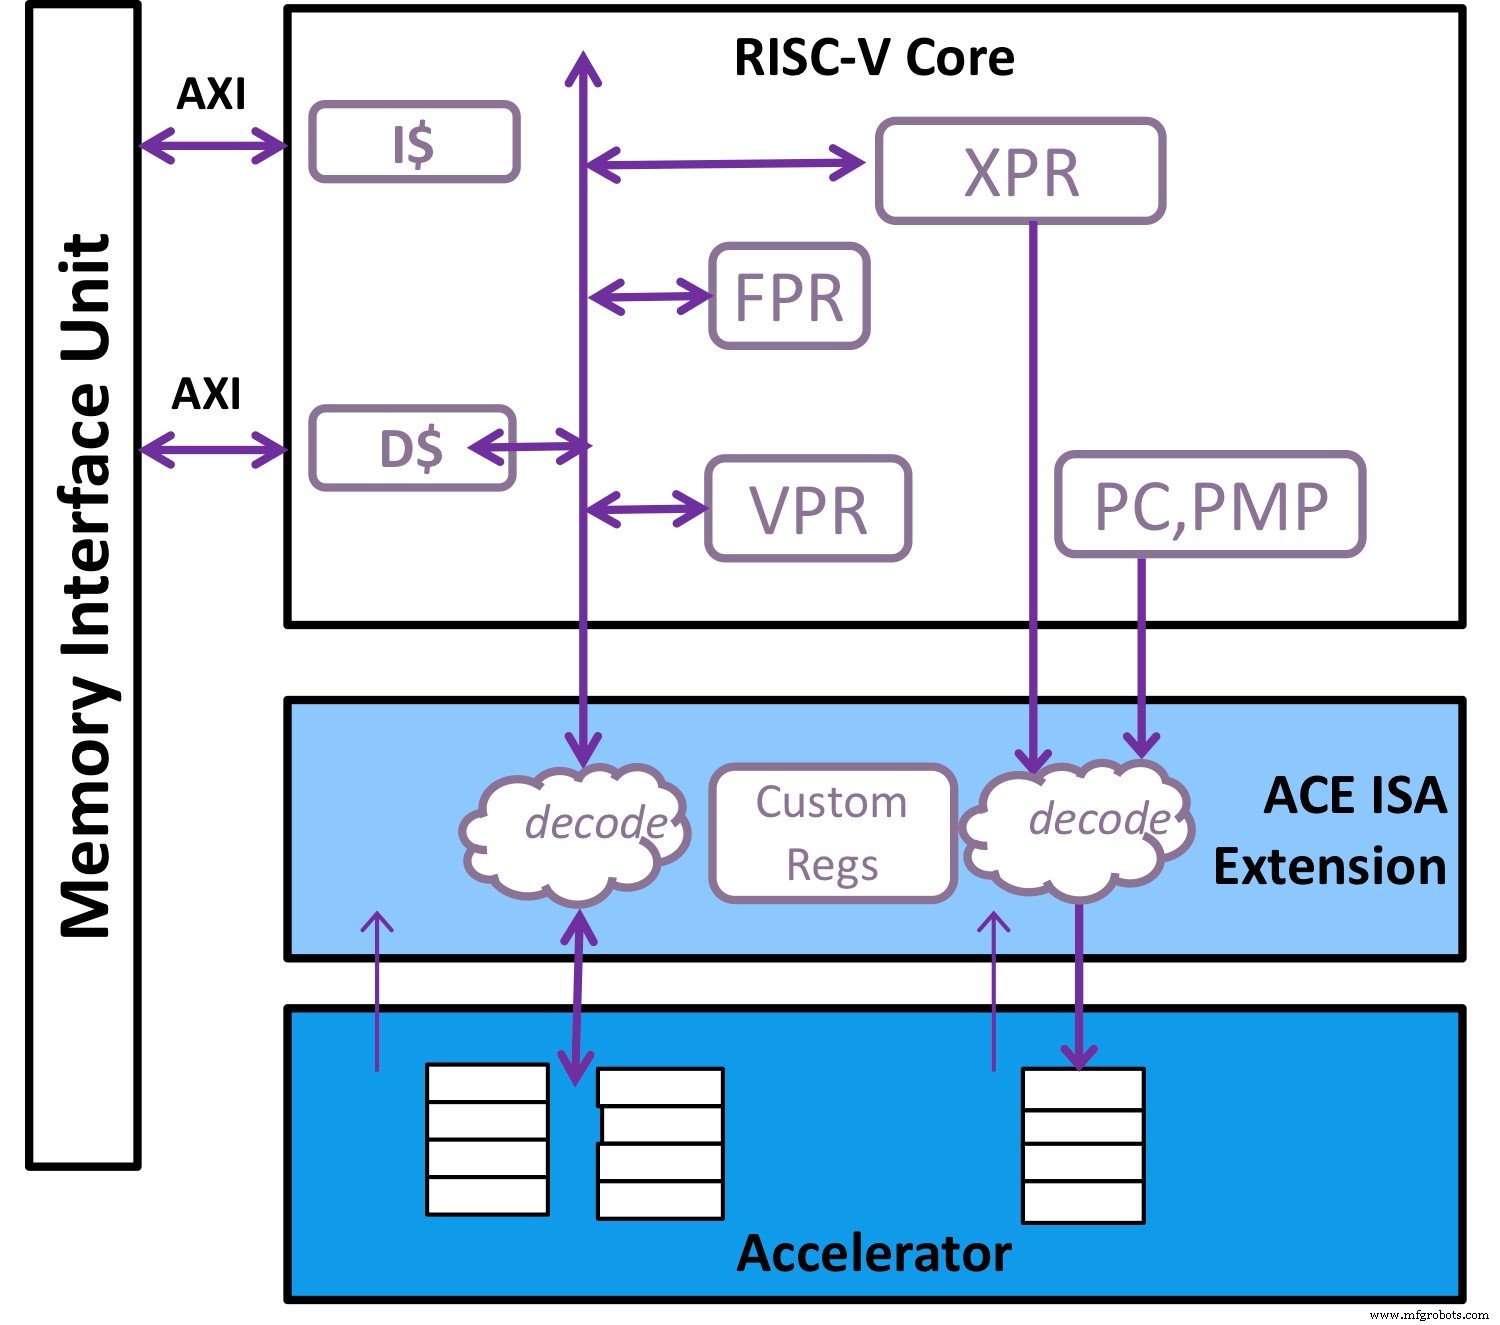
L'extension vectorielle standard dans RISC-V augmentée d'instructions personnalisées spécialisées est un compagnon idéal pour l'accélérateur (Image : Andes Technology)
La solution optimale mélange la flexibilité d'un CPU généraliste avec un accélérateur spécifique à la tâche, comme illustré ci-dessus. Dans RISC-V, l'extension vectorielle standard en maturation — augmentée d'instructions personnalisées sur mesure — sert de partenaire parfait. Cette synergie est devenue évidente ces 18 derniers mois, alors que les solutions d'accélération spécifique au domaine (DSA) convergent vers des plateformes RISC-V.
Pour permettre cette vision, l'accélérateur doit exécuter son propre jeu de commandes en utilisant ses ressources dédiées, incluant la mémoire. Le cœur RISC-V doit aplatir le microcode, empaquetant toute l'information de contrôle nécessaire en une seule commande. Ce jeu de commandes doit être conscient des registres scalaires et vectoriels du processeur, ainsi que des registres de contrôle et mémoire propres à l'accélérateur.
Quand l'accélérateur a besoin d'assistance pour du réordonnancement ou manipulation de données spécialisés, l'architecture d'Andes emploie une unité de traitement vectoriel (VPU) pour gérer les permutations complexes — décalage, rassemblement, compression, expansion. Entre les couches, les noyaux impliquent souvent des motifs de données complexes ; la VPU fournit la flexibilité nécessaire. Avec à la fois l'accélérateur et la VPU exécutant des calculs massivement parallèles, Andes a introduit du matériel pour augmenter la bande passante du sous-système mémoire — préchargement, transactions non-bloquantes, retours out-of-order — pour répondre à la demande computationnelle.
Le premier processeur vectoriel RISC-V d'Andes Technology, le NX27V, implémente la dernière spécification V-extension 0.8. Il supporte les opérations entières 8, 16 et 32 bits, calculs flottants 16 et 32 bits, Bfloat16, et formats Int4 pour réduire le stockage et la bande passante de transfert pour les poids d'apprentissage machine. La flexibilité de la spec vectorielle permet aux concepteurs de configurer des paramètres clés — longueur vectorielle, bits par registres, largeur SIMD, et nombre de bits traités par cycle.
Le NX27V offre une longueur vectorielle de 512 bits extensible à 4096 bits en chainant jusqu'à huit registres vectoriels. De multiples unités fonctionnelles opèrent en pipelines parallèles, soutenant le débit requis par des charges de travail diverses. En configuration 512 bits, la puce atteint 1 GHz en processus 7 nm dans les pires conditions, occupant seulement 0,3 mm². Pour le développement logiciel, Andes fournit un compilateur, débogueur, bibliothèques vectorielles, simulateur de cycles et l'outil de visualisation Clarity pour analyser et optimiser les boucles critiques. La solution est déjà disponible via un programme d'accès anticipé.
Au cours des 15 derniers mois, la demande pour le calcul haute performance — combinant une puissante extension vectorielle RISC-V, un sous-système mémoire haute bande passante et un accélérateur positionné près du CPU — a explosé. Cette tendance est appelée à favoriser une adoption plus large de RISC-V et du traitement vectoriel dans l'industrie.
> Cet article a été publié à l'origine sur notre site sœur, EE Times.
Embarqué
- IIC et OpenFog S'Unissent pour Mener le Distributed Computing pour l'IoT Industriel
- Architecture de référence de l'Internet industriel v1.8 publiée : introduction du motif Databus en couches
- Exploiter l'IoT pour la détection et la prévention précoces des incendies de forêt
- Connecter le monde lointain : comment l'IoT par satellite étend la couverture globale
- Production Interne : La Fuse 1 Imprime ses Propres Pièces
- Exploiter les données dans l'Internet de la fiabilité : stratégies pour une gestion efficace
- Edge Computing : L'architecture qui pilote les réseaux intelligents de demain
- Sécuriser votre écosystème IoT : stratégies expertes contre ransomware et cybermenaces
- L'IoT révolutionne les services sur le terrain : maintenance prédictive et ROI accru