



Entraînez votre perceptron multicouche : stratégies éprouvées pour une performance optimale
Nous pouvons grandement améliorer la performance d'un Perceptron en ajoutant une couche de nœuds cachés, mais ces nœuds cachés compliquent aussi un peu l'entraînement.
Jusqu'ici dans la série AAC sur les réseaux de neurones, vous avez appris la classification de données utilisant les réseaux de neurones, surtout de la variété Perceptron.
Rattrapez la série ci-dessous ou plongez dans cette nouvelle entrée qui expliquera les bases du réseau de neurones perceptron multicouche (MLP).
- Comment effectuer une classification avec un réseau de neurones : qu'est-ce que le perceptron ?
- Comment utiliser un exemple simple de réseau de neurones perceptron pour classifier des données
- Comment entraîner un perceptron de base
- Comprendre l'entraînement simple de réseau de neurones
- Introduction à la théorie de l'entraînement pour réseaux de neurones
- Comprendre le taux d'apprentissage dans les réseaux de neurones
- Apprentissage automatique avancé avec le perceptron multicouche
- La fonction d'activation sigmoïde : activation dans les réseaux de neurones perceptron multicouches
- Comment entraîner un perceptron multicouche
- Comprendre les formules d'entraînement et la rétropropagation pour perceptrons multicouches
- Architecture de réseau de neurones pour une implémentation Python
- Comment créer un perceptron multicouche en Python
- Traitement du signal avec réseaux de neurones : validation dans la conception de réseaux de neurones
- Jeux de données d'entraînement pour réseaux de neurones : comment entraîner et valider un réseau de neurones Python
Qu'est-ce qu'un réseau de neurones perceptron multicouche ?
L'article précédent a démontré qu'un Perceptron monocouche ne peut tout simplement pas produire le genre de performance que nous attendons d'une architecture de réseau de neurones moderne. Un système limité aux fonctions linéairement séparables ne pourra pas approximer les relations entrée-sortie complexes qui se produisent dans les scénarios réels de traitement du signal. La solution est un perceptron multicouche (MLP), tel que celui-ci :
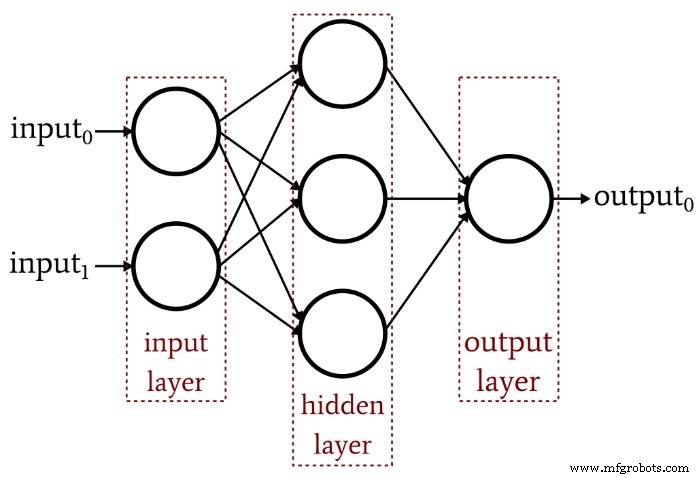
En ajoutant cette couche cachée, nous transformons le réseau en un « approximateur universel » qui peut atteindre une classification extrêmement sophistiquée. Mais nous devons toujours nous rappeler que la valeur d'un réseau de neurones dépend entièrement de la qualité de son entraînement. Sans données d'entraînement abondantes, diversifiées et une procédure d'entraînement efficace, le réseau n'apprendra jamais « comment » classifier les échantillons d'entrée.
Pourquoi la couche cachée complique l'entraînement ?
Regardons la règle d'apprentissage que nous avons utilisée pour entraîner un Perceptron monocouche dans un article précédent :
\[w_{new} = w+(\alpha\times(output_{expected}-output_{calculated})\times input)\]
Remarquez l'hypothèse implicite dans cette équation : nous mettons à jour les poids basés sur la sortie observée, donc pour que cela fonctionne, les poids du Perceptron monocouche doivent influencer directement la valeur de sortie. C'est comme choisir la température de l'eau du robinet en tournant les deux boutons pour l'eau chaude et froide. La relation entre la température globale et l'action des boutons est assez simple, et même ceux qui n'aiment pas les maths peuvent trouver la température désirée en bidouillant les boutons un moment.
Mais imaginez maintenant que le flux d'eau dans les tuyaux chaud et froid est lié à la position du bouton d'une manière complexe et hautement non linéaire. Vous tournez régulièrement et lentement le bouton pour l'eau chaude, mais le débit résultant varie erratiquement. Vous essayez le bouton pour l'eau froide et il fait la même chose. Trouver la température idéale sous ces conditions — surtout puisque la « sortie » doit être atteinte par une combinaison de deux relations de contrôle confuses — serait beaucoup plus difficile.
C'est ainsi que je comprends le dilemme de la couche cachée. Les poids qui connectent les nœuds d'entrée aux nœuds cachés sont conceptuellement analogues à ces boutons mécaniquement erratiques — parce que les poids entrée-vers-cachée n'ont pas de chemin direct vers la couche de sortie, la relation entre ces poids et la sortie du réseau est si complexe que la règle d'apprentissage simple montrée ci-dessus ne sera pas efficace.
Un nouveau paradigme d'entraînement
Puisque la règle d'apprentissage originale du Perceptron ne peut pas être appliquée aux réseaux multicouches, nous devons repenser notre stratégie d'entraînement. Ce que nous allons faire est d'incorporer la descente de gradient et la minimisation d'une fonction d'erreur.
Une chose à garder à l'esprit est que cette procédure d'entraînement n'est pas spécifique aux réseaux de neurones multicouches. La descente de gradient vient de la théorie d'optimisation générale, et la procédure d'entraînement que nous employons pour les MLP est aussi applicable aux réseaux monocouches. Cependant, selon ma compréhension, la descente de gradient style MLP est (au moins théoriquement) inutile pour un Perceptron monocouche, parce que la règle plus simple montrée ci-dessus finira par faire le travail.
Dériver les équations réelles de mise à jour des poids pour un MLP implique des maths intimidantes que je n'essaierai pas d'expliquer intelligemment à ce stade. Mon objectif pour le reste de cet article est de fournir une introduction conceptuelle à deux aspects clés de l'entraînement MLP — la descente de gradient et la fonction d'erreur — et puis nous continuerons cette discussion dans le prochain article en incorporant une nouvelle fonction d'activation.
Descente de gradient
Comme son nom l'implique, la descente de gradient est un moyen de descendre vers le minimum d'une fonction d'erreur basé sur la pente. Le diagramme ci-dessous transmet la façon dont un gradient nous donne de l'information sur comment modifier les poids — la pente d'un point sur la fonction d'erreur nous dit dans quelle direction aller et à quelle distance nous sommes du minimum.
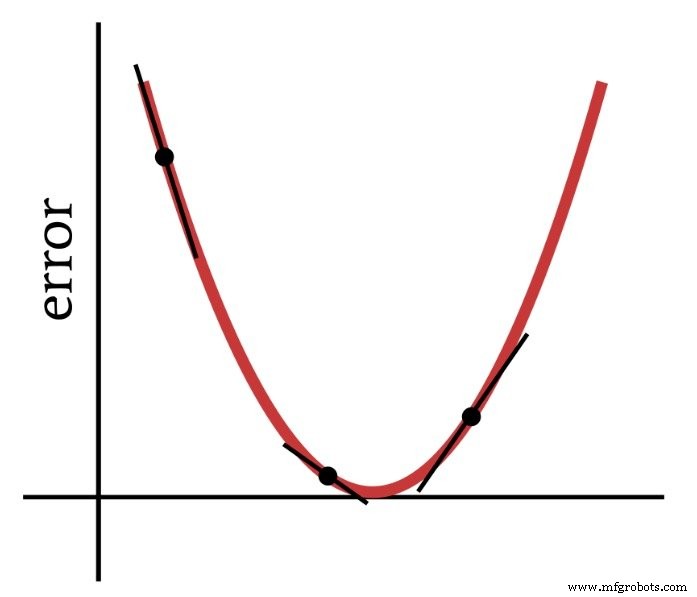
Ainsi, la dérivée de la fonction d'erreur est un élément important des calculs que nous utilisons pour entraîner un perceptron multicouche. En fait, nous aurons besoin de dérivées partielles ici. Quand nous implémentons la descente de gradient, nous faisons chaque modification de poids proportionnelle à la pente de la fonction d'erreur par rapport au poids étant modifié.
La fonction d'erreur (AKA fonction de perte)
Une méthode courante de quantifier l'erreur d'un réseau de neurones est de mettre au carré la différence entre la valeur attendue (ou « cible ») et la valeur calculée pour chaque nœud de sortie, et puis de sommer toutes ces différences carrées. Vous pouvez appeler cela « somme des différences carrées » ou « erreur quadratique sommée » ou peut-être divers autres noms, et vous verrez aussi l'abréviation LMS, qui signifie least-mean-square, parce que le but de l'entraînement est de minimiser l'erreur quadratique moyenne. Cette fonction d'erreur (dénotée par E) peut être exprimée mathématiquement comme suit :
\[E=\frac{1}{2}\sum_k(t_k-o_k)^2\]
où k indique la plage des nœuds de sortie, t est la valeur de sortie cible, et o est la valeur de sortie calculée.
Conclusion
Nous avons posé les bases pour entraîner avec succès un perceptron multicouche, et nous continuerons à explorer ce sujet intéressant dans le prochain article.
Robot industriel
- Comprendre les topologies de réseau : du point-à-point à l'anneau et l'étoile
- Durcir les dispositifs IoT industriels pour prévenir les cyberattaques
- CEVA dévoile NeuPro-S : processeur IA nouvelle génération pour inférence réseaux neuronaux profonds en edge
- Comment les réseaux connectés révolutionnent l'agriculture moderne
- Comment les réseaux intelligents pilotent l'efficacité et la croissance business
- Découvrez votre clé de sécurité réseau : étapes simples pour trouver et protéger votre Wi‑Fi
- Réseaux de neurones artificiels boostent les performances des communications sans fil
- Évaluer la Sécurité de Votre Réseau d'Atelier : Êtes-vous Prêt ?
- Préparer les talents de demain pour l'industrie 4.0 : stratégies de formation pour l'usine digitale