



Data Lake vs Big Data : choisir la bonne approche pour l'industrie
« Data lake » et « Big Data » sont deux termes modernes souvent mal compris et utilisés à tort. En raison des volumes importants impliqués, ils sont parfois utilisés indifféremment. Pourtant, data lake et Big Data sont distincts, même si leurs définitions actuelles ne sont pas encore pleinement stabilisées.
Figure 1. Les données modernes proviennent de nombreuses sources et sont de types variés. Image utilisée avec l'autorisation d'Analytics Vidhya.
Commençons par un bref contexte historique. Fin des années 2000, avec l'explosion des réseaux sociaux (Facebook, Twitter), de nombreux data scientists ont réalisé le potentiel de ces plateformes pour générer d'énormes volumes de données personnelles précieuses. De nouvelles applications logicielles ont été développées pour faciliter le traitement et l'analyse. Exemple marquant : Apache Hadoop, une boîte à outils d'applications open-source capable de traiter des volumes Big Data.
La décennie suivante a vu l'arrivée de l'Internet des Objets (IoT). Cela a ouvert la porte à des millions de sources de données supplémentaires donnant un aperçu des préférences et habitudes des personnes, tout en renvoyant des informations sur les produits eux-mêmes.
Simultanément, le machine learning a fait des avancées majeures et trouvé des applications pratiques dans l'industrie. Cela a accru le besoin de gérer de gros volumes de données dans l'industrie, particulièrement dans les processus automatisés.
Toutes les projections indiquent que la quantité globale de données disponible continuera de croître à un rythme accéléré. Pour référence, en 2016, le monde a franchi le cap de 1 Zettaoctet de trafic internet annuel généré. 1 Zettaoctet = 1 000 milliards de Gigaoctets.
Le trafic internet annuel devrait dépasser 3 Zettaoctets en 2021. Ces projections, couplées aux capacités étendues du cloud computing, suggèrent que la valeur et les usages du Big Data (et des data lakes) ne font que commencer.
Qu'est-ce que le Big Data ?
Vu sous l'angle purement volumétrique, la définition du Big Data est une cible mobile. À mesure que les volumes de données et d'espace de stockage croissent, le seuil de ce qui est considéré comme « grande quantité d'information » augmente aussi.
Aujourd'hui, un référentiel de données de 100 Téraoctets ou plus est généralement considéré dans la gamme du Big Data. Les grands référentiels comme ceux des réseaux sociaux peuvent atteindre plusieurs Pétaoctets.
Autre référence : quand la quantité d'information ne peut plus être gérée par les outils informatiques traditionnels, comme SQL. Exemple : aujourd'hui, des bases de données de 1 To/an ne sont pas rares. Mais avec des applications SQL de plus en plus puissantes, cette magnitude reste gérable ; elles ne sont donc pas typiquement considérées comme Big Data.
Le modèle 4V du Big Data
Nous avons regardé la définition par le volume. Trois autres facteurs importants : vélocité, variété, véracité. Ensemble avec le volume, ils forment le modèle 4V.
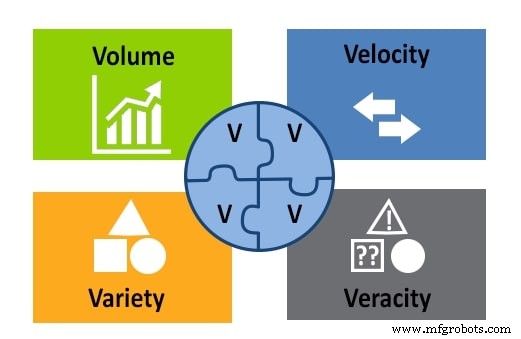
Figure 2. Le modèle 4V du Big Data : Volume, vélocité, variété, véracité. Image utilisée avec l'autorisation d'APSense.
Variété : tous les types de données stockés dans un référentiel Big Data : texte, images, son, vidéo, etc. Aussi le fait que les données proviennent de multiples sources.
Vélocité : considération importante car l'information afflue en continu. La vélocité concerne la vitesse de collecte, génération et distribution des données.
Véracité : mesure l'exactitude et la qualité des données pour évaluer si un data scientist peut les utiliser pour l'analyse et en tirer des conclusions.
Maintenant que nous comprenons le Big Data, passons aux data lakes avant d'aborder leur utilisation dans un système de contrôle.
Qu'est-ce qu'un Data Lake ?
Les data lakes sont des référentiels centralisés de grandes quantités de données brutes — informations qui peuvent ou non être précieuses à l'avenir et dont le but n'est pas encore connu à 100 %. Les data lakes peuvent stocker bases de données relationnelles et non relationnelles, ainsi que d'autres types de fichiers et entités.
Bien que l'information dans un data lake ne soit pas traitée ni organisée, elle est structurée de façon que toutes les entrées et sorties soient considérées pour créer une bonne architecture.
Data Lake vs Big Data
Un data lake est une instance d'application Big Data. Il suit les critères du modèle 4V, avec quelques particularités. En volume, les data lakes se situent en moyenne vers le bas de ce qui est considéré comme Big Data.
L'information dans les data lakes a de la variété, mais à condition qu'il s'agisse uniquement de données brutes non traitées. Les vitesses d'entrée/sortie sont aussi pertinentes que pour tout système moderne, et les évaluations de qualité des données sont effectuées dans un data lake bien conçu.
Applications industrielles pour les données
L'automatisation avancée entraîne une augmentation rapide de l'information gérée sur le terrain d'usine. Grâce à cela, la fabrication et d'autres processus industriels entrent dans le domaine du Big Data, avec plusieurs activités métier employant désormais des outils comme les data lakes.
Exemple marquant : la maintenance prédictive. La capacité à prédire une défaillance mécanique ou électrique est très précieuse et génère des économies substantielles en coûts de réparation. Les data lakes sont des outils utiles pour compiler l'information provenant de fichiers journaux, capteurs multiples, et dispositifs d'entrée, afin de comprendre les tendances et prédire les problèmes.
Le machine learning est un concept où des robots reçoivent de l'information pour s'adapter à des conditions externes changeantes. La capture d'information ressemble à la maintenance prédictive, avec l'étape supplémentaire que les évaluations et modifications du processus sont automatiquement transmises au contrôleur système. Les données de machine learning peuvent être stockées dans un data lake structuré.
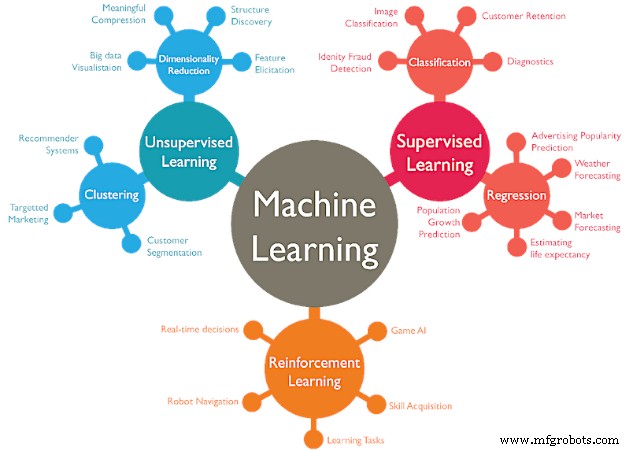
Figure 3. Le machine learning a plusieurs stratégies nécessitant chacune de grandes quantités de données. Image utilisée avec l'autorisation de WordStream.
En conclusion, un data lake est une instance d'application Big Data. Ces deux façons de voir les données peuvent travailler ensemble. En exploitant à la fois Big Data et data lake, un ingénieur contrôle peut prédire les pannes, créer des routines de maintenance, faire croître la transformation numérique de l'usine, et bien plus.
Et vous, à quoi utilisez-vous le Big Data et les data lakes dans votre travail ?
Technologie de l'Internet des objets
- Comment capteurs connectés et processeurs intelligents propulsent l'Industrie 4.0
- GE lance Predix Cloud : plateforme dédiée aux données et analytique industrielles
- Perspectives futures : faire progresser l'IIoT industriel pour l'excellence de production
- Top 4 des défis face à l'Internet industriel des objets (IIoT)
- Six principes clés pour construire des applications IoT pilotées par capteurs à fort impact
- Exploiter les RTU pour des insights Big Data dans les opérations industrielles
- Construire des fondations pour le succès de la data science industrielle
- IIoT Industriel : De la Capture de Données à la Prise de Décision Temps Réel
- Le Big Data Peut-Il Révolutionner les Budgets Santé ? Insights de Lux Research