



Construire des solutions IoT intelligentes avec TinyML et l'apprentissage automatique automatisé
L'IoT permet une surveillance continue des environnements et machines via des capteurs compacts. Les avancées rapides dans la conception des capteurs, microcontrôleurs et protocoles sans fil ont transformé les plateformes IoT en dispositifs abordables, produits en masse, avec diverses options de connectivité. Le faible coût de ces systèmes favorise leur déploiement massif dans les espaces publics, foyers et équipements industriels.
Ces capteurs collectent des données physiques 24/7, générant des flux massifs. Par exemple, accéléromètres et gyroscopes sur machines tournantes enregistrent vibrations et vitesse angulaire ; capteurs de qualité d'air suivent les polluants gazeux ; microphones dans babyphones écoutent constamment ; montres connectées mesurent fréquence cardiaque et autres signes vitaux. Magnétomètres, pression, température, humidité et capteurs de lumière ambiante fournissent aussi des informations environnementales en temps réel où qu'ils soient installés.
Les algorithmes de machine learning (ML) découvrent des motifs dans ces données impossibles à analyser manuellement. Associé à l'IoT, le ML propulse une nouvelle vague d'applications intelligentes — wearables, maisons intelligentes, usines Industrie 4.0, systèmes automobiles, vision machine, électronique grand public — grâce à l'inférence à faible puissance, faible latence et légère, connue sous le nom de tinyML.
TinyML avec apprentissage automatique automatisé
Déployer du ML sur de minuscules microcontrôleurs (MCU) offre plusieurs avantages clés :
- Confidentialité et sécurité des données : l'inférence se fait localement, gardant les données sur l'appareil et sur site.
- Économies d'énergie : transmission de données minimale ou nulle, réduisant drastiquement la consommation.
- Faible latence et haute disponibilité : l'inférence locale offre des temps de réponse au milliseconde, indépendants des conditions réseau.
cliquer pour image en taille réelle
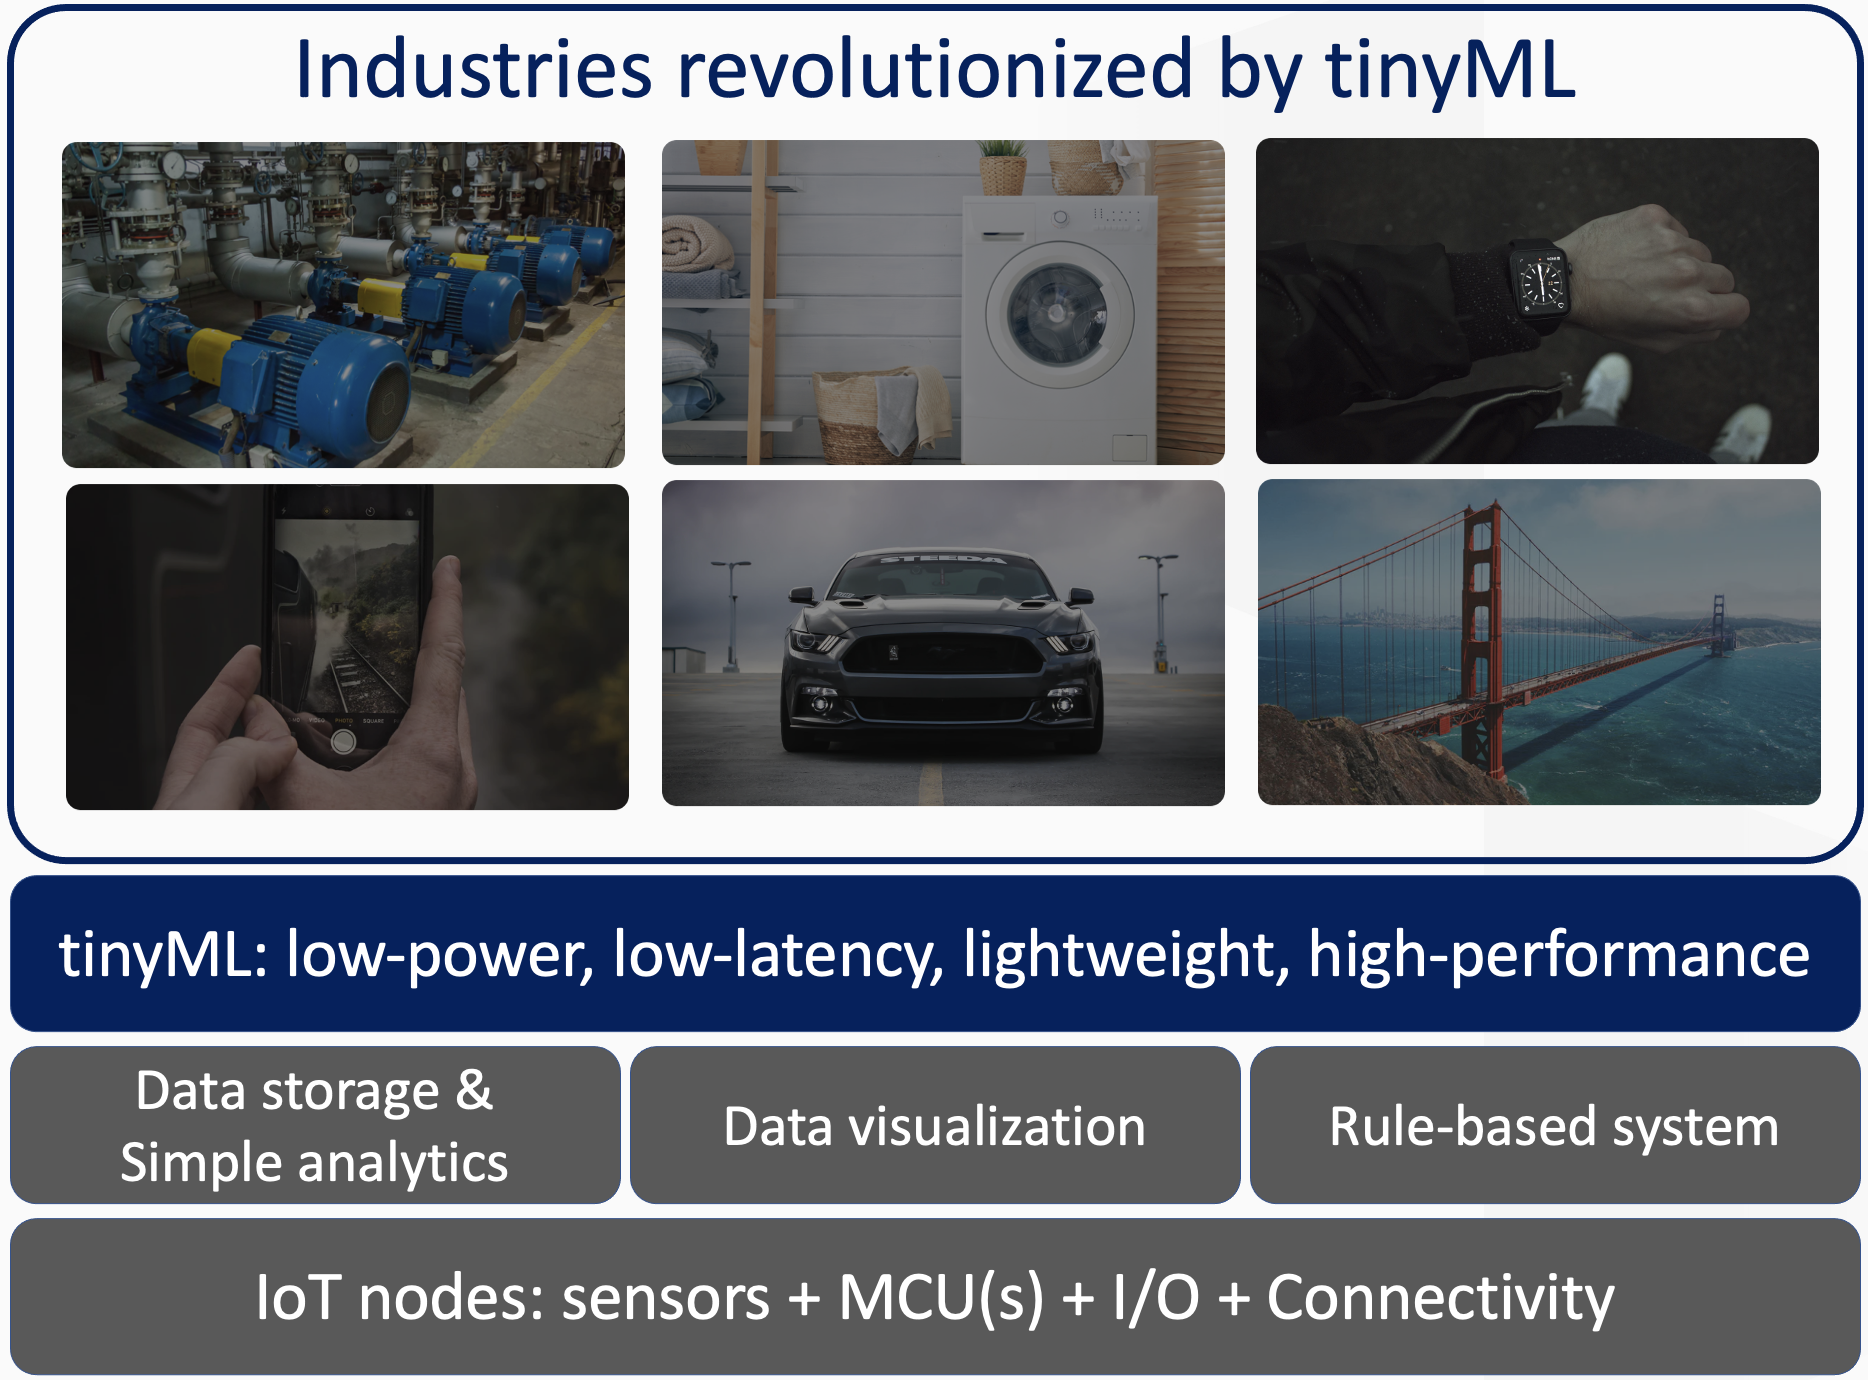
Figure 1 : tinyML ajoute des fonctionnalités avancées aux appareils IoT traditionnels (Source : Qeexo)
L'apprentissage automatique automatisé rationalise tout le flux de travail — de la configuration des capteurs et collecte de données à l'entraînement et au déploiement du modèle — via des plateformes comme Qeexo AutoML. Le système construit des modèles légers et performants pour les MCU ARM Cortex-M0 à M4 et autres environnements contraints.
cliquer pour image en taille réelle
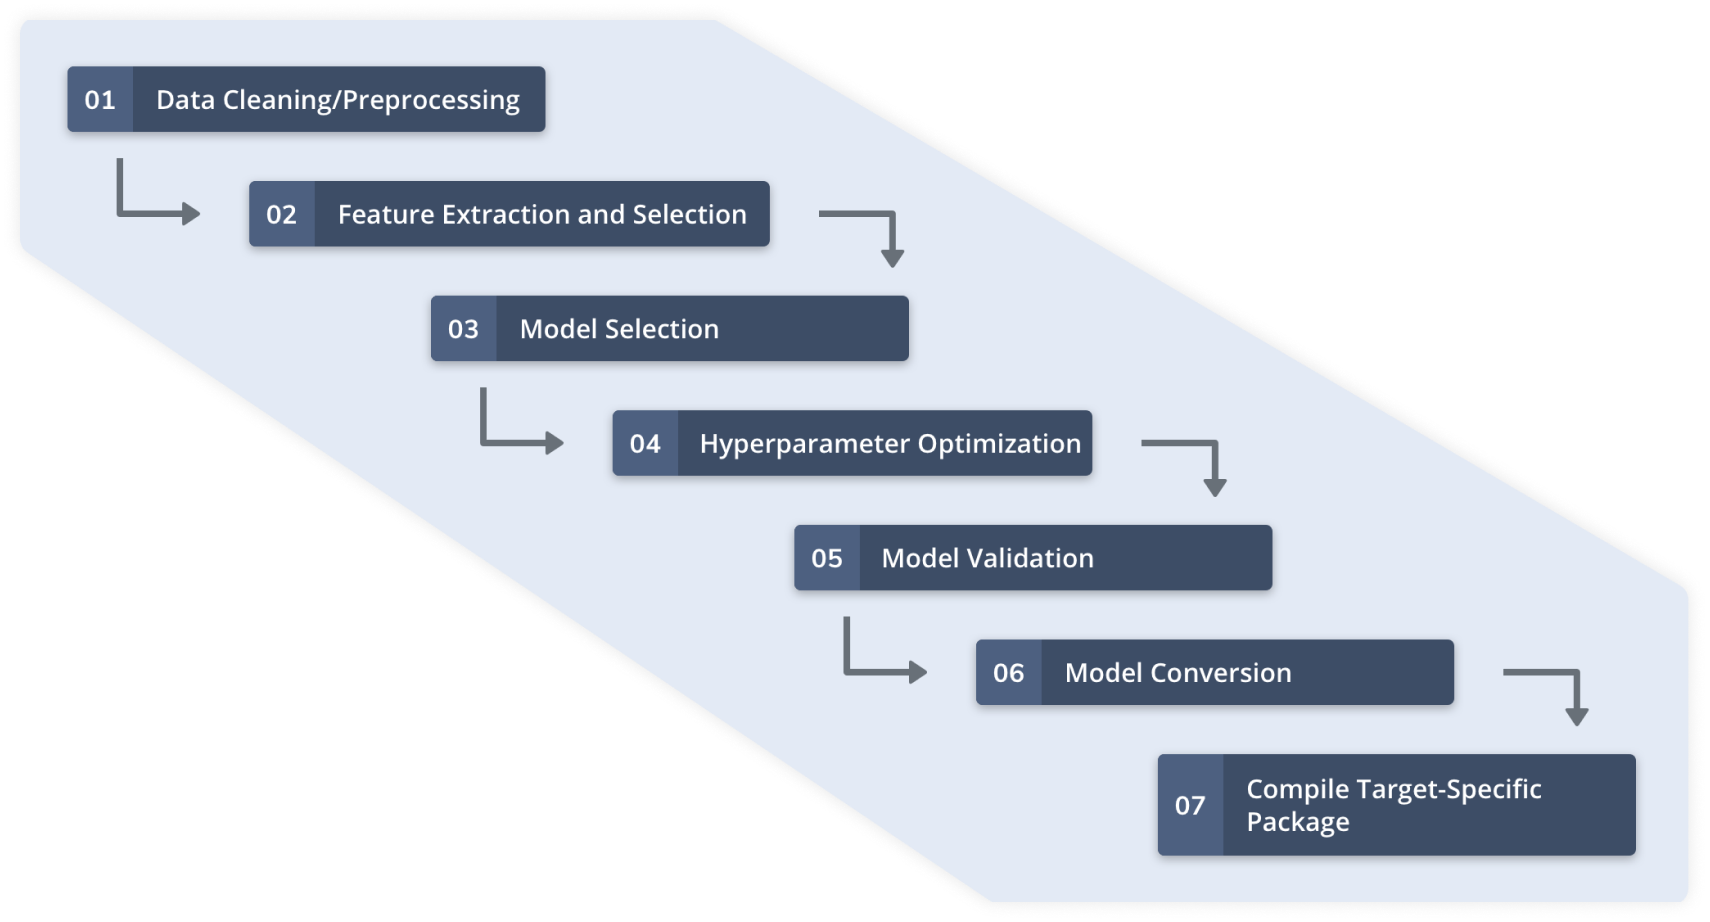
Figure 2 : Flux de travail Qeexo AutoML (Source : Qeexo)
TinyML avec architecture ARM® Cortex™ M0+
La croissance de l'IoT exige des MCU toujours plus petits et économes en énergie. Les puces ARM Cortex-M0+, cadencées à 48 MHz, sont courantes sur les cartes de capteurs car elles ne consomment que 7 mA par broche I/O — la moitié des 15 mA du Cortex-M4 supérieur, qui fonctionne à 64 MHz.
Cependant, l'architecture M0+ sacrifie mémoire et capacité de calcul. Elle ne supporte que des opérations en virgule fixe 32 bits, manque d'arithmétique de saturation et omet les fonctionnalités DSP. Par exemple, l'Arduino Nano 33 IoT (Cortex-M0+) offre 256 Ko de flash et 32 Ko de SRAM, tandis que l'Arduino Nano 33 BLE Sense (Cortex-M4) propose du flottant 32 bits, DSP, arithmétique de saturation, et quatre fois plus de flash et huit fois plus de SRAM.
Déployer du ML sur le M0+ présente trois défis majeurs :
- Calcul en virgule fixe : Le ML basé capteurs repose souvent sur traitement de signal, extraction de caractéristiques et inférence. Extraire des caractéristiques statistiques et fréquentielles (ex: FFT) de flux non stationnaires est essentiel pour des modèles de qualité, mais le faire en représentation virgule fixe tout en préservant la précision est difficile.
- Faible capacité mémoire : 256 Ko flash et 32 Ko SRAM contraignent la taille du modèle et la mémoire d'exécution. Des frontières de décision complexes nécessitent généralement des arbres profonds ou de nombreux boosters, augmentant l'usage mémoire. Réduire les modèles nuit souvent aux performances.
- Faible vitesse CPU : La latence au milliseconde importe pour les déploiements commerciaux. L'horloge 48 MHz du M0+ est substantiellement plus lente que les 64 MHz du M4, affectant la vitesse d'inférence.
Framework AutoML M0+
Qeexo AutoML relève ces obstacles avec un pipeline entièrement en virgule fixe optimisé pour le Cortex-M0+. Le flux de travail gère les données capteurs, le calcul de caractéristiques et l'inférence pour des ensembles d'arbres — GBM, RF et XGBoost — en utilisant des structures de données compactes et une logique d'inférence efficace. La Figure 3 illustre ce pipeline.
cliquer pour image en taille réelle
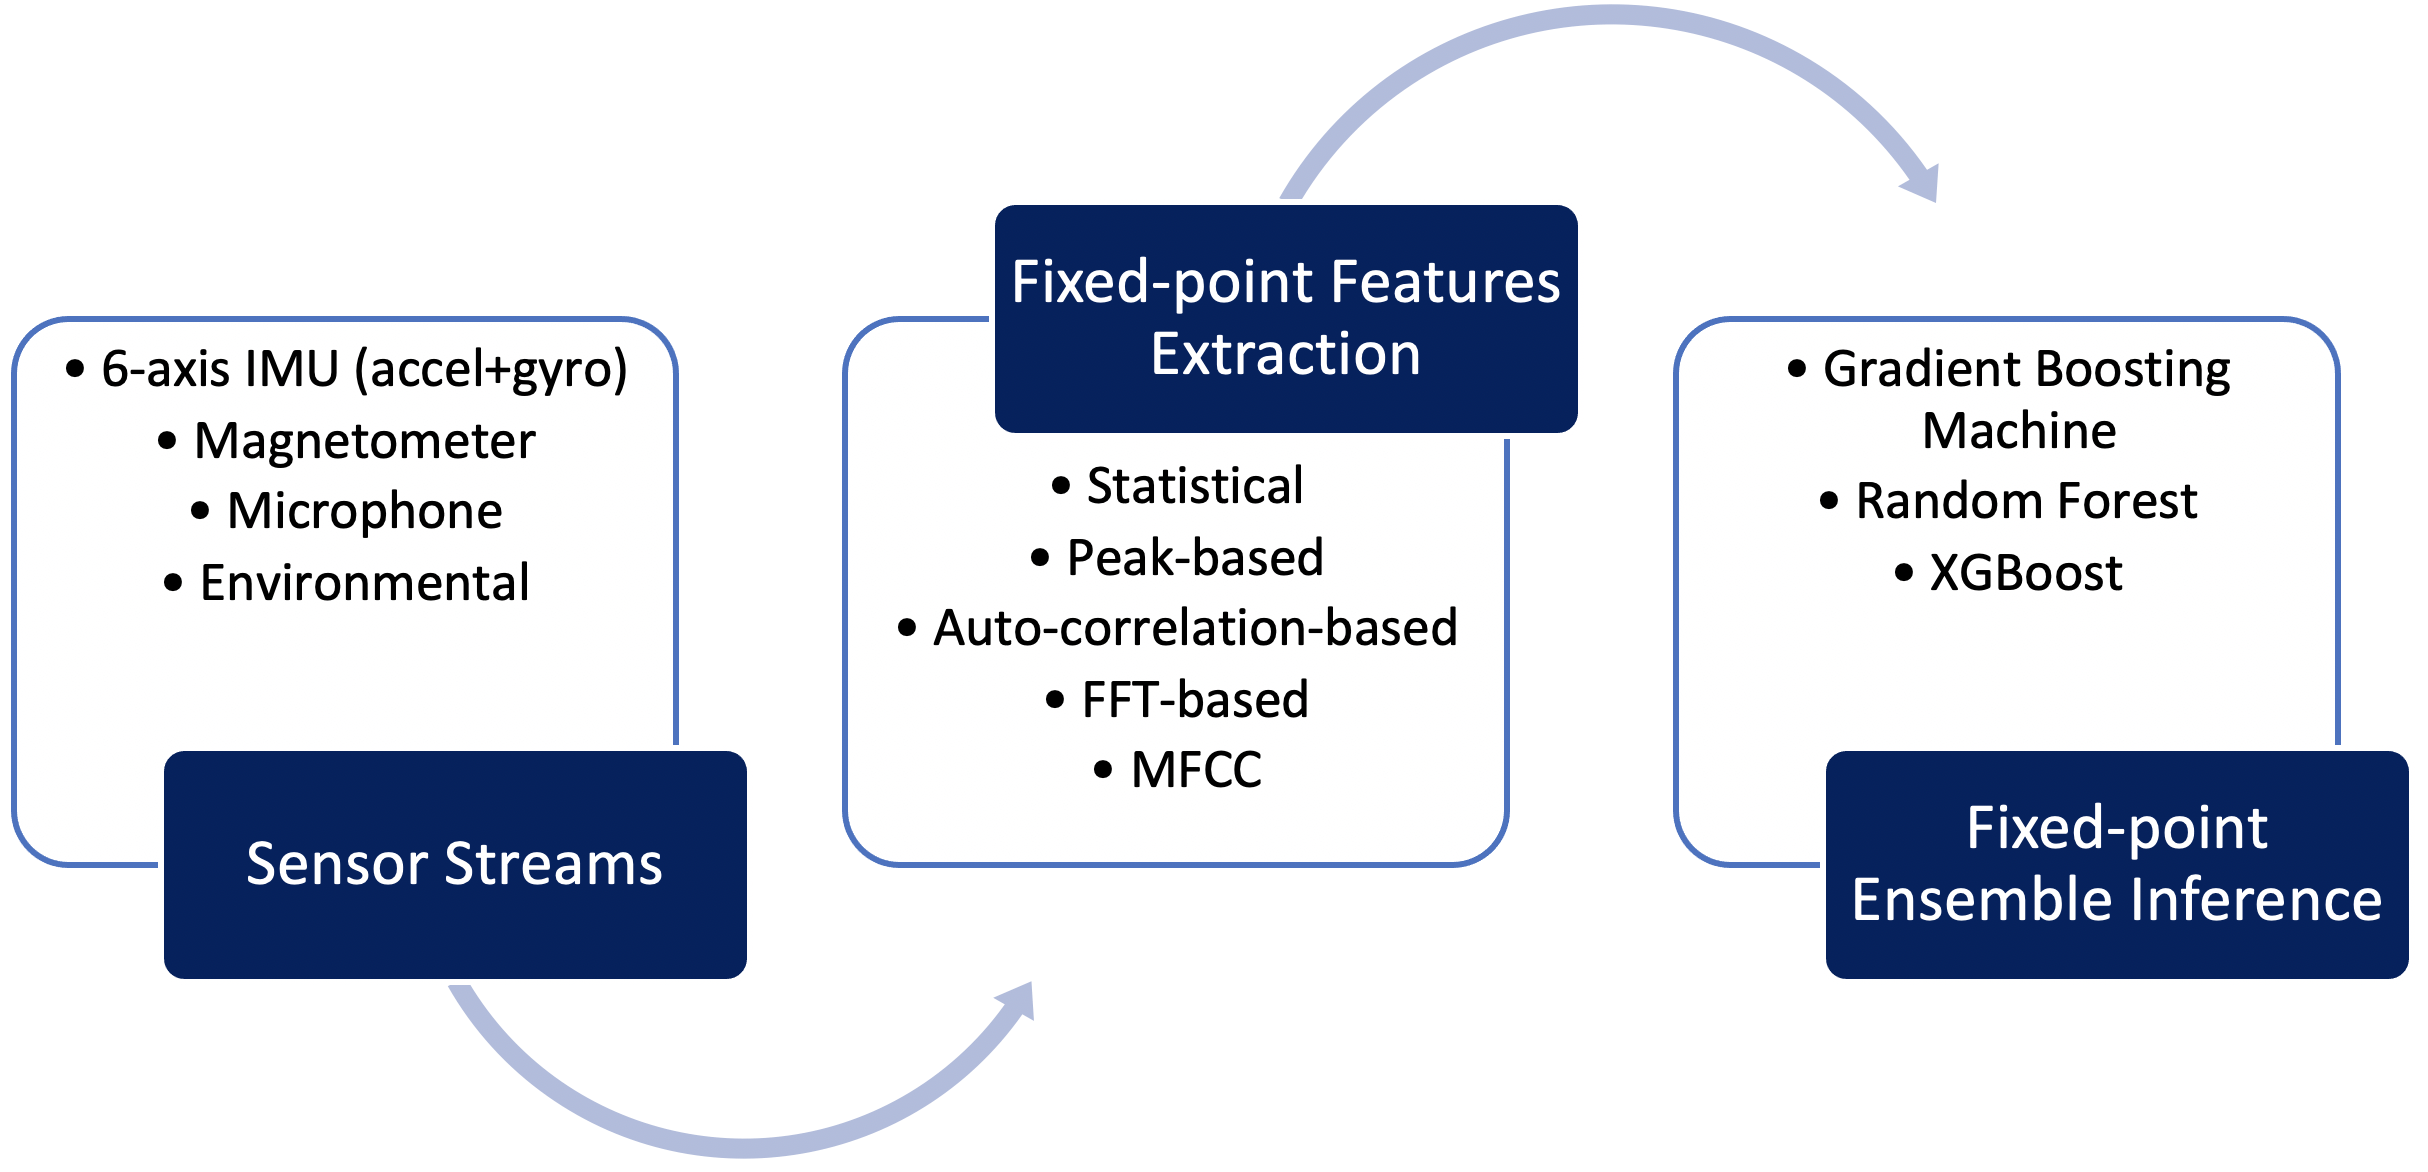
Figure 3 : Pipeline d'inférence Qeexo AutoML M0+ (Source : Qeexo)
La plateforme applique une compression et quantification de modèle brevetées, réduisant l'empreinte mémoire sans sacrifier la précision. La Figure 4 détaille le pipeline d'entraînement pour cibles Cortex-M0+.
cliquer pour image en taille réelle
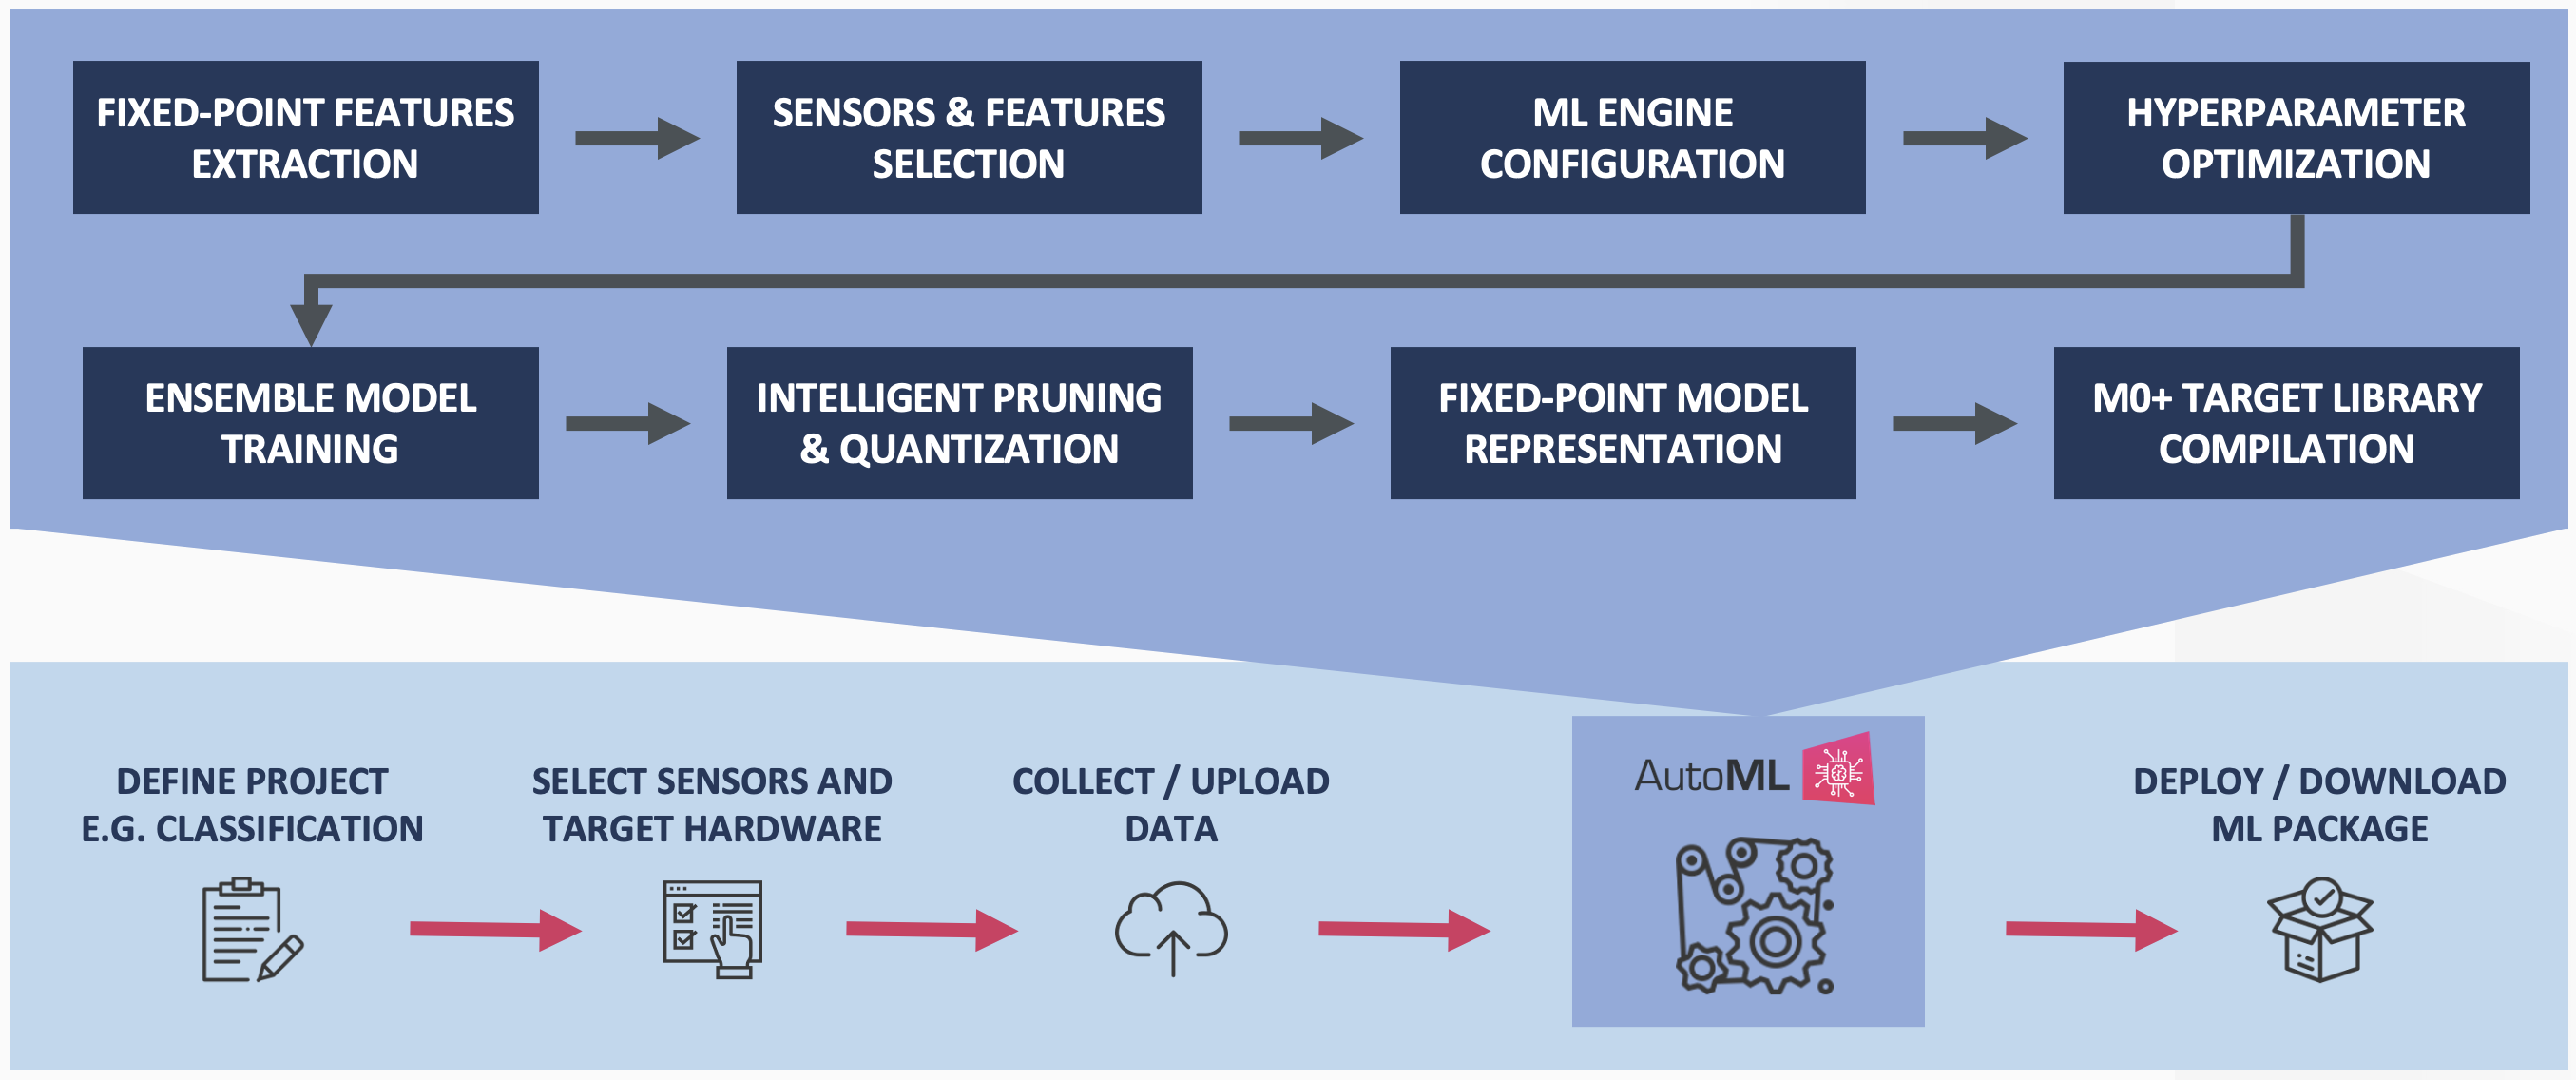
Figure 4 : Pipeline d'entraînement Qeexo AutoML M0+ (Source : Qeexo)
Élagage intelligent
Plutôt que de construire un petit modèle dès le départ, Qeexo AutoML entraîne d'abord un grand ensemble, puis conserve sélectivement les boosters les plus performants. Cette stratégie offre de meilleures performances et une plus grande compression. La Figure 5 montre que le modèle compressé est environ dix fois plus petit que le modèle complet tout en offrant une précision de validation croisée supérieure.
cliquer pour image en taille réelle
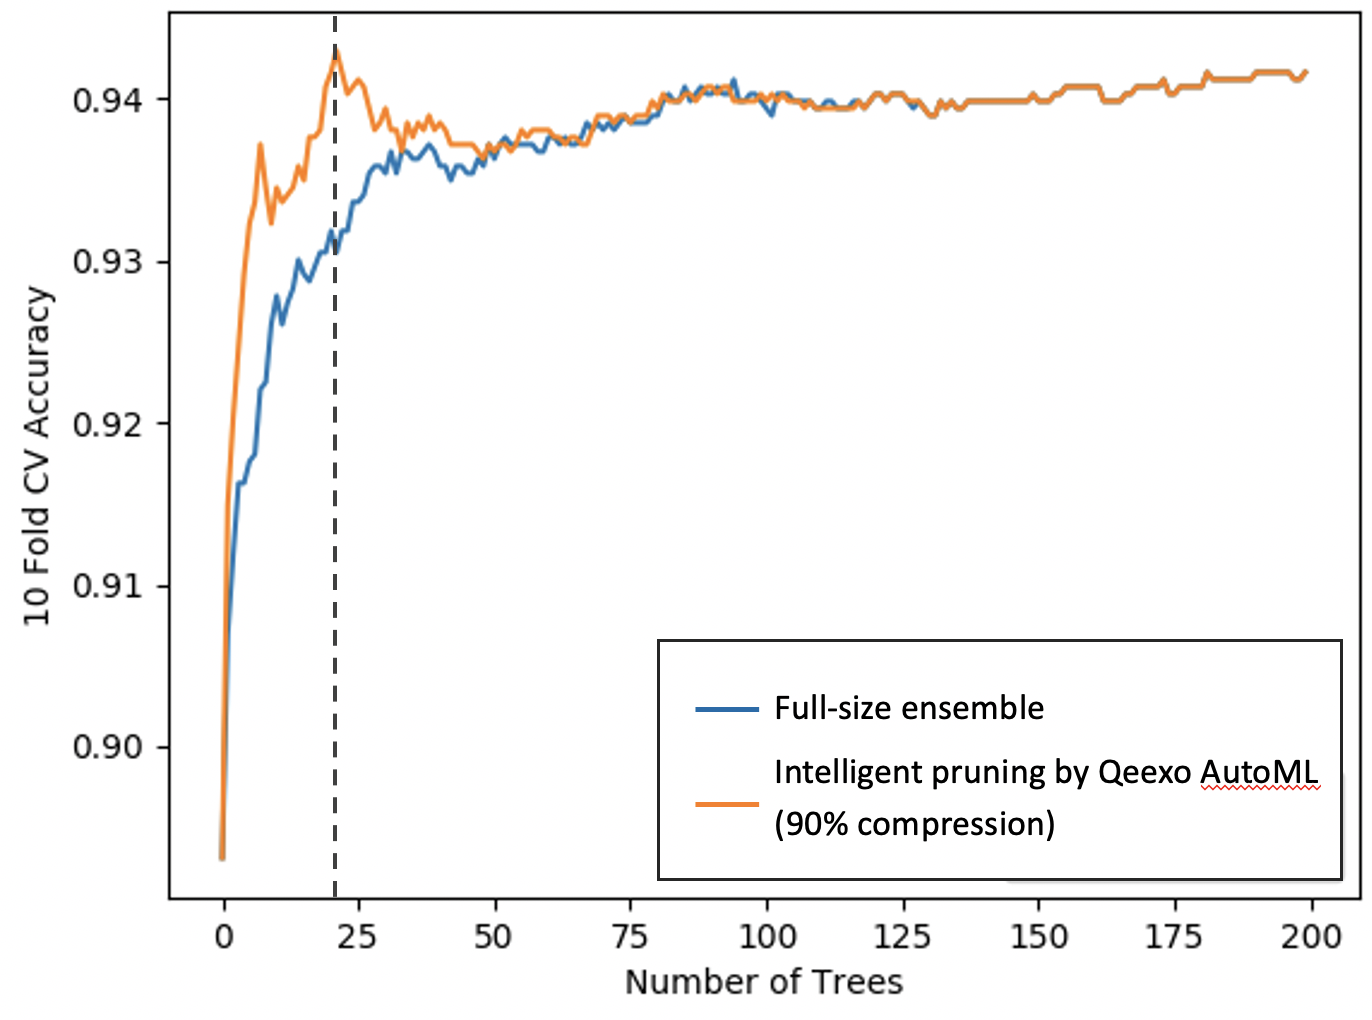
Figure 5 : Élagage intelligent de modèle Qeexo AutoML (Source : Qeexo)
Quantification de modèle d'ensemble
Qeexo AutoML étend la quantification post-entraînement — courante dans les réseaux de neurones — aux algorithmes d'ensemble. Cette approche brevetée réduit encore la taille du modèle et accélère la latence au niveau MCU tout en préservant les performances. Le pipeline M0+ produit des modèles en virgule fixe 32 bits ; une quantification optionnelle 16 bits ou 8 bits divise la taille par deux ou quatre, respectivement, et accélère l'inférence de 2 à 3 fois.
Cas d'usage exemples de tinyML
- Éclairage mural intelligent : En fixant un accéléromètre et gyroscope à un mur, les utilisateurs peuvent apprendre les gestes « frappe » et « essuyage » pour contrôler l'éclairage. Qeexo AutoML construit un modèle de geste temps réel en minutes, permettant une interaction intuitive sans contact.
- Expédition intelligente : Des boîtes dotées d'IA détectent comment les expéditions sont manipulées de l'origine à la destination, assurant le respect des directives de manutention et réduisant les dommages.
- Plans de travail de cuisine intelligents : Les modèles TinyML reconnaissent les appareils et opérations de cuisine, offrant automatisation contextuelle et fonctions de sécurité.
- Détection de pannes machines : Capteurs sur équipements industriels identifient les motifs de panne en temps réel, permettant maintenance proactive et minimisant les arrêts.
- Détection d'anomalies : En modélisant les états de fonctionnement sains, Qeexo AutoML identifie les écarts — critique dans les environnements où les données de panne sont rares mais les données saines abondantes.
- Reconnaissance d'activité wearable : TinyML classe les activités quotidiennes via données capteurs sur l'appareil, fournissant un retour instantané sans dépendance au cloud.
Technologie de l'Internet des objets
- Construire des Applications Hybrides Blockchain-Cloud avec Ethereum & Google Cloud
- Exploiter le Machine Learning pour Optimiser la Gestion de la Supply Chain MRO
- Transceivers bidirectionnels 1G Cisco : booster efficience réseaux fournisseurs services et IoT
- Comment capteurs connectés et processeurs intelligents propulsent l'Industrie 4.0
- Construire un robot avec Raspberry Pi et Python : Guide complet
- Booster la fiabilité et réduire les temps d'arrêt : Le Machine Learning transforme la maintenance
- Exploiter l'IoT pour combler la fracture numérique dans l'éducation
- Les capteurs IoT révolutionnent la surveillance de la pollution atmosphérique et la santé publique
- IoT industriel : Blocs de construction clés pilotant l'Industrie 4.0