



La nouvelle puce IA basse précision d'IBM atteint 25,6 TFLOPS entraînement et 102,4 TOPS inférence
Au ISSCC 2024, IBM Research a dévoilé un prototype 7 nm incarnant des années de travail sur l'entraînement et l'inférence IA basse précision. La puce délivre entraînement 16-bit et 8-bit, ainsi qu'inférence 4-bit et 2-bit — bien en deçà de la norme industrielle d'entraînement 32-bit / inférence 8-bit.
Abaisser la précision numérique réduit besoins calcul et puissance, mais IBM a aussi introduit plusieurs optimisations architecturales qui boostent davantage l'efficacité. Le défi clé est de réduire la précision sans nuire à la précision — problème qu'IBM attaque au niveau algorithmique depuis des années.
Le Centre Matériel IA d'IBM, lancé en 2019, vise à booster la performance calcul IA de 2,5× par an, ciblant une amélioration 1000× en FLOPS/W d'ici 2029. De tels objectifs ambitieux sont poussés par la croissance explosive des modèles IA — surtout systèmes NLP trillion-paramètres — et l'empreinte carbone croissante de leur entraînement.
Sur le prototype, la puce 4 cœurs atteint 25,6 TFLOPS pour entraînement 8-bit, tout en délivrant 102,4 TOPS pour inférence entier 4-bit (mesurés à 1,6 GHz et 0,75 V). Baisser l'horloge à 1 GHz et la tension à 0,55 V améliore l'efficacité énergétique à 3,5 TFLOPS/W (FP8) ou 16,5 TOPS/W (INT4).
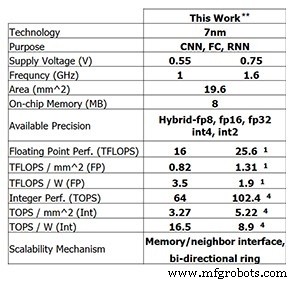
Performance de la puce test IBM Research (Image : IBM Research) **Performance rapportée à 0% sparsité. (1) FP8. (4) INT4.
Entraînement basse précision
Cette performance s'appuie sur années de travail algorithmique sur techniques d'entraînement et inférence basse précision. La puce est la première à supporter le format hybride FP8 d'IBM, introduit à NeurIPS 2019, qui permet l'entraînement 8-bit tout en divisant par deux le calcul de l'entraînement 16-bit sans compromettre les résultats.
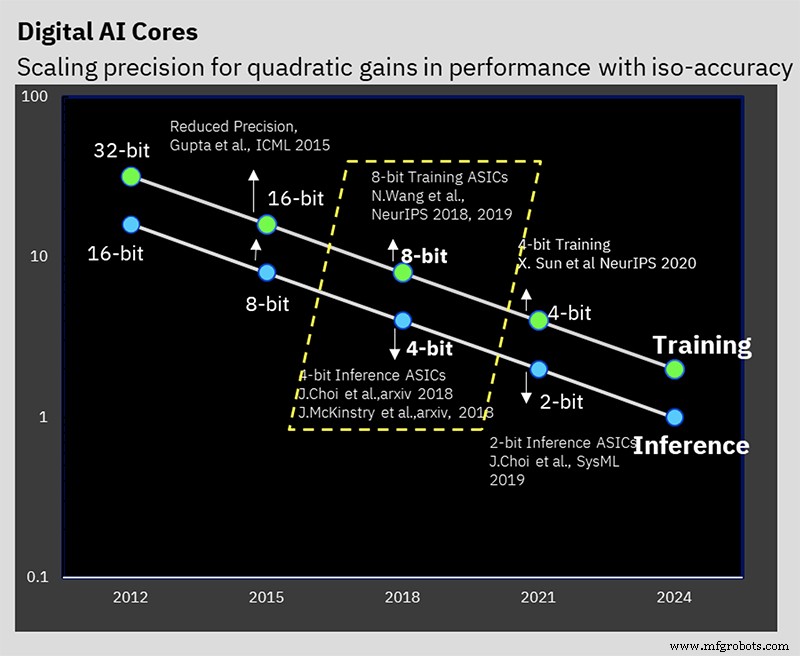
IBM Research travaille sur la résolution du problème de maintien de la précision en réduisant la précision (Image : IBM)
« L'entraînement basse précision est challengeant, mais l'entraînement 8-bit est réalisable avec les bons formats numériques », a dit Kailash Gopalakrishnan, IBM Fellow et senior manager pour architectures accélérateurs et apprentissage machine. « Les bons formats numériques, appliqués aux bons tenseurs, sont critiques. »
Le FP8 hybride combine deux formats : un pour poids et activations dans la passe avant, et un autre pour gradients dans la passe arrière. L'entraînement requiert les deux passes, alors que l'inférence n'utilise que le format avant.
« Nous avons trouvé que les tenseurs avant ont besoin de fidélité plus haute — plus de précision dans la mantisse — tandis que les gradients demandent une plage dynamique plus large avec un exposant plus grand. Ce trade-off a mené au split 1-4-3 (signe-exposant-mantisse) pour l'avant et un exposant 5-bit pour l'arrière, donnant une plage dynamique de 232. Notre matériel supporte maintenant les deux variantes. »
Accumulation hiérarchique
La technique d'« accumulation hiérarchique » d'IBM réduit la précision pendant l'accumulation aux côtés des poids et activations. L'entraînement FP16 traditionnel accumule en arithmétique 32-bit pour préserver la précision, mais le schéma 8-bit accumule en FP16. En groupant les longues accumulations en morceaux plus petits et sommant ceux-ci, la puce minimise les erreurs d'arrondi sans sacrifier les bénéfices de la précision inférieure.
« Additionner des milliers de nombres séquentiellement peut dégrader la précision », a expliqué Gopalakrishnan. « Le fractionnement de l'accumulation garde la somme précise tout en gardant le matériel léger. »
Inférence basse précision
Alors que la plupart des moteurs d'inférence utilisent INT8, IBM a démontré que l'arithmétique entière 4-bit peut égaler la précision state-of-the-art. Après quantification, une étape d'entraînement quantization-aware réduit la perte de précision à moins de 0,5 %, acceptable pour de nombreuses applications.
Anneau sur puce
La puce incorpore un network-on-chip optimisé pour deep learning, permettant aux cœurs de diffuser données efficacement. Cela réduit le trafic mémoire hors puce et les demandes de bande passante.
« Nous avons découplé la fréquence de fonctionnement de l'anneau de celle des cœurs, permettant optimisation indépendante et vitesses de cœurs plus hautes sans la latence des longs fils de l'anneau », a dit Ankur Agrawal, membre du staff recherche en apprentissage machine et architectures accélérateurs.
Gestion de l'énergie
IBM a introduit un schéma de scaling de fréquence qui maintient la puce près de son enveloppe de puissance tout au long de la charge de travail. En réglant tension et fréquence initiales agressivement, la puce maintient haute performance pendant phases calcul-intensives et s'adapte à demande plus basse sans changements de tension coûteux.
« Les charges de travail deep learning ont des pics et creux de puissance distincts », a noté Agrawal. « Notre stratégie garde la consommation de puissance stable, transformant les creux en gains de performance. »
Puce de test
Le design 4 cœurs équilibre complexité connectivité et taille cœur, offrant architecture scalable. IBM prévoit puces 1-2 cœurs pour dispositifs edge et 32-64 cœurs pour déploiements data-center, toutes capables FP16, FP8 hybride, INT4, INT2.
« Différents domaines applicatifs demandent différents trade-offs précision/énergie », a dit Gopalakrishnan. « Notre couteau suisse de formats nous laisse cibler chaque cas d'usage sans compromettre l'efficacité. »
Complétant le hardware, IBM Research a publié la pile compilateur « Deep Tools », atteignant 60-90 % d'utilisation sur la puce.
Selon une interview antérieure, les puces IA basse précision basées sur cette architecture devraient atteindre le marché dans deux ans.
>> Cet article a été publié à l'origine sur notre site partenaire, EE Times.
Contenus connexes :
- Puces IA maintiennent précision avec réduction modèle
- Entraînement modèles IA sur l'edge
- La course est lancée pour l'IA à l'edge
- L'IA edge challenge la technologie mémoire
- Groupe ingénierie vise pousser 1mW IA à l'edge
- Application réseaux neuronaux pour tâches petite échelle
- Recherche IC IA explore architectures alternatives
Pour plus d'Embedded, abonnez-vous à la newsletter hebdomadaire d'Embedded.
Embarqué
- Choix de conception Bluetooth Mesh : Module vs dispositif discret
- Percée MIT : puce ID cryptographique 1,6 mm² combat la contrefaçon par rétrodiffusion térahertz
- Gérer la maintenance malgré les réductions d'effectifs : externalisation stratégique et surveillance continue
- Rockwell Automation s'associe à ATCC pour étendre la formation en automatisation dans le centre du Minnesota
- Des chercheurs dévoilent BrakTooth : 16 failles Bluetooth Classic exposant 1 400+ appareils ESP32
- Comment IBM Watson pilote l'innovation IA à travers les industries
- Boostez votre ROI marketing avec une précision d'agence
- Boostez votre ROI marketing avec une précision niveau agence
- IBM : Améliorer la fiabilité et la sécurité des actifs avec des solutions EAM proactives