



Calcul analogique en mémoire : Inférence IA edge économe en énergie
L'apprentissage automatique et le deep learning sont maintenant tissés dans la technologie quotidienne. Des assistants en langage naturel à la détection d'objets en temps réel, l'IA propulse un nombre croissant de dispositifs grand public et industriels. Pourtant, la plupart de ces applications reposent sur des moteurs d'inférence basés sur le cloud — une architecture qui soulève des préoccupations sur la confidentialité, la consommation d'énergie, la latence et le coût.
Déployer l'IA localement sur l'edge peut éliminer ces problèmes. Le principal obstacle est la consommation d'énergie due à la mémoire des accélérateurs de réseaux de neurones numériques conventionnels. Quand les poids et activations sont récupérés depuis la DRAM ou SRAM, le mouvement de données seul consomme deux à trois ordres de grandeur plus d'énergie que l'arithmétique elle-même. Le calcul analogique en mémoire s'attaque à ce goulot d'étranglement en effectuant les opérations multiply-accumulate (MAC) directement à l'intérieur d'un réseau de mémoire non-volatile.
IA basée sur le cloud : Les points de douleur
Quand un dispositif edge transfère des données brutes vers un serveur distant, plusieurs problèmes surgissent :
- Confidentialité & sécurité — Les informations personnelles ou confidentielles sont transmises et stockées dans des centres de données.
- Consommation d'énergie inutile — Chaque bit envoyé par radio, stocké dans le cloud et re-récupéré brûle de l'énergie.
- Latence pour l'inférence petits lots — Les réponses peuvent prendre plus de 100 ms, ce qui est perceptible pour les utilisateurs.
- Inefficacité de l'économie de données — Les capteurs génèrent des flux massifs ; tout télécharger n'est ni économique ni durable.
Pour surmonter ces défis, un modèle entraîné est d'abord construit sur une plateforme haute performance (cloud, ferme GPU, etc.). Les poids résultants sont ensuite mappés vers un moteur d'inférence léger qui effectue le calcul localement.
La nature lourde en MAC des réseaux de neurones
Même les modèles légers sont dominés par les MAC. Par exemple, MobileNet-v1 avec une entrée 224×224 contient 4,2 millions de paramètres et nécessite 569 millions de MAC par inférence. La multiplication et l'accumulation sont effectuées dans un produit matrice-vecteur dense.
Pourquoi le calcul numérique peine
Dans un accélérateur conventionnel, les poids et activations sont stockés en DRAM/SRAM et doivent être récupérés dans une unité arithmétique et logique (ALU). La Figure 3 illustre le goulot d'étranglement mémoire : l'énergie dépensée pour déplacer les données (50–100 pJ par transfert) éclipse les 250 fJ par opération MAC. Même avec des techniques agressives de réutilisation de données, l'architecture Von Neumann impose une limite dure à l'efficacité énergétique.
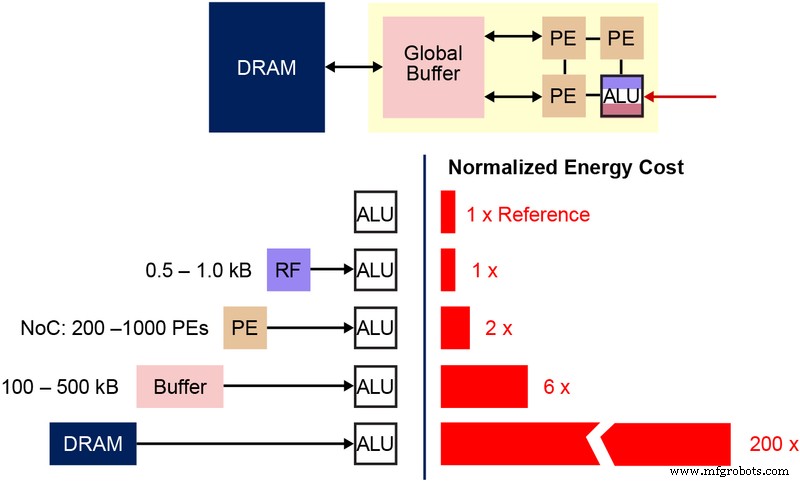 Figure 3 : Goulot d'étranglement mémoire dans le calcul Machine Learning. (Source : Y.-H. Chen, J. Emer, and V. Sze, « Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks, » ISCA, 2016.)
Le calcul analogique en mémoire à la rescousse
En intégrant le calcul dans le réseau de mémoire lui-même, le besoin de déplacer les poids disparaît. Le transfert de données restant est limité au signal d'entrée, qui est typiquement une sortie de capteur. Les cellules Flash opérant dans le régime sous-seuil consomment des courants sous-nanoampères, rendant la puissance active négligeable. En veille, les cellules non-volatiles retiennent les données sans aucune consommation d'énergie.
La plateforme memBrain™ de Silicon Storage Technology (une société Microchip) exemplifie cette approche. Construite sur la technologie de mémoire SuperFlash® (ESF3), chaque bitcell peut être programmée à une tension de seuil précise (Vt), établissant une conductance qui représente un poids. Quand une tension d'entrée est appliquée, le courant traversant la cellule égale le produit de l'entrée et du poids stocké.
Architecture mémoire multi-niveau
La Figure 4 montre la coupe transversale d'une bitcell ESF3. La cellule inclut cinq terminaux — Control Gate (CG), Word Line (WL), Erase Gate (EG), Source Line (SL) et Bitline (BL). L'EG haute tension programme la grille flottante, tandis que le biaisage basse tension sur les autres terminaux lit ou écrit la cellule.
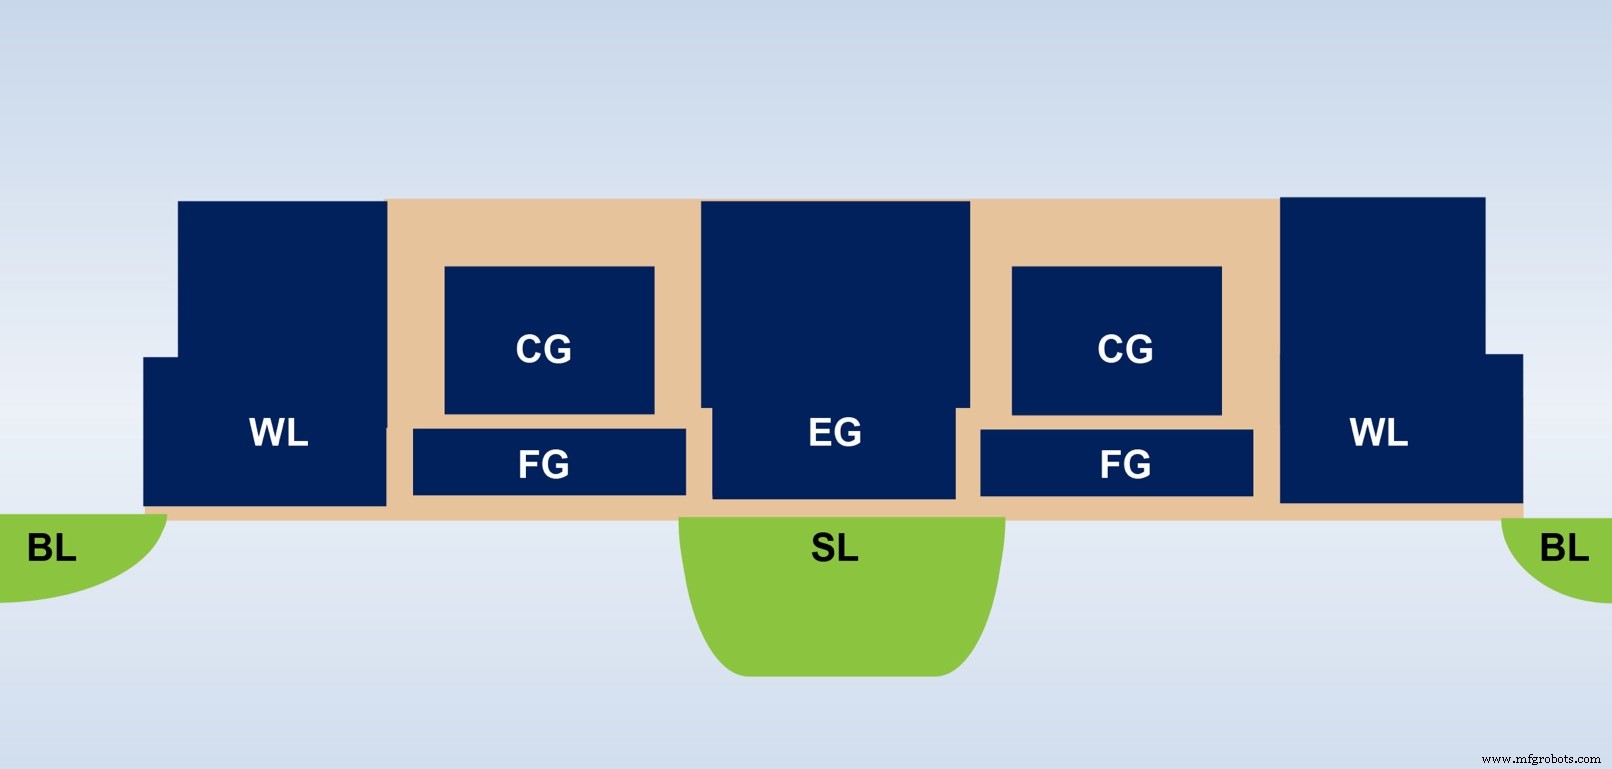 Figure 4 : Cellule SuperFlash ESF3. (Source : Microchip Technology)
La programmation à grain fin ajuste le Vt de la grille flottante pour produire une courbe I-V spécifique. La Figure 5 démontre un exemple 2-bit où quatre niveaux distincts de Vt produisent quatre réponses de courant distinctes quand une tension CG fixe est appliquée.
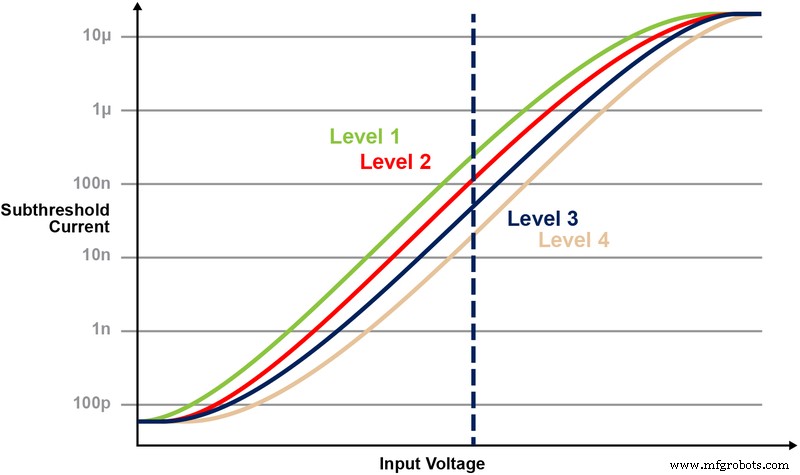 t Levels in ESF3 Cell" /> Figure 5 : Programmation des niveaux Vt dans la cellule ESF3. (Source : Microchip Technology)
MAC dans le réseau de mémoire
La conductance gm de chaque cellule incarne un poids entraîné. Le courant Iout = gm · Vin implémente l'étape de multiplication. En câblant de nombreuses cellules en parallèle, les courants de colonne se somment naturellement, produisant l'opération d'accumulation. La Figure 6 visualise un réseau 2×2 effectuant deux MAC et une accumulation.
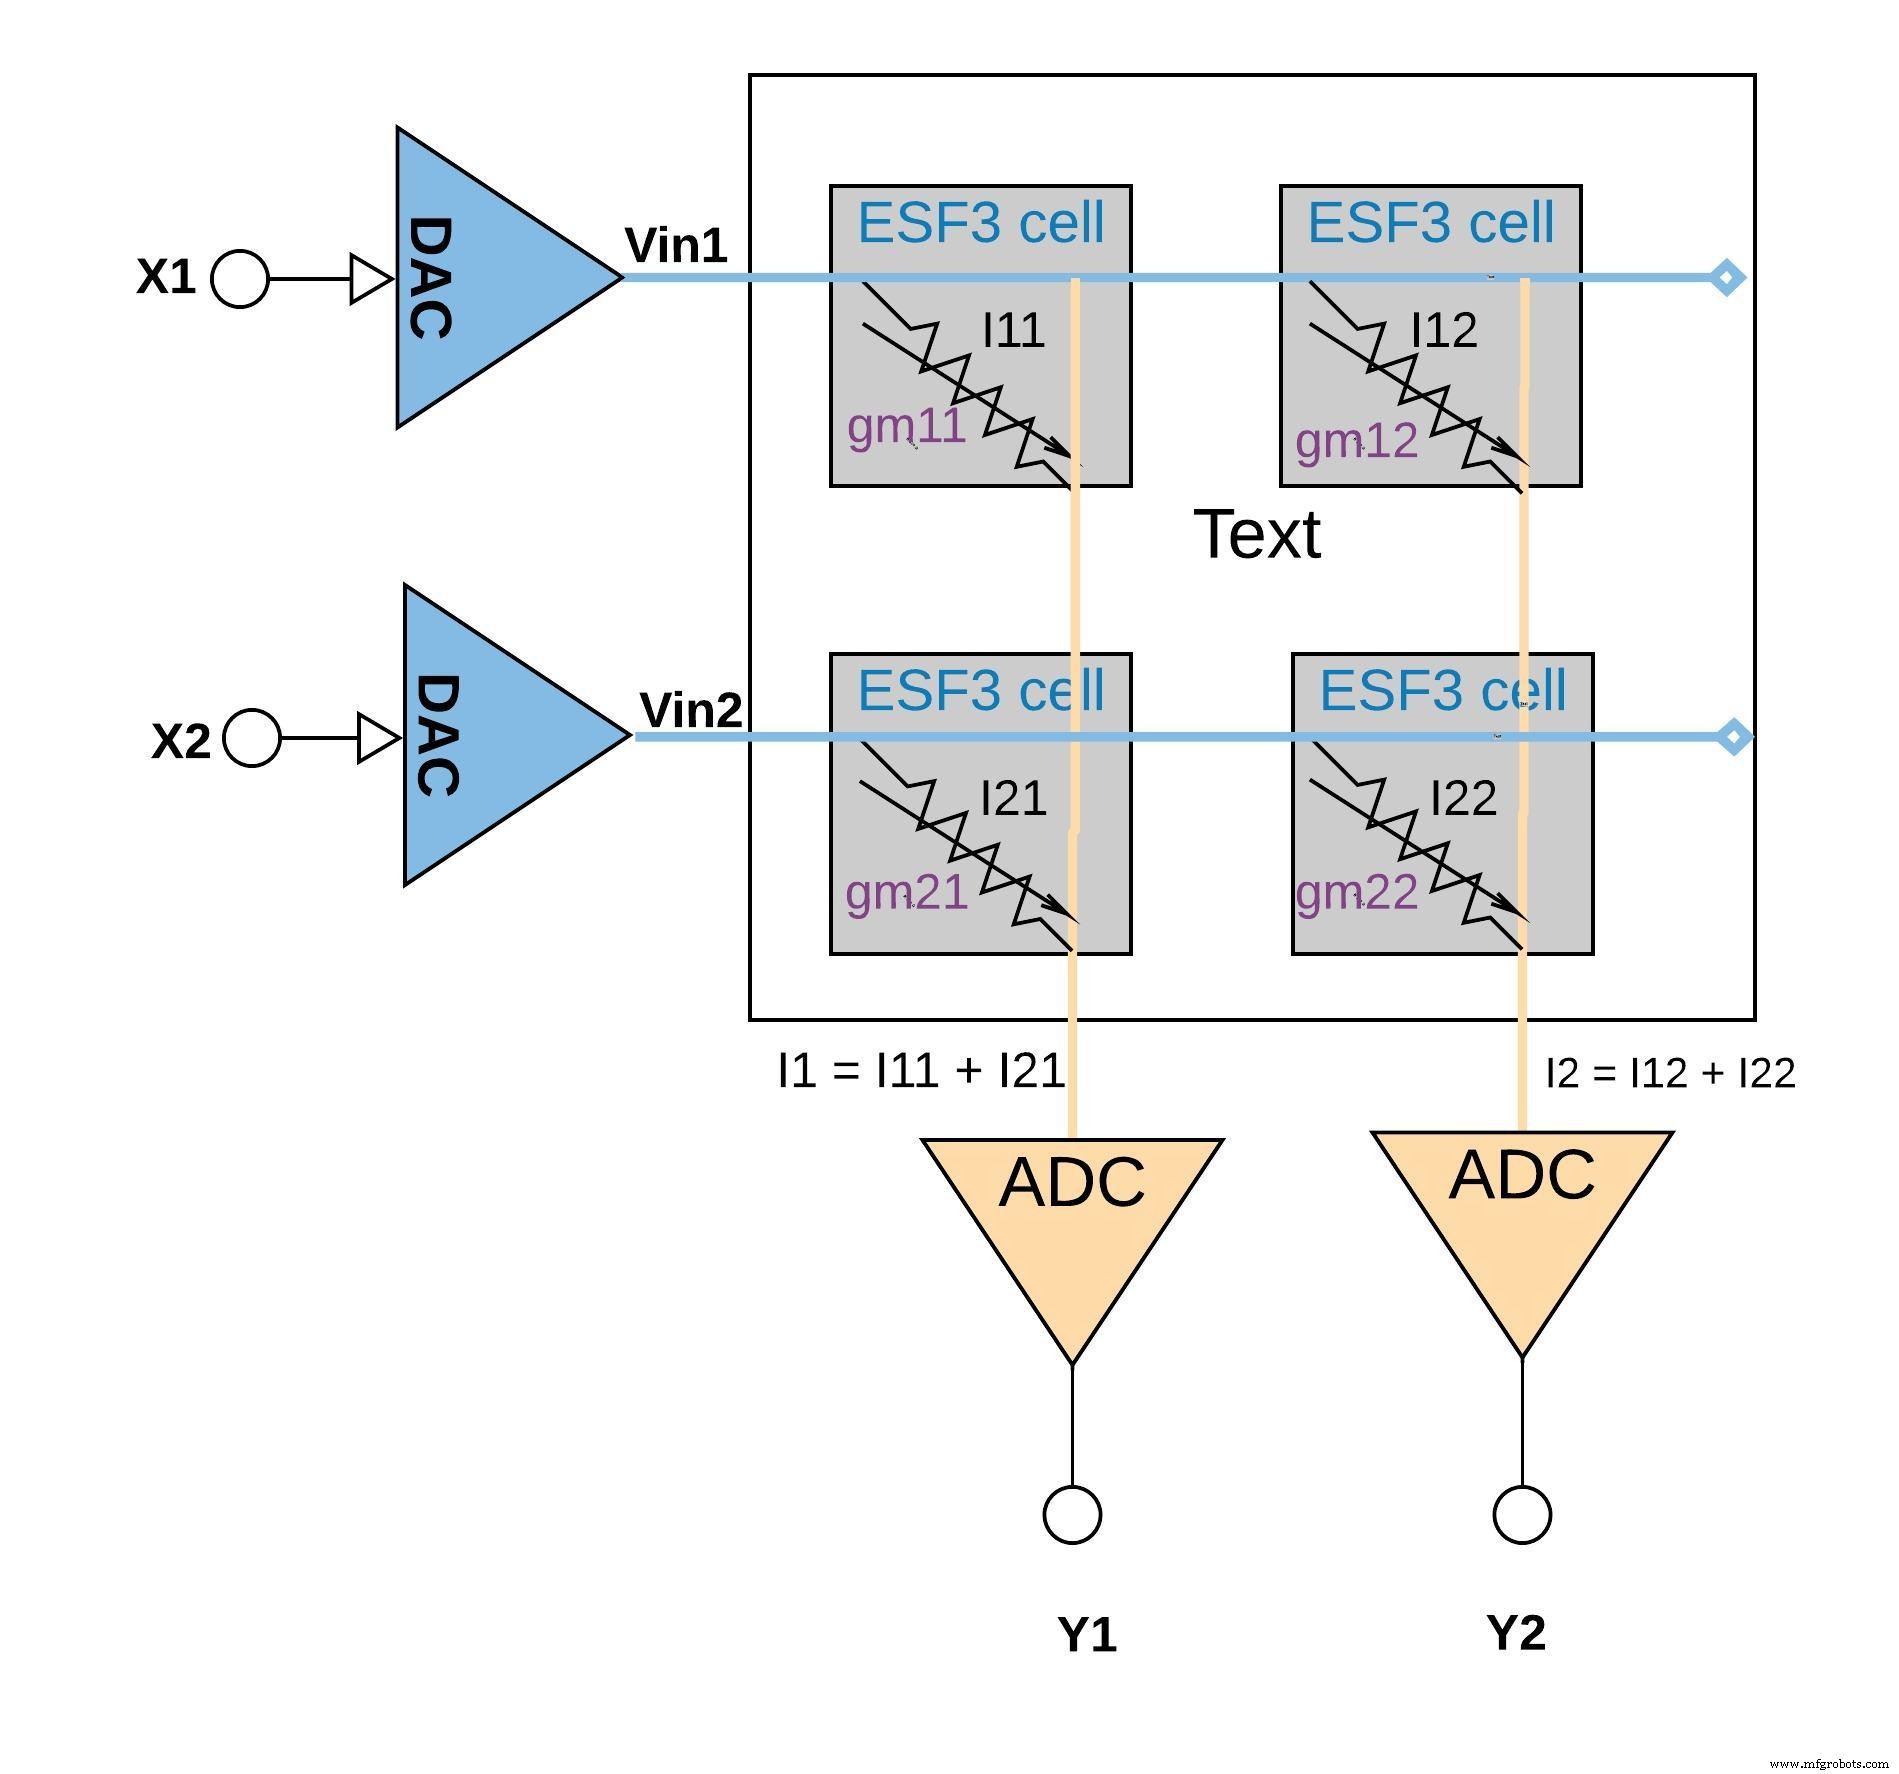 Figure 6 : Opération Multiply-Accumulate avec réseau ESF3 (2×2). (Source : Microchip Technology)
À plus grande échelle, une matrice de poids peut être mappée sur un seul réseau de mémoire. La Figure 7 montre la disposition de la matrice pour une couche fully connected.
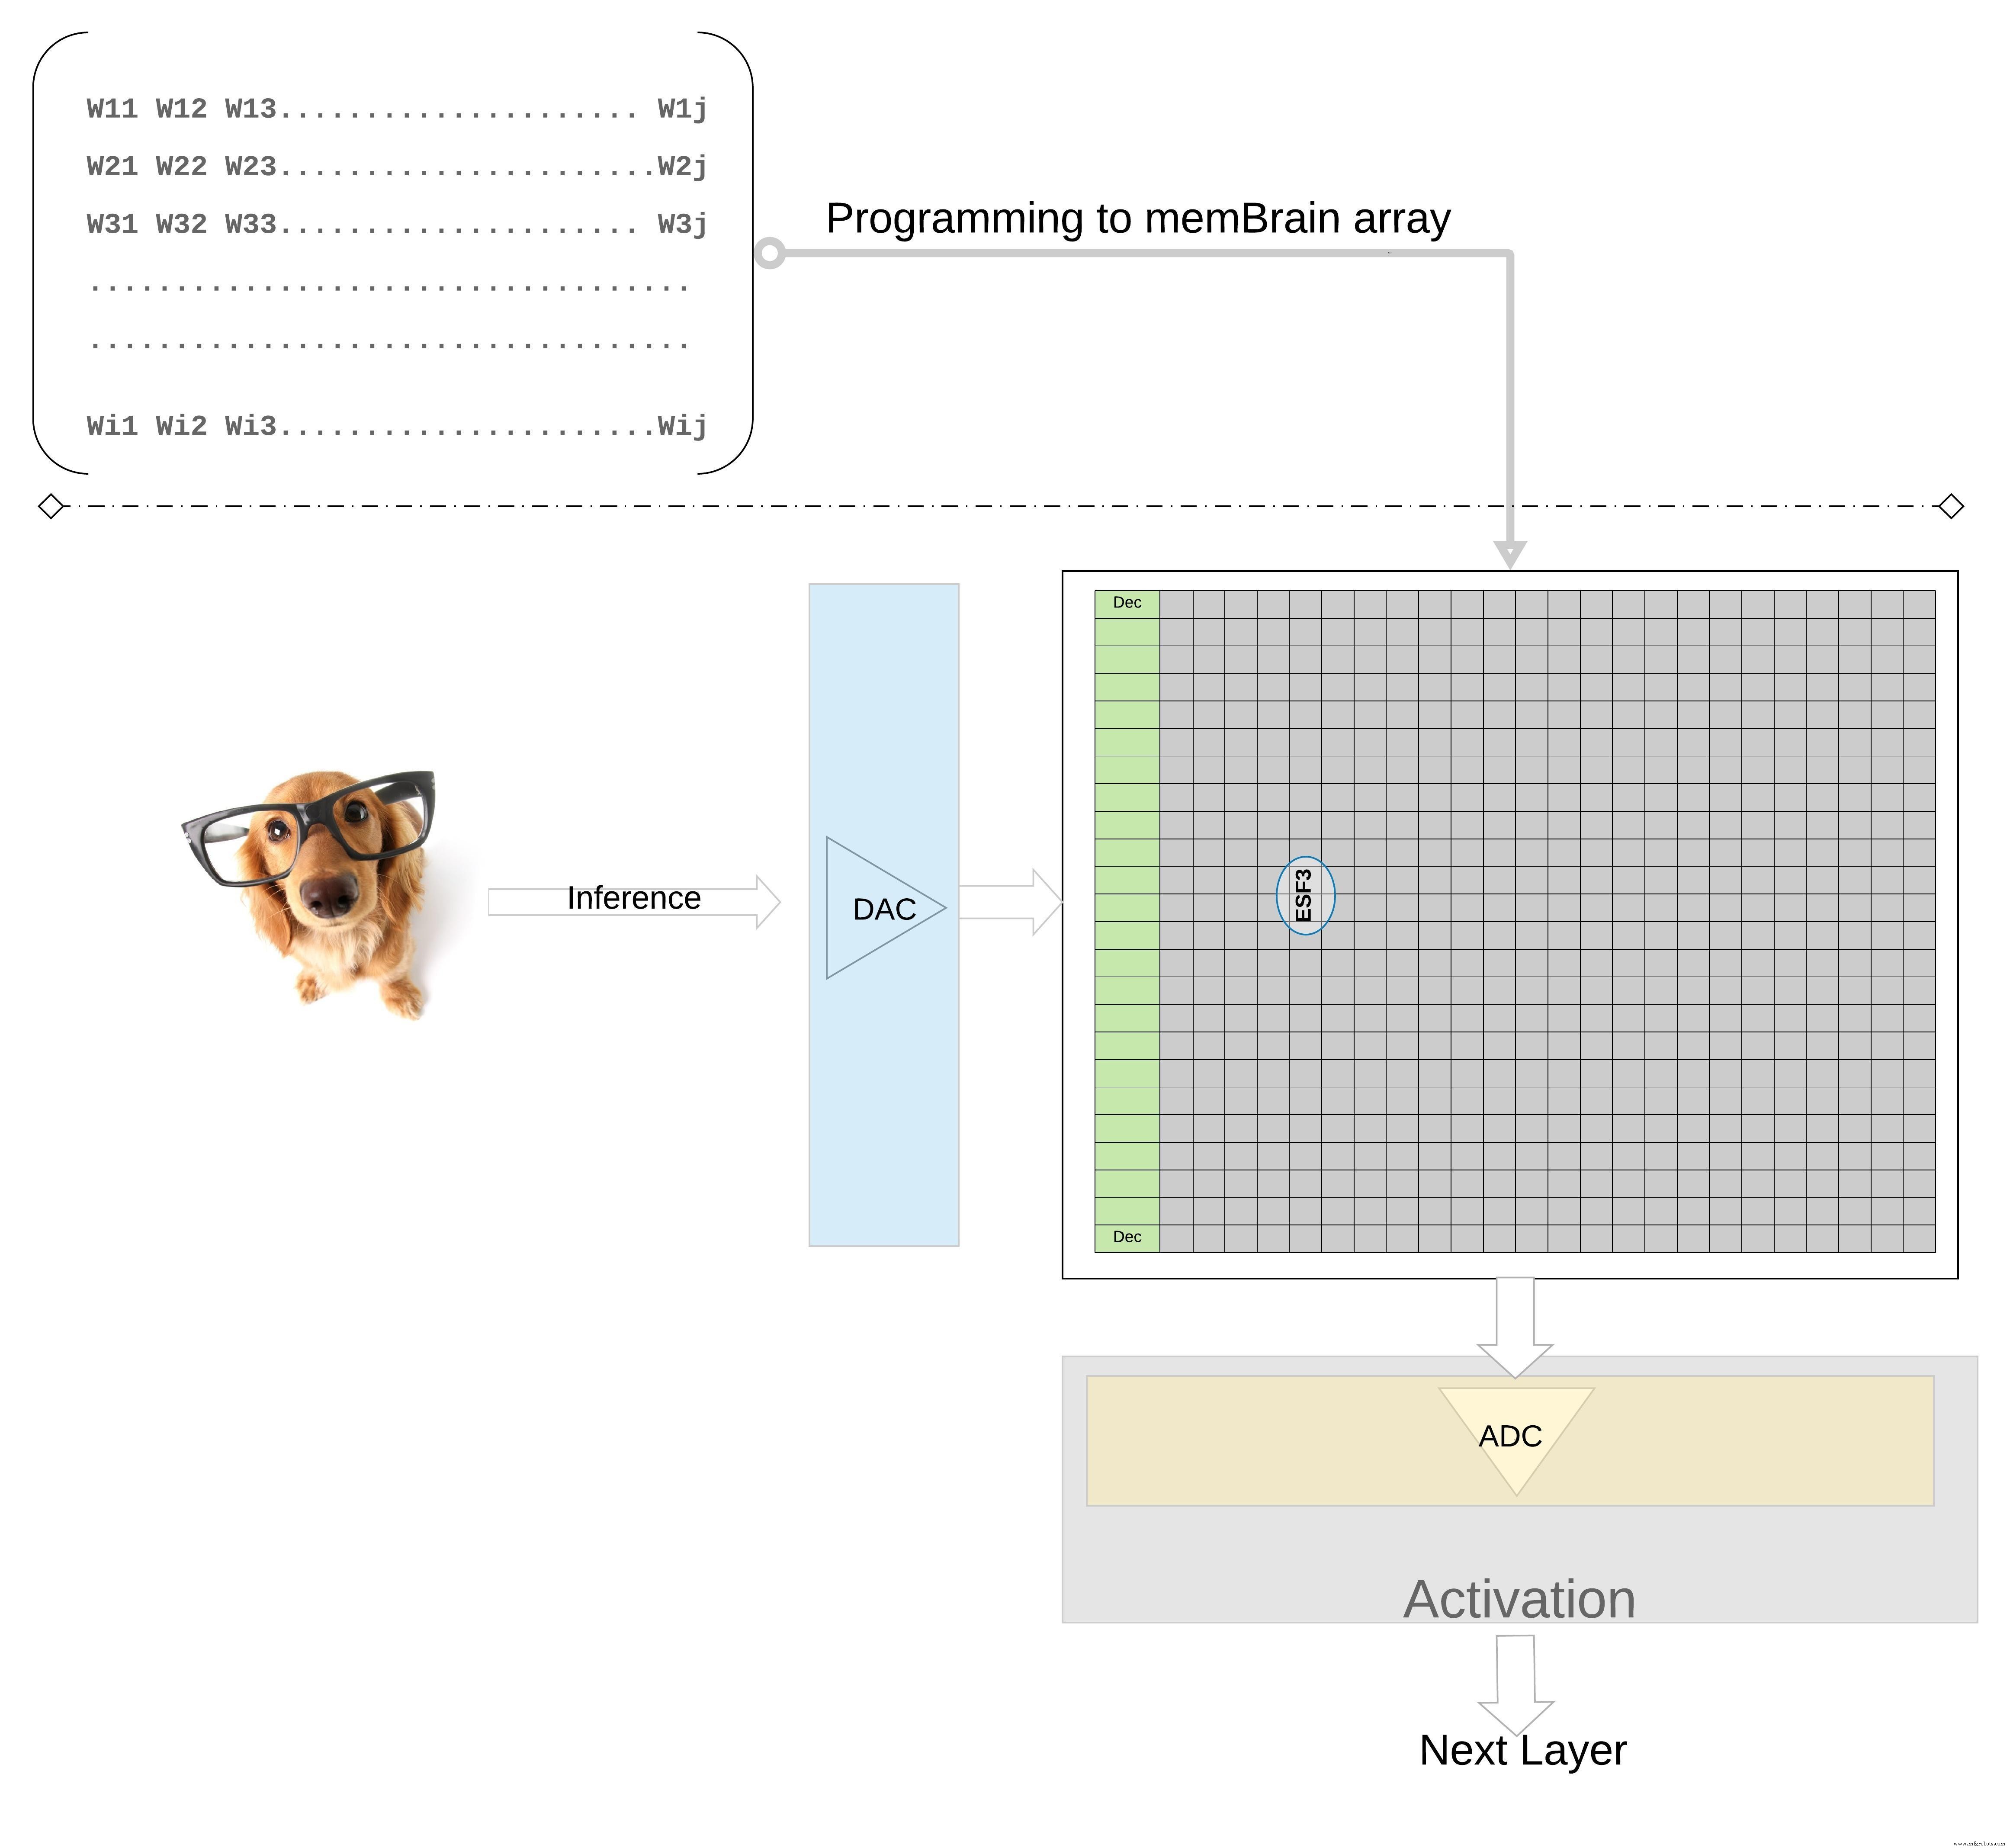 Figure 7 : Réseau de mémoire matrice de poids pour l'inférence. (Source : Microchip Technology)
Le flux d'inférence est direct : les données du capteur sont numérisées, converties en tension analogique par un DAC, injectées dans le réseau, et les courants de colonne résultants sont numérisés par un ADC pour les étapes d'activation et de pooling subséquentes.
Modularité et Évolutivité
Les tuiles memBrain sont conçues pour être empilées. La Figure 8 montre une configuration 3×4 où plusieurs tuiles partagent un interconnect analogique-numérique commun. Les données se déplacent à travers les tuiles via un bus partagé, permettant la construction de réseaux profonds sans un seul die monolithique.
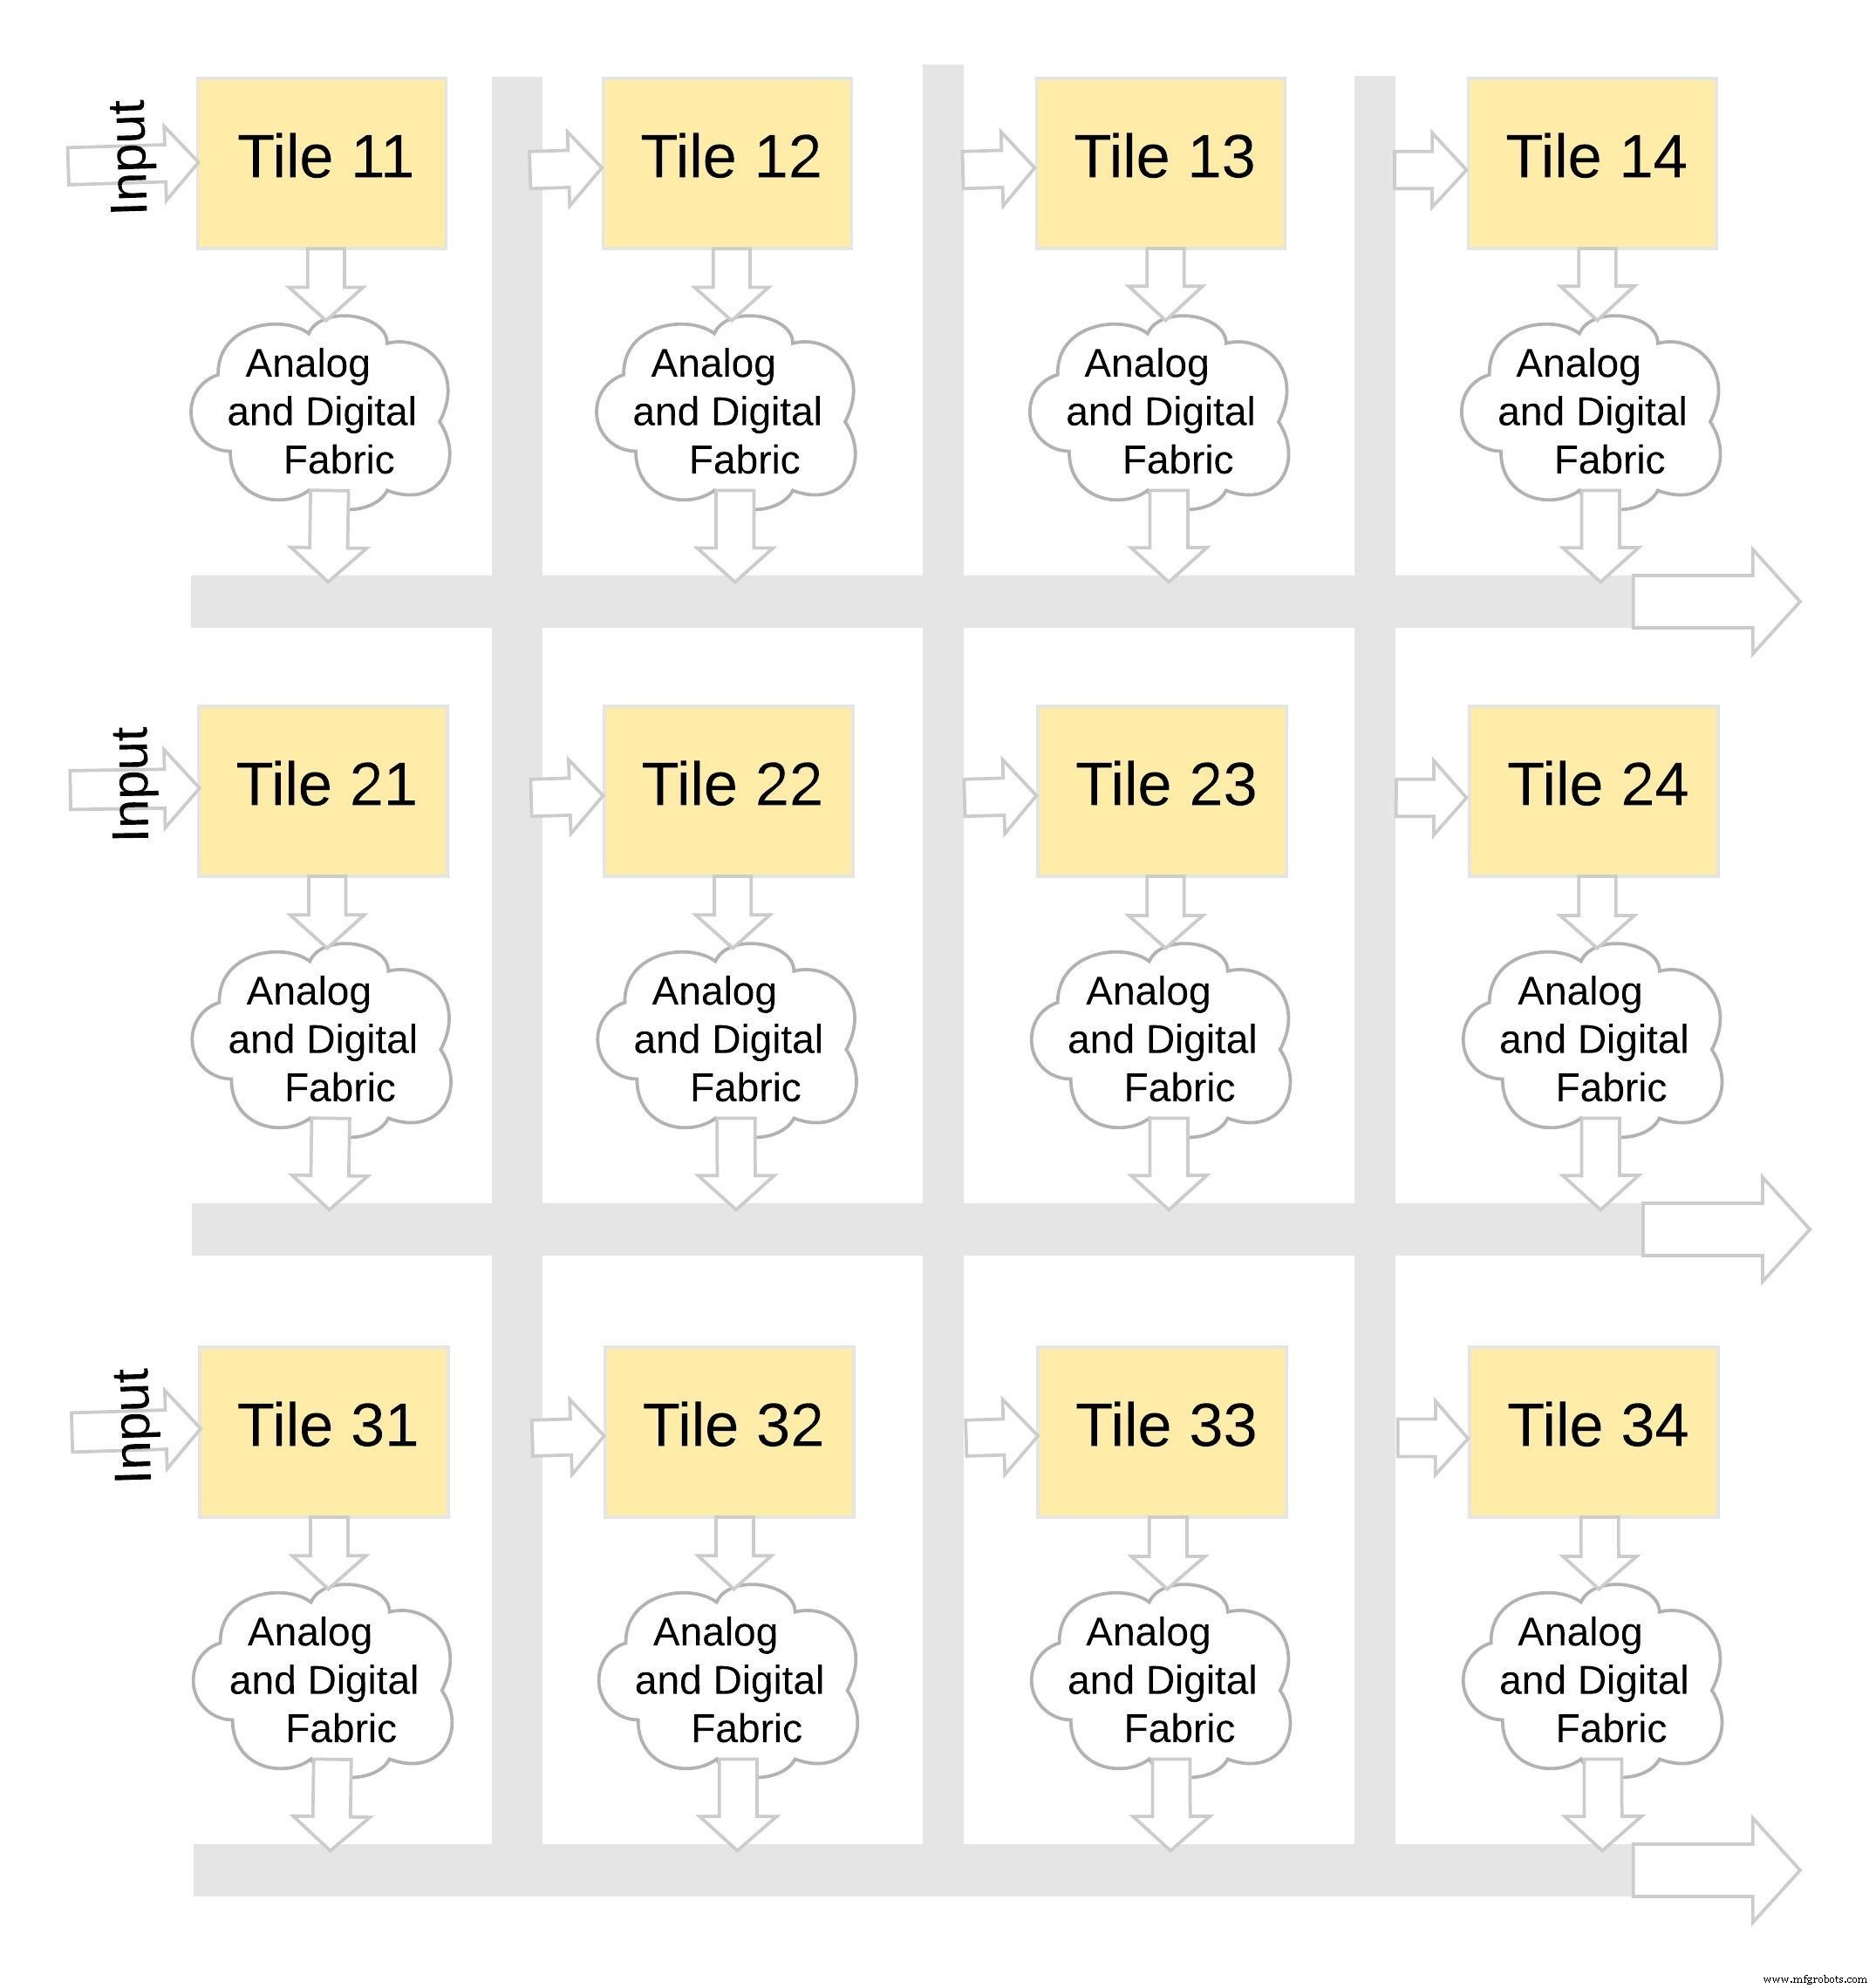 Figure 8 : memBrain™ est Modulaire. (Source : Microchip Technology)
Kit de développement logiciel (SDK)
Le SDK accompagnant est agnostique au framework. Que vous entraîniez dans TensorFlow, PyTorch ou une autre bibliothèque, le SDK gère la quantification du modèle, le mappage et le déploiement vers le matériel memBrain. La Figure 9 décrit le flux de l'entraînement à l'inférence.
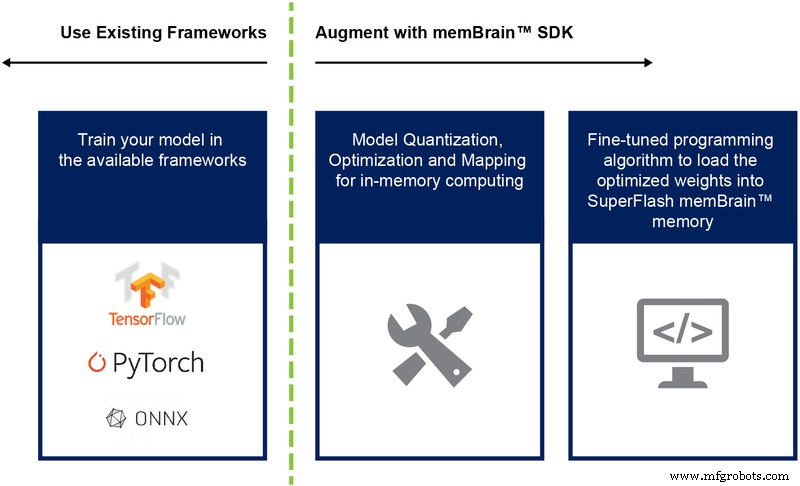 Figure 9 : Flux SDK memBrain™. (Source : Microchip Technology)
Avantages Clés
- Ultra-faible consommation — Le calcul en mémoire élimine le mouvement de données, les cellules flash opèrent en sous-seuil, et aucune puissance en veille n'est nécessaire. L'architecture exploite aussi la parcimonie, car les poids ou entrées nuls laissent les cellules inactives.
- Empreinte compacte — La cellule split-gate 1,5-transistor stocke une valeur 4-bit, alors qu'une SRAM 6-transistors nécessiterait 24 transistors pour les mêmes données. Le résultat est une surface de die dramatiquement plus petite.
- Coût de développement réduit — En tirant parti de processus flash matures et en évitant le besoin de géométries ultra-denses, les coûts de jeu de masques et les délais sont significativement abaissés comparés aux ASICs conçus pour l'IA edge.
L'IA edge promet des applications transformatrices, mais la puissance et le coût restent des facteurs limitants. Le calcul analogique en mémoire, soutenu par la technologie flash multi-niveau éprouvée, offre un chemin pratique et à faible coût pour apporter l'inférence intelligente directement au capteur.
Embarqué
- Comment l'edge computing peut transformer l'IT enterprise : une perspective équilibrée
- Pourquoi le Cloud Computing Renforce les Équipes IT
- Edge Computing démystifié : cas d'usage pratiques dans transport, utilities et manufacturing
- Edge Computing : 5 pièges potentiels — et comment les surmonter
- Exploiter les données IIoT pour propulser la rentabilité dans la fabrication lean
- Edge Computing : le catalyseur qui propulse l'Industrie 4.0
- Comment les coupures de courant menacent vos alimentations et comment les protéger
- 6 raisons convaincantes d'adopter l'informatique de pointe (Edge Computing)
- Edge Computing et 5G : propulser la transformation de l'entreprise