



Construire des systèmes IA robustes : algorithmes à l'épreuve des erreurs pour l'industrie
Les pannes des caméras de vision machine, les capteurs non calibrés, ou les ombres imprévisibles peuvent mener à des erreurs potentiellement coûteuses et dangereuses dans les systèmes IA industriels. Cependant, les chercheurs développent des algorithmes à l'épreuve des erreurs ainsi que des mesures simples qui peuvent être prises pour réduire la probabilité d'erreur.
Applications industrielles pour l'intelligence artificielle
Il existe de nombreuses applications industrielles pour l'IA (intelligence artificielle), telles que les plateformes robotiques, la manutention, l'emballage, la conduite de machines, l'assemblage, l'inspection, et les BAS (systèmes d'automatisation du bâtiment). Des exemples plus spécifiques incluent la technologie drone et d'essaim pour le tri, le déplacement et le transport d'articles ou la détection d'anomalies dans les processus de production.
L'IA est devenue un aspect critique mais souvent oublié de l'automatisation industrielle dépendante de la vision machine, des bras robotiques, de la détection à distance et du contrôle de processus.
Cependant, les outils IA ne sont pas une simple boîte noire dans laquelle les données sont fournies en entrée et transformées en sortie précise. Parfois la sortie est fausse, et c'est une source de préoccupation.
Types d'erreurs dans les applications industrielles
Les ordinateurs font ce qu'on leur dit de faire, donc un humain est à la racine de chaque erreur. Cela peut être une erreur de conception, une erreur d'algorithme, une erreur d'ingénierie, ou de mauvaises données, mais il y aura un humain à la racine.
Cela s'applique également à l'IA, y compris l'IA industrielle. Les erreurs au sein de l'IA industrielle peuvent tomber dans l'une de deux catégories : biais algorithmique et biais de machine.
Le biais algorithmique implique des erreurs qui sont à la fois répétables et systémiques. De telles erreurs peuvent se manifester de plusieurs façons différentes : erreur inhérente dans la logique de l'algorithme, utilisation non anticipée de la sortie de l'algorithme, ou problèmes avec les données fournies au système IA.
Le biais de machine se produit quand un ensemble de données limité est utilisé pour entraîner le système, menant à une sortie erronée.
L'importance de maintenir l'erreur IA sous contrôle
Comme exemple de biais algorithmique, considérez un système de vision machine alimenté par IA utilisé pour des systèmes de contrôle qualité automatisés. Une telle application dépend fortement de mesures précises fournies comme données à l'IA, déterminant si la pièce tombe dans les tolérances. Si des mesures inexactes sont fournies à l'IA, cela résultera en un étiquetage erroné des pièces.
Les algorithmes derrière la vision machine IA peuvent être 100 % corrects, mais de mauvaises données signifient une mauvaise sortie. Des pièces acceptables peuvent être éliminées, tandis que des pièces de mauvaise qualité peuvent être envoyées aux clients. Cela mène à des coûts inutiles et des temps d'arrêt alors que la source du problème est tracée.
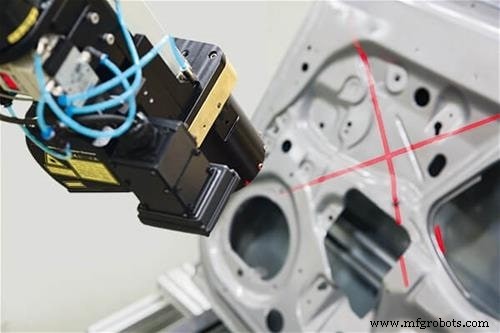
Certains systèmes IA nécessitent un entraînement avant utilisation dans un environnement ou application particulier. Dans de tels cas, les données d'entraînement fournies au système sont extrêmement importantes. Par exemple, si un système reçoit un entraînement limité aux conditions dans une zone éclairée, il y aura des problèmes quand le système doit fonctionner sans lumière.
Épreuvage de l'IA (entraînement de l'IA)
Puisqu'il y a un élément humain derrière l'IA et l'apprentissage automatique, elle ne peut pas être rendue à l'épreuve des erreurs. Il y a cependant des moyens de minimiser l'erreur au sein des systèmes IA. Un exemple inclut CARRL (Certified Adversarial Robustness for Deep Reinforcement Learning), un algorithme d'apprentissage profond développé au MIT dont le but est d'assister les systèmes autonomes en encourageant un niveau de scepticisme sur les données qui prend en compte, comme le bruit dans les données et les efforts adverses pour confondre le système.
Carnegie Mellon a également travaillé sur un algorithme IA pour les modèles d'apprentissage profond. Appelé RATT (Randomly Assign, Train and Track), cette approche utilise des données d'entraînement non étiquetées et bruitées pour établir une borne supérieure pour le risque d'erreur réel. Cette borne supérieure peut ensuite déterminer à quel point un modèle IA s'adapte aux nouvelles données d'entrée. De plus, les chercheurs de Princeton ont examiné des algorithmes qui permettront à un système IA d'apprendre efficacement quand des erreurs sont présentes dans les données d'entraînement.
Il y a aussi des normes en développement qui impacteront les efforts d'épreuvage. Le NIST (National Institute of Standards and Technology) contribue activement aux normes IA qui incluent un focus sur l'évaluation de la fiabilité de la technologie IA. Le NIST a également proposé une approche pour réduire le risque de biais dans les systèmes IA.
L'agence CISA (Cybersecurity and Infrastructure Security Agency) des États-Unis examine déjà des normes pour la vérification des algorithmes IA et la collecte de données, comme révélé lors d'un panel 2020 intitulé « Genius Machines ». Cet effort, avec celui du NIST, met l'accent sur la responsabilité.
Adresser l'erreur dans les systèmes IA
Bien que l'épreuvage des systèmes IA dont vous êtes responsable ne soit pas possible en raison de l'élément humain impliqué, il y a certainement des moyens de minimiser la possibilité d'erreurs.
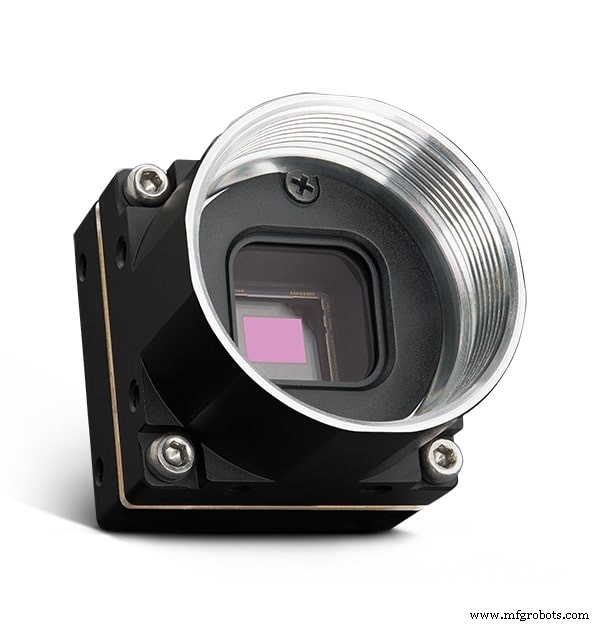
Si vous suspectez que des erreurs proviennent de votre système IA, ne blâmez pas automatiquement l'algorithme ; plutôt, étudiez les erreurs pour chercher un motif. Par exemple, si c'est un robot de prélèvement de bac autonome faisant des erreurs, voyez s'il y a quelque chose en commun que les articles mal triés ont ou s'il y a des changements dans l'environnement du robot (éclairage, ombres, etc.) qui pourraient affecter sa performance. Il pourrait aussi y avoir un problème avec un objectif de caméra sale dans la partie vision machine du système, comme ceux trouvés dans les robots mobiles autonomes.
Une règle dure de programmation est que de mauvaises entrées résulteront toujours en de mauvaises sorties. La première étape pour minimiser l'erreur générée par un système IA industriel est de s'assurer que ses données sont aussi précises que possible, en commençant par les capteurs. Les capteurs qui fournissent des données d'entrée aux systèmes IA devraient être calibrés régulièrement.
Les outils au sein du système IA qui permettent aux utilisateurs de définir des plages acceptables pour les données devraient être implémentés après une considération minutieuse d'une plage acceptable : trop stricte, et l'IA ne fournira pas beaucoup de valeur ; trop large, et elle génère beaucoup trop d'erreurs. Et rappelez-vous, ces valeurs peuvent être ajustées.
Aussi, comme alludé précédemment, gardez les caméras propres. Bien que les systèmes de vision machine soient conçus pour être robustes dans diverses conditions environnementales, cela ne signifie pas qu'ils performeront encore bien quand la vision est compromise par un objectif sale. Il en va de même pour d'autres capteurs industriels dont la précision peut être compromise par une accumulation de tartre, l'exposition à des environnements corrosifs, des problèmes mécaniques ou le vieillissement.
L'IA est largement utilisée dans le secteur industriel pour tout, des contrôles de processus aux inspections de qualité. Et à cause du facteur humain impliqué, ces systèmes IA sont également sujets à l'erreur. Les algorithmes à l'épreuve des erreurs sont en développement, mais ces méthodes ne sont pas encore pleinement mûres, ni largement testées sur des applications industrielles. Et tandis que des organisations comme NIST et CISA travaillent vers des normes d'épreuvage, elles sont encore en développement. Cependant, certaines mesures simples peuvent réduire la probabilité d'erreur dans vos systèmes IA.
Robot industriel
- Comprendre les types de données C++ : Fondamentaux, modificateurs et bonnes pratiques
- Types de données en C expliqués : int, float, char et plus — Guide complet
- Maîtriser les types de données Python : Guide pratique
- Maîtriser l'encapsulation Java : guide pratique pour le masquage de données
- Maîtriser les algorithmes de collection Java : Tri, mélange et plus
- Maîtriser le transtypage Java : De l'élargissement au rétrécissement et au-delà
- Comprendre les types de données en C : Guide complet
- Les unions en C : Gestion mémoire efficace pour types multiples
- Types de données MATLAB : Guide complet