



Optimiser la taille de la couche cachée pour améliorer la précision du réseau de neurones
Dans cet article, nous réaliserons des expériences de classification et analyserons comment la dimensionalité de la couche cachée impacte la performance d'un réseau de neurones.
Apprenez comment ajuster la couche cachée dans un Perceptron peut améliorer la précision, réduire le temps d'entraînement et maintenir une latence acceptable — le tout démontré avec une implémentation Python et de vrais jeux de données.
Avant de plonger, révisez les articles précédents de notre série réseaux de neurones pour construire une base solide :
- Comment effectuer une classification avec un réseau de neurones : qu'est-ce que le perceptron ?
- Comment utiliser un exemple simple de réseau de neurones perceptron pour classifier des données
- Comment entraîner un perceptron de base
- Comprendre l'entraînement simple de réseau de neurones
- Introduction à la théorie de l'entraînement pour réseaux de neurones
- Comprendre le taux d'apprentissage dans les réseaux de neurones
- Apprentissage automatique avancé avec le perceptron multicouche
- La fonction d'activation sigmoïde : activation dans les réseaux de neurones perceptron multicouches
- Comment entraîner un perceptron multicouche
- Comprendre les formules d'entraînement et la rétropropagation pour perceptrons multicouches
- Architecture de réseau de neurones pour une implémentation Python
- Comment créer un perceptron multicouche en Python
- Traitement du signal avec réseaux de neurones : validation dans la conception de réseaux de neurones
- Jeux de données d'entraînement pour réseaux de neurones : comment entraîner et valider un réseau de neurones Python
- Combien de couches cachées et nœuds cachés un réseau de neurones a-t-il besoin ?
- Comment augmenter la précision d'un réseau de neurones à couche cachée
Le nombre de nœuds dans une couche cachée influence directement la précision de classification et la vitesse d'entraînement. Nos expériences fourniront une intuition basée sur les données pour sélectionner une taille de couche cachée qui équilibre vitesse, latence et précision.
Benchmark en Python
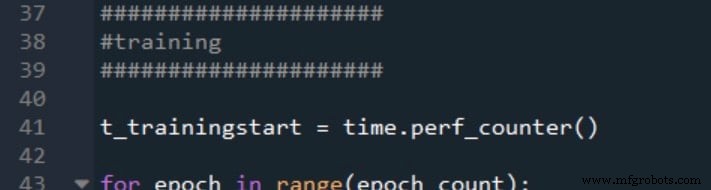
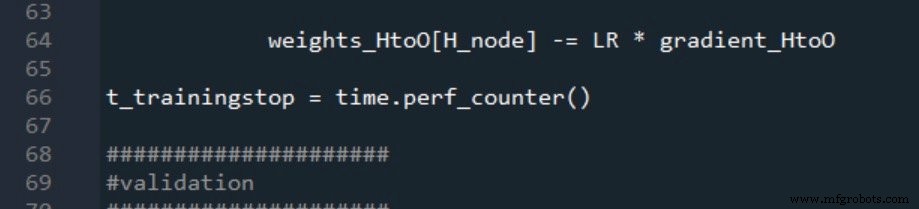
Nous augmenterons le code Python existant de la Partie 12 pour enregistrer les durées d'entraînement et de validation en utilisant time.perf_counter(). Voici l'instrumentation de timing :
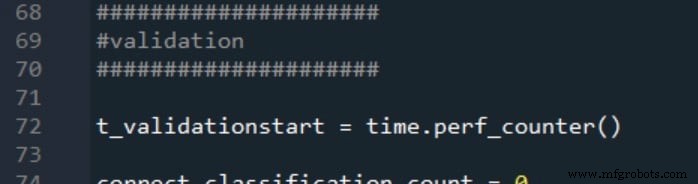
Le timing de validation suit le même pattern :
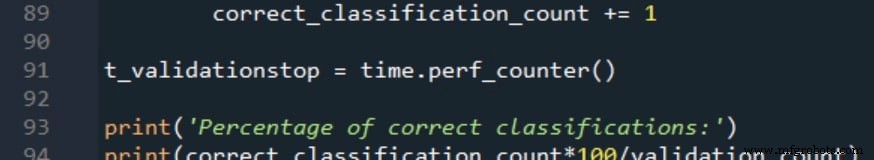
Les résultats sont rapportés comme :
Données d'entraînement et procédure de mesure
Nous testons une tâche de classification binaire utilisant quatre entrées numériques allant de –20 à +20. L'architecture du réseau est 4 nœuds d'entrée, une seule couche cachée, et un nœud de sortie. Les valeurs d'entrée sont générées avec la formule Excel montrée ci-dessous :
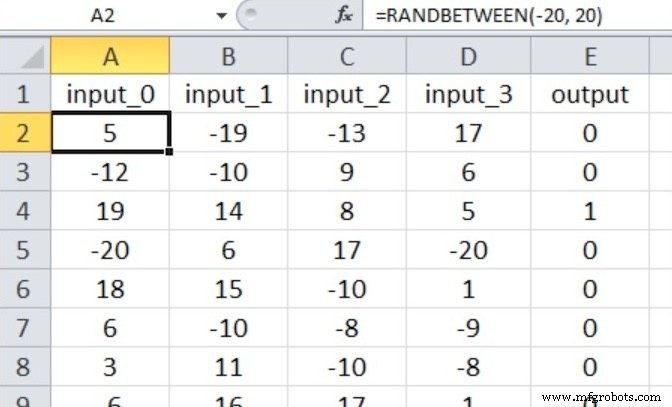
Tailles des jeux de données : 40 000 échantillons d'entraînement et 5 000 échantillons de validation. Nous utilisons un taux d'apprentissage de 0,1 et effectuons une époque complète par exécution. Chaque dimension de couche cachée est testée cinq fois ; la précision et les temps rapportés sont des moyennes arithmétiques.
Expérience 1 : Problème de faible complexité
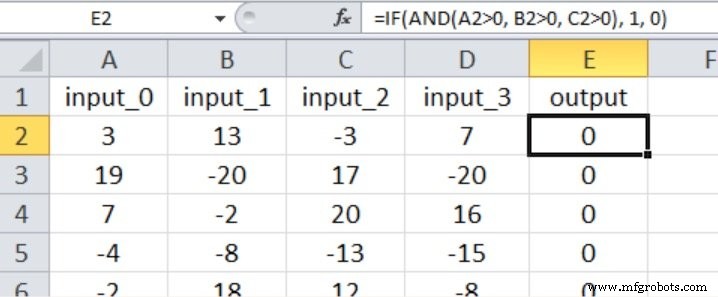
La cible est vraie seulement quand les trois premières entrées dépassent zéro ; la quatrième entrée est irrelevante :
Suivant la directive des deux tiers de la taille d'entrée, nous commençons avec H_dim = 2. Les résultats sont résumés ci-dessous :
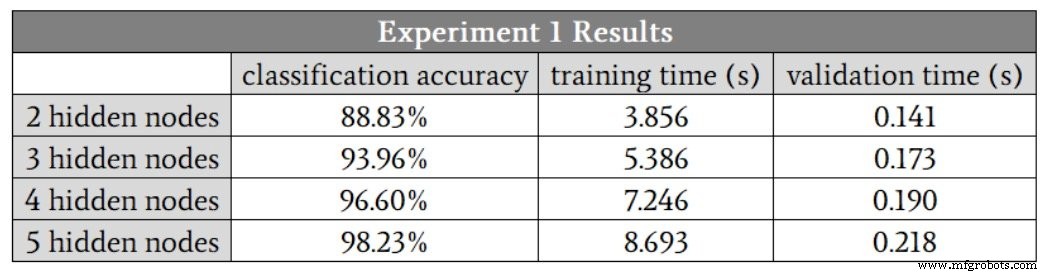
La précision s'améliore jusqu'à cinq nœuds cachés, mais le gain marginal de quatre à cinq nœuds est modeste car une exécution avec quatre nœuds était une valeur aberrante (88,6 %). En retirant cette aberration, quatre nœuds surpassent légèrement cinq. Le temps d'entraînement augmente 1,9× de deux à quatre nœuds, tandis que le temps de validation n'augmente que 1,3×, soulignant que l'entraînement est la phase la plus intensive en calcul.
Expérience 2 : Problème de complexité modérée
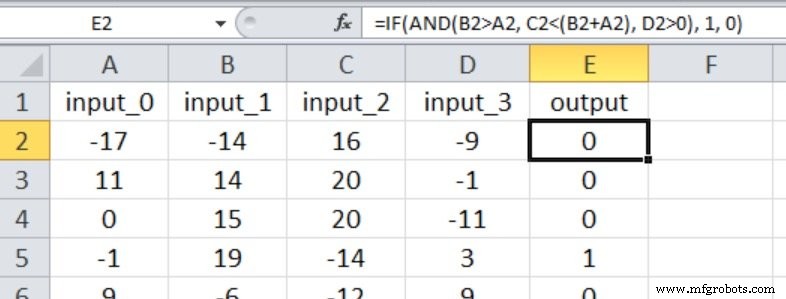
Les quatre entrées influencent la sortie, avec des comparaisons plus nuancées :
En commençant avec trois nœuds cachés, les résultats sont :
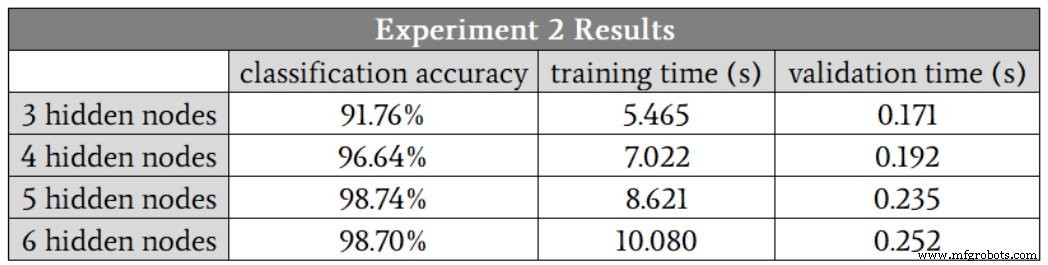
Ici, cinq nœuds cachés semblent optimaux, équilibrant précision et vitesse. Contrairement à l'Expérience 1, les exécutions avec cinq et six nœuds ne montrent pas de valeurs aberrantes de faible précision, suggérant que des couches cachées plus grandes confèrent une robustesse contre la variance d'entraînement.
Expérience 3 : Problème de haute complexité
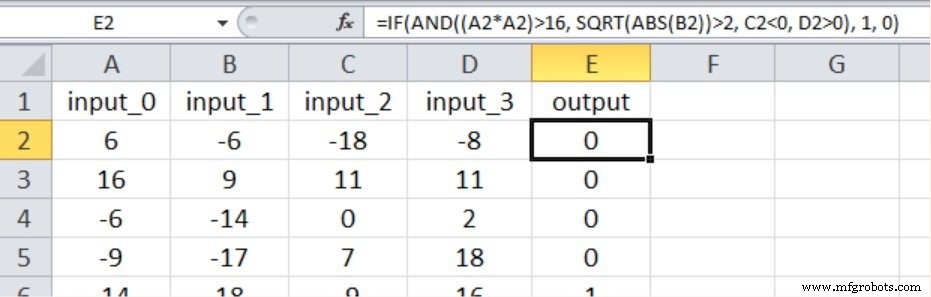
Ce scénario introduit de la non-linéarité : une entrée est élevée au carré, une autre est racine carrée :
Les résultats sont les suivants :
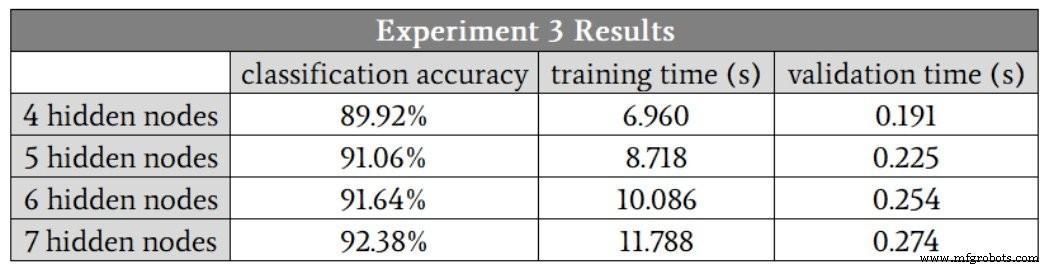
La précision chute comparée aux tâches de complexité inférieure, même avec sept nœuds cachés. Des améliorations comme l'ajout d'un terme de biais ou le recuit du taux d'apprentissage pourraient améliorer la performance, mais tant que de tels changements ne sont pas validés, une couche cachée à sept nœuds est recommandée.
Conclusion
Ces expériences illustrent un compromis clair : augmenter la dimensionalité de la couche cachée booste généralement la précision et la stabilité mais au coût de temps d'entraînement plus longs. Utilisez les insights basés sur les données ici pour informer vos choix de conception lors de la construction de classifieurs basés sur Perceptron.
Robot industriel
- Choisir le bon nombre de couches cachées et de nœuds dans un réseau de neurones
- Entraîner des réseaux de neurones avec Excel : construction et validation d'un perceptron multicouche Python
- Construction d'un perceptron multicouche en Python : guide pratique
- Conception d'un perceptron flexible en Python : architecture, biais et activation
- Comment les réseaux connectés révolutionnent l'agriculture moderne
- Sécuriser l'IoT du matériel à l'application : un blueprint couche par couche
- Thomas WebTrax vs Google Analytics & Réseau Thomas : quel outil pilote vos leads industriels ?
- Comment les capteurs réseau 0G protègent les chaînes du froid vaccinales
- Choisir le Système de Découpe Laser Idéal : Productivité et Précision Optimisées