



Réseau de prédiction par apprentissage profond pour la conception de métamatériaux avec résonateurs à anneau fendu
Résumé
L'introduction des « métamatériaux » a eu un impact profond sur plusieurs domaines, y compris l'électromagnétisme. Concevoir la structure d'un métamatériel sur demande reste cependant un processus extrêmement chronophage. En tant que méthode d'apprentissage automatique efficace, l'apprentissage profond a été largement utilisé pour la classification et la régression de données ces dernières années et a en fait montré de bonnes performances de généralisation. Nous avons construit un réseau de neurones profond pour la conception sur demande. Avec la réflectance requise en entrée, les paramètres de la structure sont automatiquement calculés et ensuite sortis pour atteindre le but de la conception sur demande. Notre réseau a atteint de faibles erreurs quadratiques moyennes (MSE), avec MSE de 0,005 sur les ensembles d'entraînement et de test. Les résultats indiquent qu'en utilisant l'apprentissage profond pour entraîner les données, le modèle entraîné peut guider plus précisément la conception de la structure, accélérant ainsi le processus de conception. Comparé au processus de conception traditionnel, l'utilisation de l'apprentissage profond pour guider la conception de métamatériaux peut atteindre des objectifs plus rapides, plus précis et plus pratiques.
Introduction
La nano-optique est un sujet interdisciplinaire de la nanotechnologie et de l'optique. Ces dernières années, en concevant constamment des structures avec différentes tailles sous-longueur d'onde afin d'atteindre des interactions spéciales avec la lumière incidente, les scientifiques ont réussi à manipuler certaines caractéristiques de transmission de la lumière. Depuis que les métamatériaux ont été proposés, ils ont attiré l'attention de nombreux chercheurs dans ce domaine, et simultanément leurs études théoriques, de processus et appliquées progressent toutes à la même vitesse. De nombreuses fonctions particulières ont été réalisées, y compris l'imagerie holographique, l'absorption parfaite et les lentilles plates. En raison du développement rapide de la technologie térahertz et de ses caractéristiques uniques, elle est également devenue un sujet de recherche populaire dans le domaine des métamatériaux ces dernières années.
Bien que l'application des métamatériaux soit très large, la méthode de conception traditionnelle nécessite que le concepteur effectue répétitivement des calculs numériques complexes sur la structure en cours de conception. Ce processus consomme d'énormes temps et ressources informatiques. Par conséquent, il est urgent de trouver de nouvelles façons de simplifier ou même de remplacer les méthodes de conception traditionnelles.
En tant que domaine interdisciplinaire, l'apprentissage automatique couvre de nombreuses disciplines incluant les sciences de la vie, l'informatique et la psychologie, il a travaillé à utiliser des ordinateurs pour imiter et implémenter les processus d'apprentissage humain pour acquérir de nouvelles connaissances ou compétences. Le principe de base de l'apprentissage automatique peut être simplement décrit comme l'utilisation d'algorithmes informatiques pour obtenir la corrélation parmi une grande quantité de données ou pour prédire les règles parmi des données similaires et finalement atteindre le but de classification ou de régression. Jusqu'à présent, de nombreux algorithmes d'apprentissage automatique ont été appliqués à la désignation de métamatériaux et ont atteint des résultats significatifs, y compris les algorithmes génétiques, les algorithmes de régression linéaire et les réseaux de neurones peu profonds. Au fur et à mesure que la structure devient de plus en plus complexe et que les changements dans la structure deviennent plus divers, les problèmes nécessiteront plus de temps à résoudre. En même temps, la nature hautement non-linéaire des problèmes rend difficile pour les algorithmes d'apprentissage automatique simples d'obtenir des prédictions précises. En outre, pour concevoir une structure de métamatériel correspondante pour un effet électromagnétique spécifique, les concepteurs doivent essayer et effectuer des calculs numériques complexes sur la structure. Ces processus consommeront une quantité énorme de temps et de ressources informatiques.
En tant qu'un des algorithmes les plus remarquables dans le domaine de l'apprentissage automatique, l'apprentissage profond a réalisé des exploits mondialement reconnus dans divers domaines connexes tels que la vision par ordinateur, l'extraction de caractéristiques et le traitement du langage naturel. En même temps, les succès dans d'autres domaines non informatiques sont nombreux, y compris de nombreuses disciplines de base telles que les sciences de la vie, la chimie et la physique. Par conséquent, appliquer l'apprentissage profond à la conception de métamatériaux est aussi une direction de recherche chaude actuellement, et de nombreux travaux exceptionnels sont apparus.
Inspiré par l'apprentissage profond, cet article rapporte une étude utilisant un algorithme d'apprentissage automatique basé sur un réseau de neurones profond pour prédire la structure du résonateur à anneau fendu (SRR) afin d'atteindre le but de la conception sur demande. En outre, le réseau direct et le réseau inverse sont entraînés séparément de manière innovante, ce qui non seulement peut améliorer la précision du réseau, mais aussi peut atteindre différentes fonctions par combinaison flexible. Les résultats montrent que la méthode peut atteindre un MSE de 0,0058 et 0,0055 sur l'ensemble d'entraînement et l'ensemble de validation, respectivement, et affiche une bonne robustesse et généralisation. Avec le modèle entraîné guidant la conception de structures de métamatériaux, le cycle de conception peut être raccourci à des jours voire des heures, et l'amélioration de l'efficacité est évidente. En outre, cette méthode a aussi une bonne évolutivité et n'a besoin que de changer les données de l'ensemble d'entraînement pour concevoir différentes entrées ou différentes structures sur demande.
Théorie et méthode
Construction du modèle COMSOL
Afin de montrer que l'apprentissage profond peut être appliqué à la conception inverse de structures de métamatériaux, nous avons modélisé une structure SRR à trois couches composée d'un anneau d'or, d'un fond de silice et d'un fond d'or pour observer sa réponse électromagnétique sous l'action de la lumière incidente. Comme montré en Fig. 1, l'angle d'ouverture θ de l'anneau d'or, le rayon interne r de l'anneau et la largeur de ligne d de l'anneau sont sélectionnés comme variables indépendantes de cette structure. Lorsqu'un faisceau de lumière polarisée linéairement entre dans les métamatériaux normalement, les courbes longueur d'onde-réflectance sous différentes structures sont obtenues en changeant les variables structurales. L'épaisseur de l'anneau Au est de 30 nm, du fond de SiO₂ est de 100 nm, et du fond d'Au est de 50 nm, et la taille des méta-atomes est de 200 nm par 200 nm.
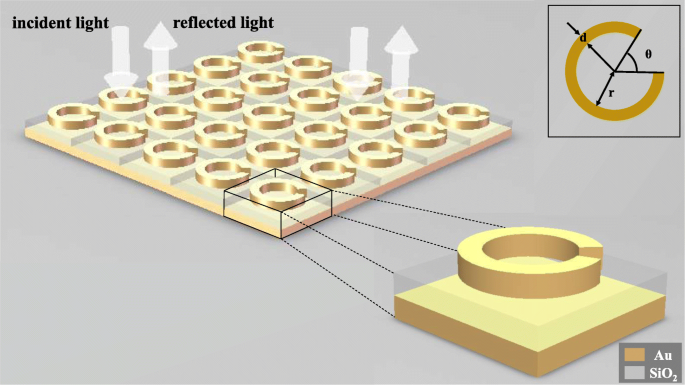
Utilisation de COMSOL Multiphysics 5.4 pour la modélisation, choix de la dimension d'espace tridimensionnelle, choix d'optique ≥ optique des ondes ≥ domaine de fréquence d'onde électromagnétique (ewfd) pour le champ physique et sélection du domaine de longueur d'onde pour la recherche. Création du modèle ci-dessus en géométrie. Le matériau de chaque partie et son indice de réfraction sont définis dans l'ordre dans le matériau, et des ports et conditions périodiques sont ajoutés dans le domaine de fréquence d'onde électromagnétique.
Construction d'un modèle de réseau de neurones d'apprentissage profond
Nous avons construit un réseau inverse et un réseau direct pour la structure de métamatériel. Le réseau inverse peut prédire les paramètres structurels du SRR à partir des deux ensembles de courbes longueur d'onde-réflectance donnés avec différentes directions de polarisation. Le réseau direct peut prédire les courbes longueur d'onde-réflectance dans deux directions de polarisation par les paramètres structurels donnés. La fonction du réseau inverse est le corps principal de la fonction de prédiction. Le rôle du réseau direct est de vérifier les résultats de prédiction du réseau inverse pour observer si les résultats de prédiction répondent à la réponse électromagnétique requise.
Utilisation d'Eclipse 2019 comme plateforme de développement, Python 3.7 comme langage de programmation, et TensorFlow 1.12.0 comme cadre de développement.
Les deux réseaux sont entraînés séparément pour garder les résultats d'entraînement de chaque réseau d'être affectés par l'erreur de l'autre réseau, ce qui assure ainsi la précision respective des deux réseaux.
Comme montré en Fig. 2, un autre avantage de l'entraînement séparé des deux réseaux est qu'ils peuvent être utilisés pour différents buts à travers différentes séquences de connexion : (a) réseau inverse + réseau direct, qui peut utiliser la courbe longueur d'onde-réflectance donnée pour calculer les paramètres de structure, faire des prédictions et vérifier si les résultats de prédiction répondent aux besoins, et (b) utiliser le réseau direct seul peut simplifier le processus de calcul de la méthode de calcul numérique et réduire le temps de calcul.
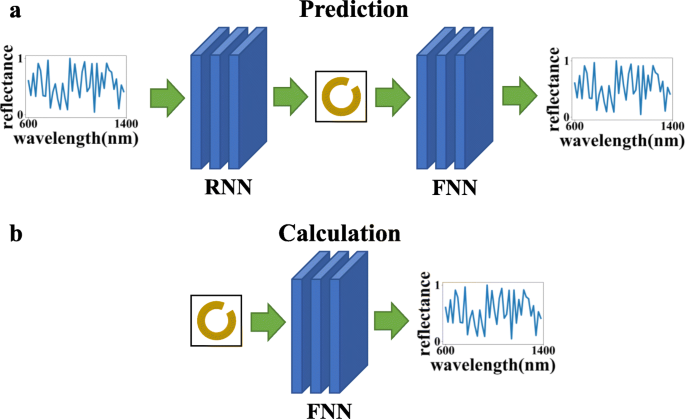
Il convient de noter que le processus d'entrée et d'obtention des résultats du modèle entraîné en utilisant la méthode d'apprentissage profond prend un temps extrêmement court. Et chaque fois que de nouvelles données sont obtenues par simulation ou expérience, le modèle peut être utilisé pour un entraînement supplémentaire. Des études ont montré qu'avec l'augmentation continue des données d'entraînement, la précision du modèle deviendra de plus en plus élevée, et la performance de généralisation meilleure et meilleure.
Les paramètres de la structure sont plusieurs ensembles de valeurs propres continues, qui appartiennent au problème de régression. Ces dernières années, les réseaux entièrement connectés ont été le point focal des réseaux d'apprentissage profond sur les problèmes de régression et ont montré les caractéristiques de haute fiabilité, grand débit de données et faible latence. Faire quelques ajustements sur un réseau entièrement connecté permettra au réseau de mieux prédire la structure.
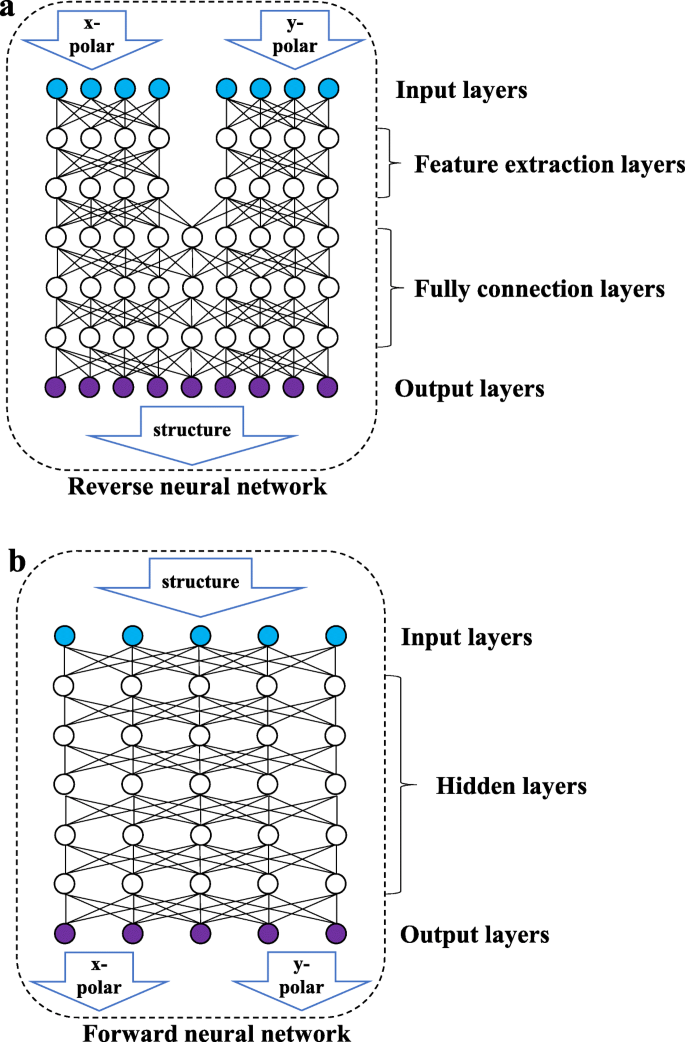
Comme montré en Fig. 3b, le réseau direct est un réseau entièrement connecté dans lequel tous les nœuds de deux couches adjacentes sont connectés les uns aux autres. Les données d'entrée sont le paramètre structurel, et la sortie est la courbe longueur d'onde-réflectance des deux directions de polarisation. Comme montré en Fig. 3a, le réseau inverse se compose d'une couche d'extraction de caractéristiques (couche FE) et d'une couche entièrement connectée (couche FC). La couche FE inclut deux ensembles de réseaux entièrement connectés qui ne sont pas connectés entre eux et traitent les courbes longueur d'onde-réflectance de la lumière polarisée linéairement dans les deux directions pour extraire certaines caractéristiques des données d'entrée. La couche FC apprendra les caractéristiques extraites et sortira les paramètres structurels. En raison des caractéristiques de haute cohésion et faible couplage entre les courbes longueur d'onde-réflectance dans différents états de polarisation, séparer les entrées de deux ensembles de données de lumière polarisée dans différentes directions peut empêcher le réseau d'être perturbé par la standardisation des données pendant le processus d'extraction de données. Le réseau direct ne fait pas intervenir plusieurs ensembles d'entrées et n'a pas besoin de considérer l'interférence mutuelle entre les données, donc il n'a pas de couche d'extraction de caractéristiques.
Afin de déterminer la structure de réseau optimale, des réseaux de différentes structures sont entraînés en utilisant le même ensemble de données. Comme montré en Fig. 4, après que les données ont connu 50 époques (quand toutes les données ont subi un entraînement complet, on appelle cela une époque), le MSE atteint par le réseau direct de différentes structures. Comme on peut le voir sur l'image de gauche de Fig. 4, lorsque le réseau direct contient 5 couches cachées, chaque couche contenant 100 nœuds, le MSE le plus bas atteint est d'environ 0,0174, donc le réseau direct de cette structure sera sélectionné.
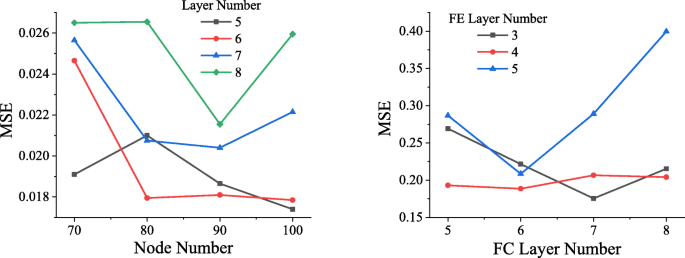
De même, différents réseaux de réseaux inverses ont été entraînés, et le volume d'entraînement était toujours réglé à 50 époques. Le résultat est montré dans la figure de droite de Fig. 4. Lorsque le nombre de couches FC est 7 et le nombre de couches FE est 3, le réseau atteint le MSE le plus bas, qui est d'environ 0,1756.
Nous avons trouvé qu'un plus grand nombre de couches de réseau produira un phénomène d'explosion de gradient, ce qui causera l'échec de convergence du réseau, et la perte est infinie, donc il n'est pas listé dans la figure.
Prétraitement des données
Afin d'entraîner un réseau direct plus fiable, les données de réflectance sont re-divisées, et elles sont assemblées avec la réfractivité de l'Au et du SiO₂ correspondant à chaque fréquence. Les données collatées sont ensuite normalisées et entrées dans le réseau direct, ce qui peut grandement améliorer la précision du réseau direct.
Afin d'assurer que les données avec des valeurs plus grandes n'auront pas un impact plus élevé sur le réseau que les données avec des valeurs plus petites, les données d'entrée doivent être normalisées pour faire en sorte que chaque colonne de données soit conforme à la distribution normale standard (la valeur moyenne est 0, la variance est 1), et alors les données traitées x peuvent être exprimées comme suit :
x = (x₀ - μ) / σ
Dans l'expression, x₀ est les données originales de l'échantillon, μ la moyenne de l'échantillon, et σ l'écart-type de l'échantillon. Si les données d'entrée ne sont pas re-divisées, la réflectance sera déformée après normalisation, ce qui réduira la précision du réseau. Les données re-divisées n'affecteront pas leur distribution en raison de la normalisation.
Méthode de réseau de neurones
Le principe du réseau de neurones est de construire beaucoup de neurones (nœuds) en imitant la façon dont le cerveau humain fonctionne et apprend. Les neurones sont connectés entre eux, et la sortie est ajustée en ajustant le poids de connexion. La sortie du nœud j-ième d'une couche peut être exprimée comme suit :
yⱼ = Σᵢ₌₁ⁿ f(wᵢxᵢ + bⱼ) / n
f est la fonction d'activation, wᵢ est le poids de connexion du nœud i-ième de la couche précédente connecté au nœud j-ième, xᵢ est la sortie du nœud i-ième de la couche précédente, bⱼ est le terme de biais de ce nœud, et n est le nombre de nœuds dans la couche précédente connectés au nœud j-ième.
Choix d'une fonction d'activation
Afin de répondre à la haute non-linéarité du problème inverse, la fonction ELU [28] est utilisée comme fonction d'activation de chaque couche de neurones. La sortie f(x) de la fonction ELU peut être exprimée sous forme par morceaux comme suit :
f(x) = { x pour x ≥ 0
α(eˣ - 1) pour x < 0 }
Dans cette fonction, x est l'entrée originale, et la valeur du paramètre pour α varie de 0 à 1.
La raison d'utiliser la fonction d'activation est que la fonction d'activation change la capacité d'expression non-linéaire de chaque couche du réseau, améliorant ainsi la capacité globale d'ajustement non-linéaire du réseau. Comme montré en Fig. 5, la fonction ELU combine les avantages des fonctions d'activation Sigmoid et unité linéaire rectifiée (ReLU). Quand x < 0, elle a une meilleure saturation douce, ce qui rend le réseau plus robuste aux changements d'entrée et au bruit. Quand x > 0, il n'y a pas de saturation, ce qui est utile pour atténuer la disparition du gradient du réseau. La caractéristique que la valeur moyenne de ELU est proche de 1 peut rendre le réseau plus facile à ajuster. Le résultat prouve qu'en utilisant ELU comme fonction d'activation du réseau de neurones d'apprentissage profond, la robustesse du réseau est significativement améliorée.
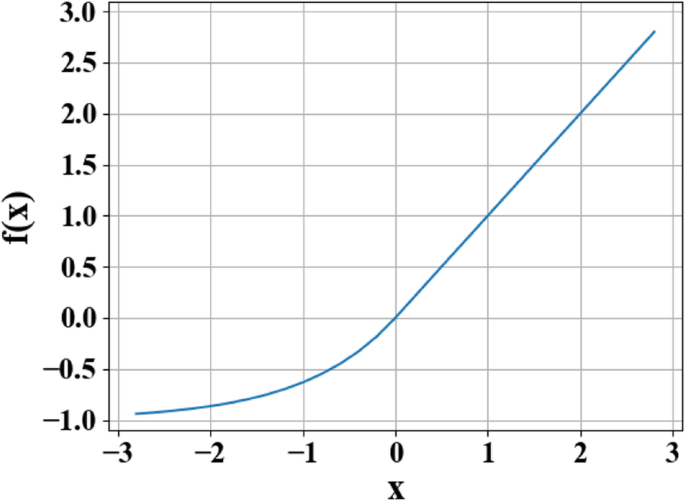
Schéma d'initialisation des poids
La méthode d'initialisation du poids du réseau de chaque couche détermine la vitesse d'ajustement du réseau et même détermine si le réseau peut s'ajuster ou non. L'initialisation par mise à l'échelle de la variance est basée sur la quantité de données d'entrée à chaque couche et extrait les poids d'une distribution normale tronquée centrée sur 0, de sorte que la variance peut être réduite à une certaine plage, alors les données peuvent être propagées plus profondément à travers le réseau. Sur cette structure de réseau, l'utilisation de l'initialisation par mise à l'échelle de la variance peut rendre la vitesse de convergence du réseau significativement plus rapide.
Solution au surapprentissage
En raison de données insuffisantes, le réseau produira du surapprentissage. Avec un surapprentissage réduit, le réseau peut avoir une bonne performance de généralisation sur des données en dehors de l'ensemble d'entraînement. La régularisation L2 (aussi appelée décroissance de poids dans les problèmes de régression) est utilisée pour traiter le poids w. La sortie régularisée L peut être exprimée comme suit :
L = L₀ + (λ / 2n) Σ w²
Dans l'Éq. (4), L₀ représente la fonction de perte originale, et un terme de régularisation (λ / 2n) Σ w² est ajouté sur cette base, où λ représente le coefficient de régularisation, n le débit de données, et w le poids. Après l'ajout du terme de régularisation, la valeur du poids w tend à diminuer globalement, et l'occurrence de valeurs excessives peut être évitée, donc w est aussi appelé atténuation de poids. La régularisation L2 peut réduire le poids pour éviter une grande pente de la courbe ajustée, atténuant ainsi efficacement le phénomène de surapprentissage du réseau et aidant à converger.
Sur cette base, la méthode dropout est aussi utilisée. Cette méthode peut être visuellement considérée comme « cacher » une certaine échelle de nœuds de réseau pour chaque entraînement, et cacher différents nœuds pendant chaque entraînement, pour atteindre l'objectif d'entraîner plusieurs « réseaux partiels ». Et à travers l'entraînement, la plupart des « réseaux partiels » peuvent représenter avec précision les cibles, et les résultats de tous les « réseaux partiels » peuvent être triés pour obtenir la solution des cibles.
L'utilisation des méthodes de régularisation L2 et dropout mentionnées ci-dessus peut non seulement atténuer efficacement la faible généralisation causée par des données insuffisantes, mais aussi réduire l'impact d'une petite quantité de données erronées dans l'ensemble de données sur les résultats d'entraînement.
Sur cette structure de réseau et ensemble de données, avec dropout = 0,2 et coefficient de régularisation L2 λ = 0,0001, le réseau peut obtenir une précision similaire sur l'ensemble d'entraînement et l'ensemble de test, atteignant ainsi une haute performance de généralisation.
Résultat et discussion
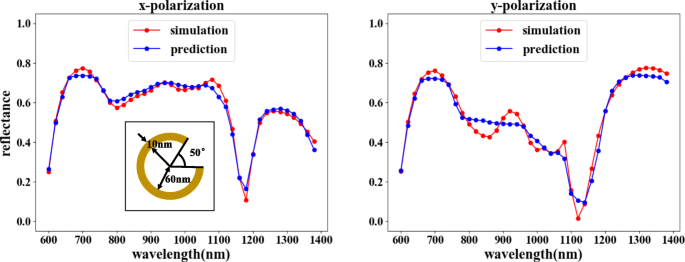
Après l'entraînement, notre réseau direct peut atteindre un haut degré d'ajustement, avec un MSE de 0,0015, ce qui montre que la sortie est très similaire aux résultats de simulation, comme montré en Fig. 6. Cela assure aussi que lors de l'entraînement du réseau inverse, les résultats du réseau inverse peuvent être vérifiés de manière fiable.
Finalement, nous allons générer deux modèles à partir du réseau appris et connecter les deux modèles pour atteindre la fonction de prédiction.
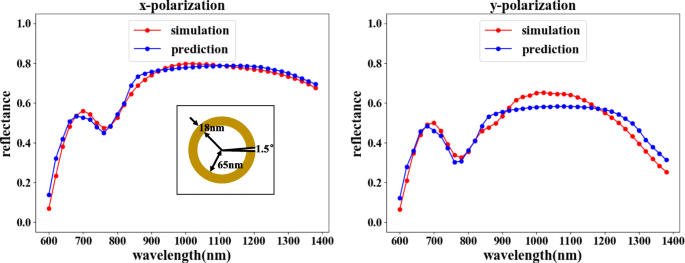
La fonction de prédiction peut choisir la combinaison montrée en Fig. 2a. Le réseau inverse prédit la structure correspondante selon la courbe longueur d'onde-réflectance requise, et le réseau direct vérifie la réponse optique de la structure. Comme montré en Fig. 7, en comparant la réflectance vérifiée à la réflectance d'entrée, les caractéristiques de réflectance de la lumière incidente dans les deux directions de polarisation sont fondamentalement cohérentes. Bien que des désaccords de réflectance mineurs soient observables pour certaines valeurs de longueur d'onde, la tendance de correspondance globale est clairement irréfutable, puisque les erreurs sont bien dans une plage acceptable.
Conclusion
Dans cet article, nous avons présenté notre réseau d'apprentissage profond conçu, capable de créer divers effets en employant des combinaisons flexibles de configurations de réseau. Notre réseau inverse conçu peut prédire la structure requise en utilisant la courbe longueur d'onde-réfractive d'entrée, ce qui peut grandement réduire le temps requis pour résoudre le problème inverse et répondre à différents besoins en utilisant des combinaisons flexibles. Les résultats indiquent que le réseau a atteint une précision plus élevée dans les prédictions, ce qui implique davantage que la conception sur demande peut être résolue par notre méthode. L'utilisation de l'apprentissage profond pour guider la conception de métamatériaux peut obtenir automatiquement des structures de métamatériaux plus précises, un résultat inatteignable par les méthodes de conception traditionnelles.
Disponibilité des données et matériaux
Les données du manuscrit proviennent de notre réseau de simulation, et nous ne pouvons pas les partager pour des raisons personnelles.
Abréviations
- ELU :
- Unités linéaires exponentielles (Exponential linear units)
- Couche FC :
- Couche entièrement connectée (Fully connected layer)
- Couche FE :
- Couche d'extraction de caractéristiques (Feature extraction layer)
- FNN :
- Réseau de neurones direct (Forward neural network)
- MSE :
- Erreurs quadratiques moyennes (Mean square errors)
- ReLU :
- Unité linéaire rectifiée (Rectified linear unit)
- RNN :
- Réseau de neurones inverse (Reverse neural network)
- SRR :
- Résonateur à anneau fendu (Split-ring resonator)
Nanomatériaux
- Accélérer le Deep Learning avec les FPGA : vitesse, flexibilité et efficacité énergétique
- TI dévoile son premier SoC automobile avec accélérateur IA dédié
- Créer un Reconnaissance de Chiffres sur Raspberry Pi avec TensorFlow et OpenCV
- Robot mobile évitant les obstacles par vision sur Raspberry Pi
- Améliorer la fiabilité des actifs : exploiter le machine learning pour une performance proactive
- Neurones artificiels à changement de phase d'IBM imitent les pointes cérébrales pour un calcul ultra-dense, basse consommation
- Wireless Network Devices et Sigfox déploient un réseau IoT national au Royaume-Uni
- Maîtriser la Méthode split() de Java : Guide Pratique avec Exemples de Code
- Prévision précise de la durée de vie des batteries par IA – Étude DOE Argonne