



La Data Science dévoilée : Concepts clés, types et opportunités de carrière
Qu'est-ce que la Data Science ?
La Data Science est un domaine interdisciplinaire impliquant l'utilisation de méthodes scientifiques, de processus et de systèmes pour collecter, préparer et analyser des données sous forme structurée et non structurée. La data science mobilise divers domaines : mathématiques, statistiques, bases de données, sciences de l'information et informatique. Les données peuvent être de nombreux types et de tailles variées.
Besoin de la Data Science comme domaine à part entière :
La raison principale de l'émergence de la data science comme domaine distinct est la croissance exponentielle du volume de données autour de nous. Les estimations montrent qu'environ 1,7 Mo de données seront produites par seconde d'ici 2020. L'accumulation de données numériques atteindra 44 000 milliards de gigaoctets. Face à de telles quantités, donner du sens aux données et les stocker devient de plus en plus difficile. Nous avons donc besoin d'un moyen d'étudier et de comprendre ces données. C'est ainsi que la Data Science a été reconnue comme un domaine à part entière. 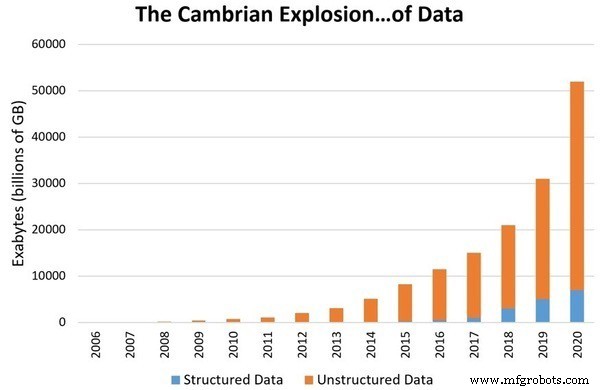
La Data Science autour de nous :
Les entreprises utilisent la data science pour comprendre et trier facilement leurs processus de données. Par exemple, Google utilise la Data Science pour personnaliser les publicités affichées aux utilisateurs sur les sites qu'ils visitent, via leur programme AdSense qui permet aux éditeurs de diffuser du contenu auprès d'audiences ciblées.
De même, Uber calcule le tarif client, quand accorder des réductions et à qui. Airbnb aide les gens à estimer le prix de location de leur logement grâce à la Data Science. En termes simples, on peut voir les clients et utilisateurs comme des données brutes que la data science aide à interpréter. 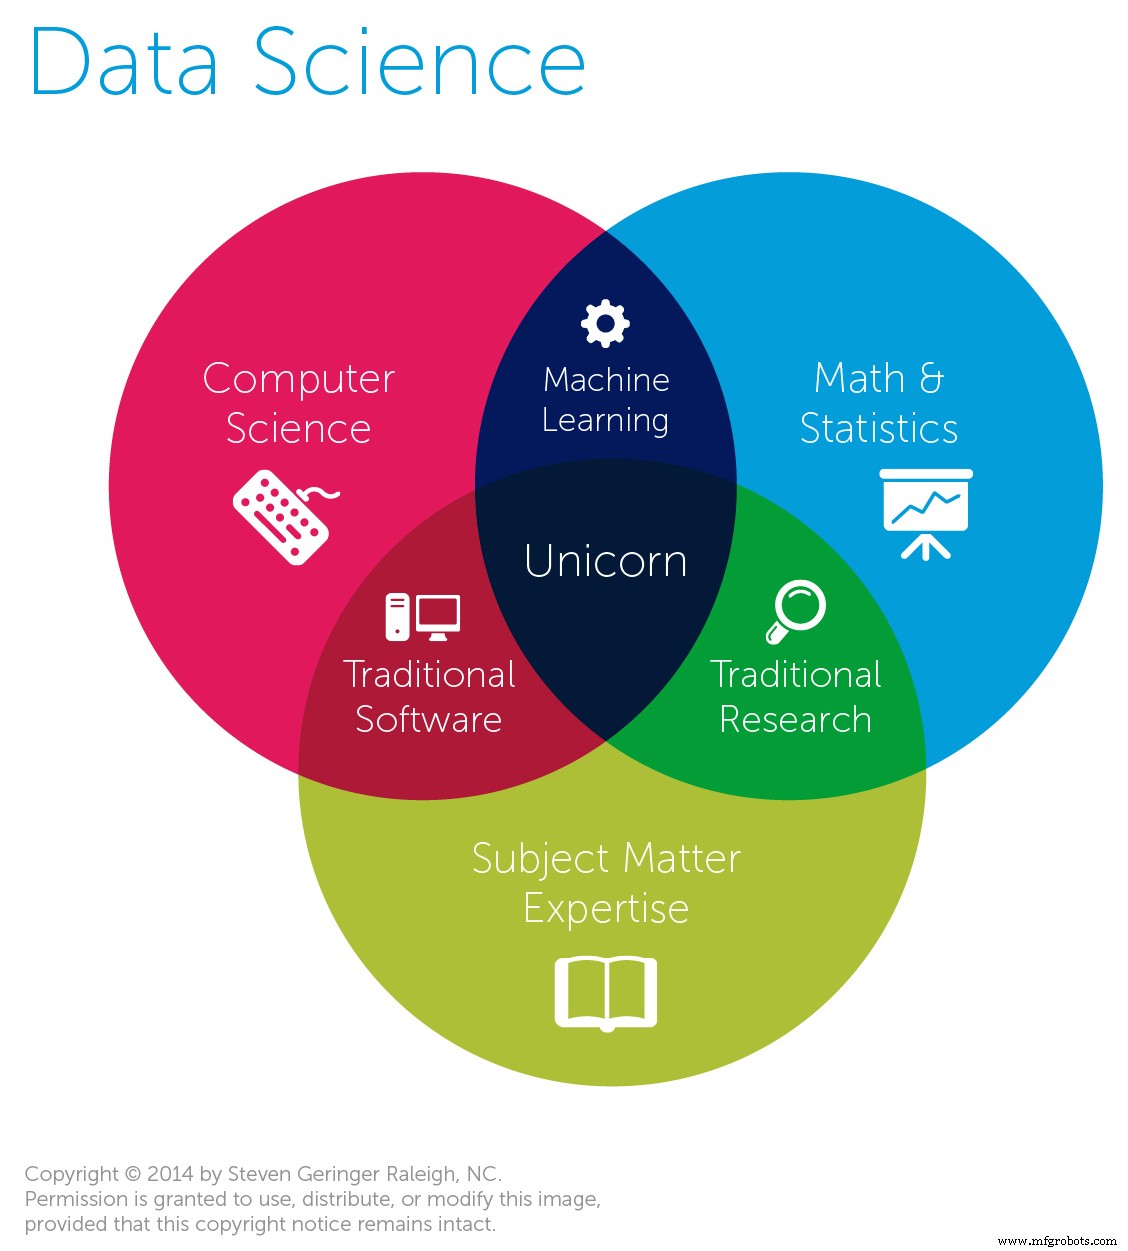
Data Science dans les organisations gouvernementales et non-gouvernementales :
Les données sont un actif critique pour les organisations gouvernementales. La quantité de données collectées chaque jour augmente. Elles ont donc besoin d'un moyen de trier et stocker toutes ces données, ce qui peut se faire via la Data Science. De même, les ONG utilisent aussi la data science. Le WWF utilise les sciences des données pour présenter des informations statistiques sur les enjeux de la faune et rendre leur cause plus efficace.
Opportunités en Data Science :
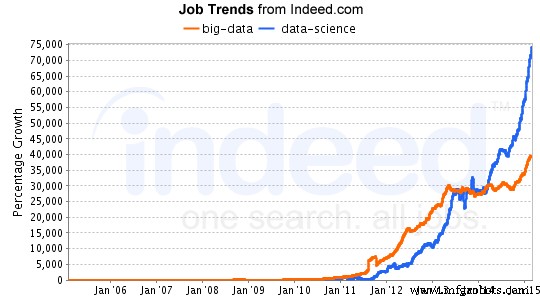
Alors que le domaine continue de croître, les opportunités d'emploi augmentent exponentiellement. Une analyse de LinkedIn sur la croissance des emplois en data science a montré une forte augmentation, surtout ces 30 dernières années. Si vous êtes intéressé, vous pouvez suivre des cours gratuits en ligne. Consultez ce tutoriel sur Common Lounge.
Composants clés :
Voici un aperçu de la data science et de ses composants.
1 : Programmation :
La Data Science tourne autour des données. Pour les organiser et les analyser, nous utilisons la programmation. Les deux langages les plus répandus sont Python et R.
Python : Python est le langage le plus lisible et flexible, d'où son usage étendu. Il dispose de nombreux packages statistiques et numériques puissants : NumPy, pandas, Matplotlib, TensorFlow, iPython, etc. Python est plus rapide et plus facile à apprendre.
R : R est un autre langage axé sur les techniques statistiques et graphiques. Il est largement utilisé par les statisticiens et data miners pour développer des logiciels statistiques et analyser des données. C'est un langage open source.
2 : Les données et leurs types :
Le composant suivant est la donnée elle-même. Pour la comprendre, il faut d'abord connaître ses types.
Données structurées : Informations hautement organisées, facilement représentables sous forme tabulaire, stockables et traitables en bases de données.
Données non structurées : Informations sans modèle de données ni organisation. Elles peuvent consister en texte, dates, nombres, emails, fichiers PDF, images, vidéos, etc.
Langage naturel : Données sous forme de langues écrites pour communiquer (anglais, espagnol, ourdou, etc.). Considéré comme un sous-type de données non structurées.
Image, Vidéo, Audio : Images, vidéos et audios sont aussi non structurés. Générés par caméras et micros. L'usage croissant se voit dans les smartphones où images et vidéos sont sauvegardées et traitées quotidiennement.
Données basées sur les graphes : Un graphe est un ensemble de sommets et d'arêtes. Structure mathématique montrant la relation entre deux entités.
Données générées par machine : Données créées par systèmes informatiques, applications ou machines sans intervention humaine.
3 : Statistiques, Probabilités et leur relation à la Data Science :
Statistiques : Branche des mathématiques traitant de la collecte, l'interprétation, l'analyse, la présentation et l'organisation des données. Elle utilise la programmation pour analyser les données.
Probabilités : Mesure de la vraisemblance d'un événement. Quantifiée entre 0 (impossible) et 1 (certain).
Relation à la Data Science : Statistiques et probabilités sont les fondations du traitement et de l'analyse des données. On les utilise conjointement avec la data science pour interpréter correctement les données.
4 : Machine Learning :
Le Machine Learning est un domaine de l'informatique issu de l'IA. Il utilise des techniques statistiques pour donner aux ordinateurs la capacité d'apprendre sans être explicitement programmés. La machine améliore progressivement sa performance sur une tâche spécifique en modifiant sa structure ou son programme. Trois objectifs principaux : apprendre les changements et leur représentation, généraliser la performance pour des tâches similaires, améliorer la performance et prévenir sa dégradation. En data science, le ML est utilisé dans les algorithmes, la régression et la classification pour prédire des résultats à partir de données traitées différemment.
5 : Big Data :
Le Big Data désigne des données en telle quantité que leur stockage ou traitement nécessite un grand nombre d'ordinateurs. Il se caractérise par trois V :
Volume : Données en volumes massifs, de téraoctets à zettaoctets.
Variété : Grande diversité, mélange de deux ou plusieurs types de données (ex: structurées et non structurées).
Vélocité : Données générées à un rythme constamment croissant. C'est la vitesse des données. 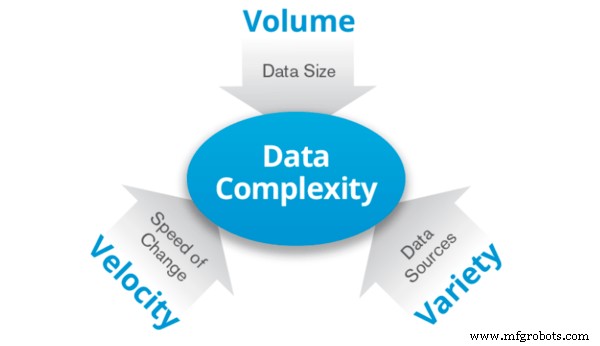
En data science, les données sont regroupées sous nombreuses formes. Le Big Data désigne des volumes énormes impossibles à traiter par des applications traditionnelles. Les data scientists utilisent différents outils : Hadoop, Spark, R, Java, etc.
Technologie industrielle
- Maîtriser les variables C# et types de données primitifs : guide complet
- Maîtriser les types de données Python : Guide pratique
- Edge Computing démystifié : cas d'usage pratiques dans transport, utilities et manufacturing
- 5 Modèles de Centres de Données Expliqués : Conception, Cas d'Usage et Exemples
- Comprendre les types de données en C : Guide complet
- Types de données MATLAB : Guide complet
- Guide complet des types de données C# : Valeur, Référence et Pointeur
- Procédés d'usinage essentiels : Tournage, Fraisage, Perçage, Dressage
- Machines de fraisage : types, fonctions et applications dans la fabrication CNC