



AImotive lance l'accélérateur de réseau neuronal aiWare3P pour vision automobile haute performance
Basée en Hongrie, AImotive, leader des solutions IA automobiles, a commencé à livrer son moteur d'inférence de réseau neuronal (NN) aiWare3P en propriété intellectuelle (IP) à des clients clés. Le cœur aiWare3P, annoncé l'an dernier, délivre un accélérateur dédié pour la vision automobile haute résolution et est entièrement conforme aux exigences de certification ISO26262 ASIL A, B et supérieures.
L'IP est disponible comme bloc RTL entièrement synthétisable intégrable dans un system-on-chip (SoC) ou déployable comme accélérateur autonome. Sa microarchitecture bas niveau consomme bien moins de ressources CPU hôte et mémoire partagée que les solutions GPU ou SoC concurrentes, permettant une latence plus faible et un déterminisme plus élevé pour les charges de travail automobiles réelles.
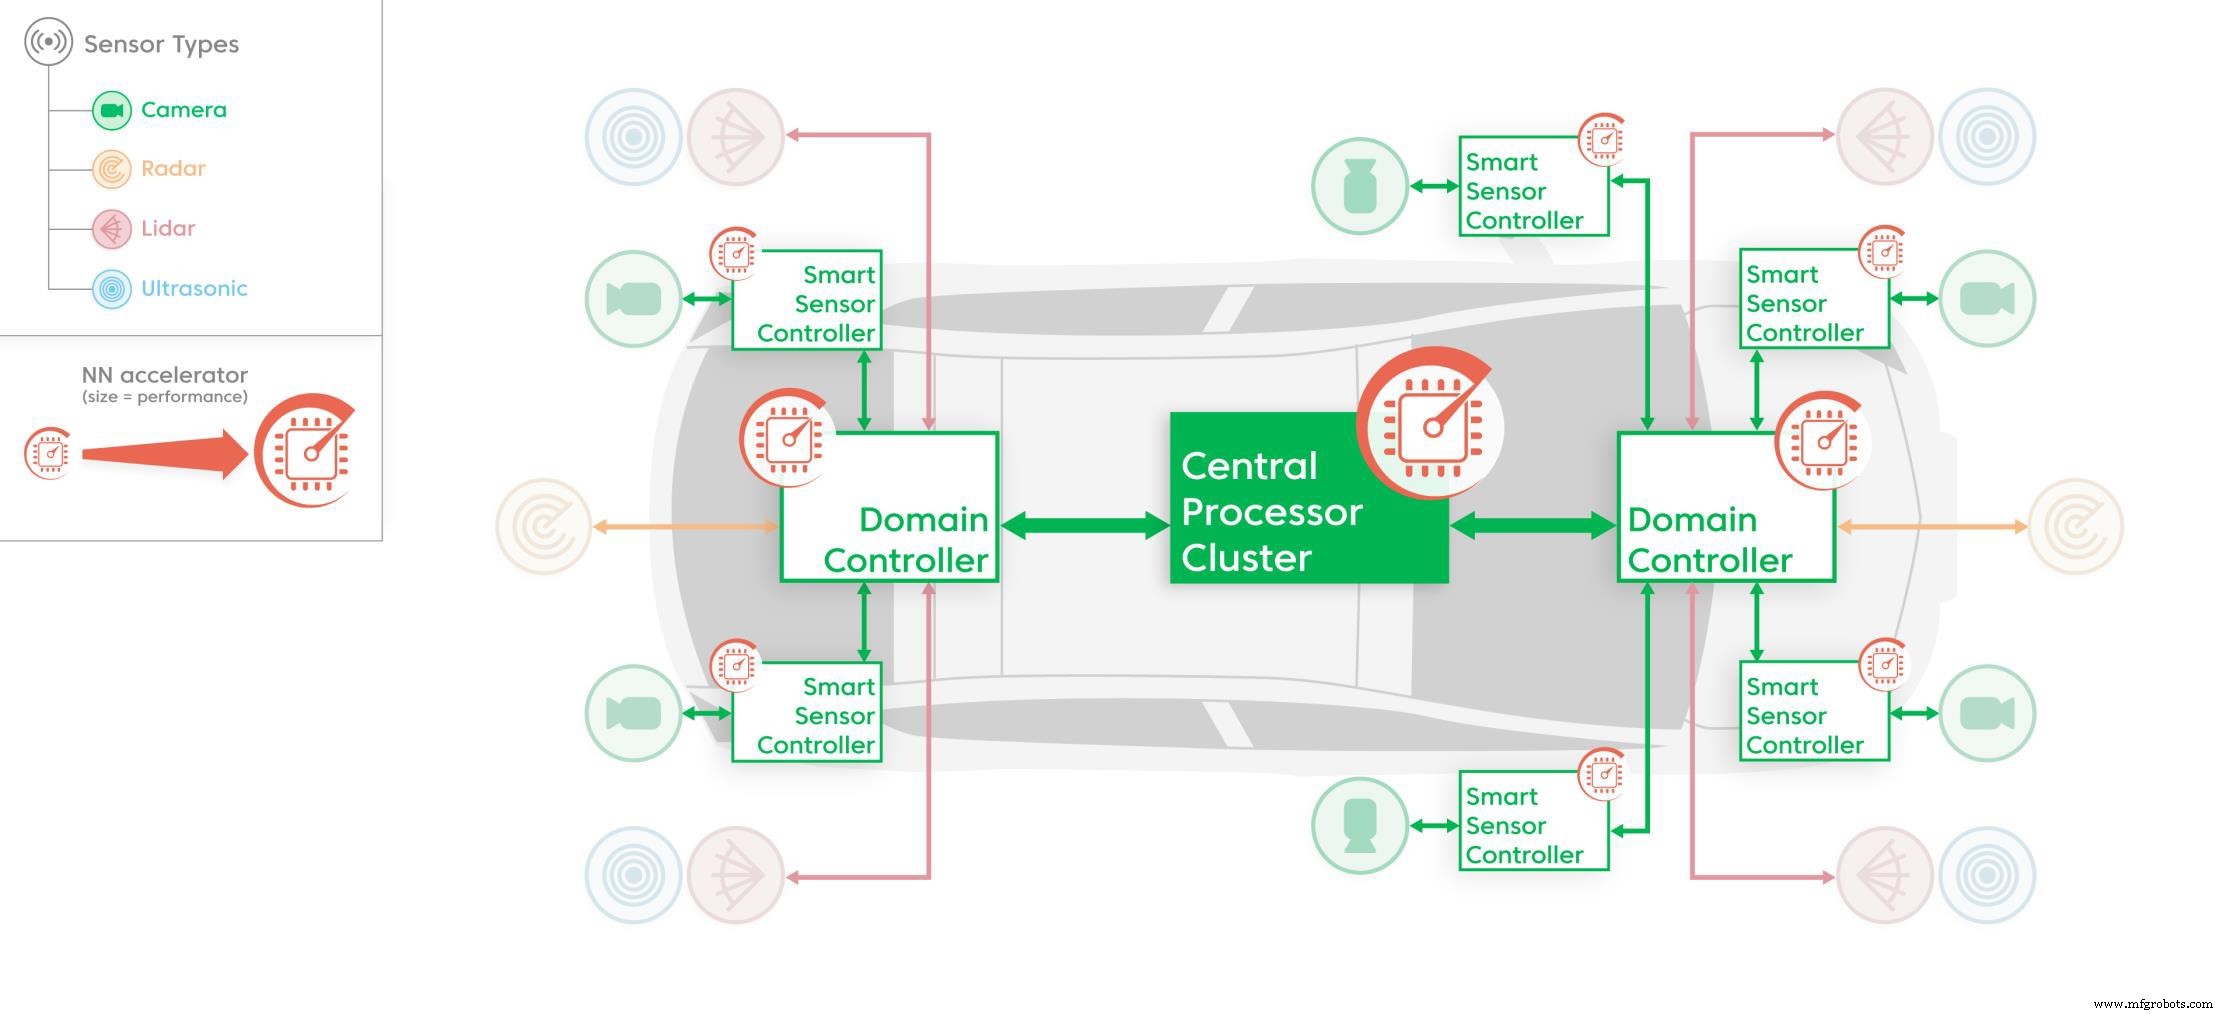 Accélérateurs NN dédiés comme l'IP aiWare3P utilisés dans diverses parties de la plateforme électronique véhicule (Source : AImotive)
« La plupart des fournisseurs de puces discutent accélérateurs en termes académiques qui ne se traduisent pas en production », explique Tony-King Smith, conseiller exécutif d'AImotive. « Notre design élimine les DSP et la complexité du network-on-chip (NoC), se concentrant uniquement sur l'inférence automobile. Cela nous donne une latence ultra-faible de l'entrée à la sortie et libère le CPU hôte pour d'autres tâches. »
Le cœur aiWare3P délivre jusqu'à 16 TMAC/s (>32 TOPS) par cœur à 2 GHz, avec configurations multi-cœur et multi-puces atteignant 50+ TMAC/s (>100 INT8 TOPS). Ces chiffres supportent les plateformes multi-caméras et capteurs hétérogènes communes en conduite autonome L2, L2+ et L3.
Conçu selon spécifications AEC-Q100 température étendue, le cœur inclut des fonctionnalités facilitant la certification ASIL-B et supérieure. Son design breveté ground-up délivre une gestion de flux de données hautement déterministe et jusqu'à 100x plus de bande passante mémoire sur puce que d'autres accélérateurs, atteignant 95% d'efficacité soutenue sur réseaux de neurones profonds (DNN) complexes avec entrées HD larges.
Le SDK aiWare prend en charge les formats Khronos NNEF et ONNX, compilant des binaires directement sans programmation DSP ou MCU bas niveau. Il offre une quantification automatisée FP32-vers-INT8 avec perte de précision minimale et une suite d'outils d'analyse de performance DNN, permettant aux ingénieurs de transitionner les modèles entraînés en lab vers du matériel automobile de production sans heurt.
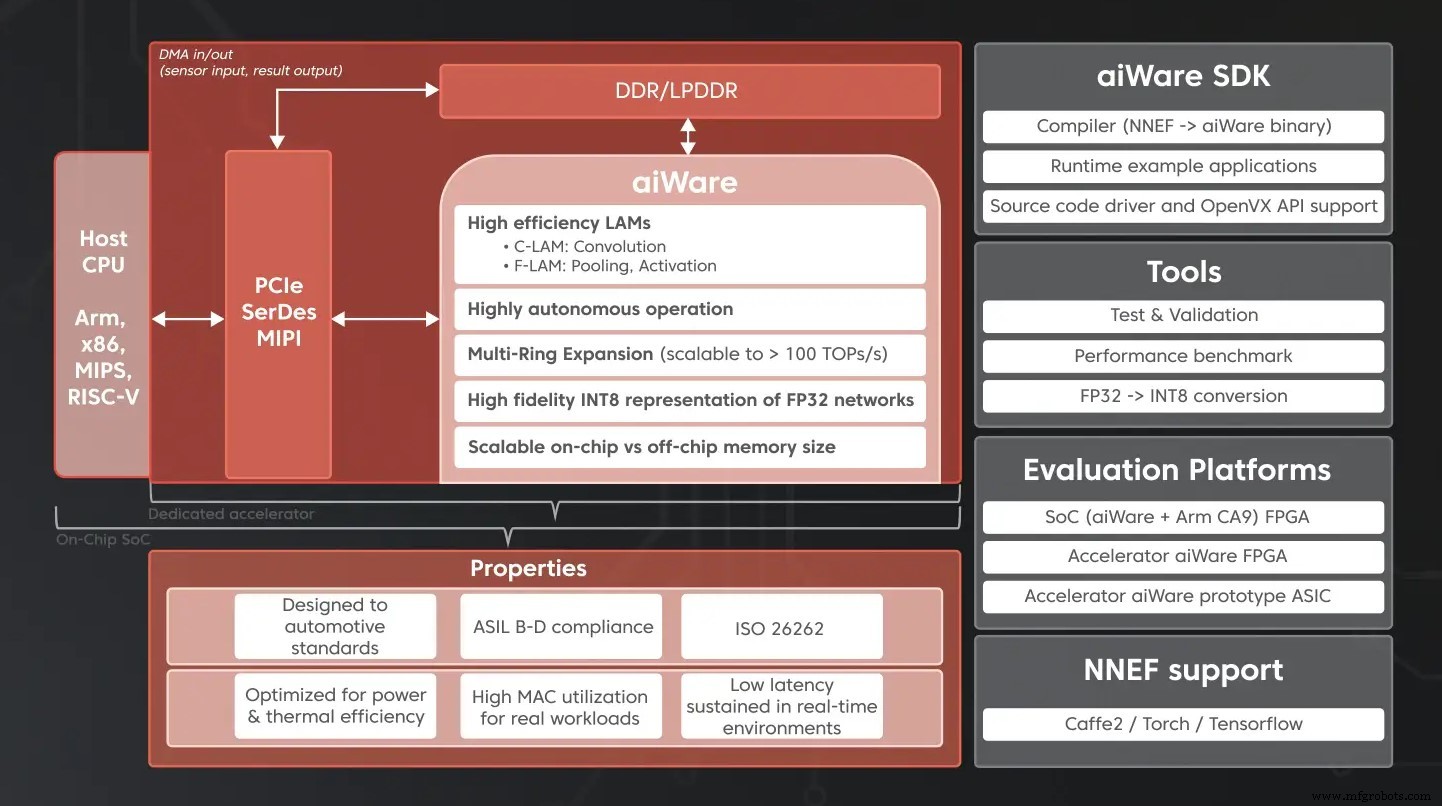 Les blocs de construction d'un accélérateur IA automobile, incluant l'IP matériel aiWare (Source : AImotive)
Le VP Senior Ingénierie Matérielle Marton Feher déclare : « aiWare3P unit tout ce qu'on a appris sur l'accélération de réseaux de neurones pour l'IA automobile vision. C'est maintenant l'une des solutions les plus efficaces de l'industrie pour la production de masse d'IA L2/L2+/L3. »
Les clients déploient déjà aiWare3P en plateformes de production L2/L2+ et explorent la fusion de capteurs hétérogènes avancée. Partenaires notables incluent Nextchip, qui intègre le cœur dans son Apache5 Imaging Edge Processor, et ON Semiconductor, collaborant sur une démonstration conjointe de capacités de fusion de capteurs.
AImotive publiera des résultats de benchmark mis à jour au T1 2020, insistant sur des entrées caméra haute résolution réalistes plutôt que tests synthétiques 224×224, soulignant son engagement pour des données de performance transparentes, centrées application.
Aucune intervention CPU hôte requise
De nouvelles fonctionnalités supportent un portefeuille plus large de fonctions d'activation et de pooling pré-optimisées embarquées, permettant à 100% de la plupart des NN de s'exécuter entièrement dans le cœur aiWare3P. La compression de données temps-réel réduit les besoins en bande passante mémoire externe, et le couplage croisé entre moteurs de convolution C-LAM et moteurs de fonction F-LAM améliore l'efficacité d'exécution entrelacée et chevauchée.
La microarchitecture à base de tuiles simplifie l'implémentation physique sur tout nœud de processus en assouplissant les contraintes de timing. La gestion de données logique à base de tuiles échelonne les charges de travail au maximum de 16 TMAC/s du cœur sans caches, NoCs, ou autres approches multi-cœurs gourmandes en énergie qui entravent typiquement le déterminisme et la surface silicium.
Le RTL pour aiWare3P sera disponible pour tous clients dès janvier 2020, accompagné d'un SDK mis à jour avec compilateurs améliorés et outils d'analyse matérielle temps-réel à grain fin.
Embarqué
- Infineon Présente la Série TLE985x Embedded Power pour Contrôle Moteur Automobile
- Blaize dévoile son processeur Graph Streaming Processor (GSP) pour charges de travail IA
- Comment les accélérateurs matériels alimentent les systèmes IA modernes
- Melexis lance un capteur Hall ASIL‑ready pour systèmes automobiles critiques
- Arbève le premier processeur radar d'imagerie 4D 30 ips de grade automobile
- EKF SRS-1201-BLUBRICK : boîtier mural robuste pour CPU CompactPCI Serial en ferroviaire, automobile et industriel
- Révolutionner le design automobile avec la technologie fibre de carbone
- Edgetek PPA renforcé : composés thermostables, faible absorption humidité pour durabilité auto
- SGL Carbon : technologies composites avancées auto & aéro au JEC World 2020